資料庫索引是資料庫管理系統中用於加速查詢與更新的核心機制,本質上是一種經過排序的資料結構。主流資料庫系統(如MySQL的InnoDB引擎)普遍採用B樹及其變體B+樹作為索引的底層實現。理解索引原理,不僅有助於SQL優化,更能讓開發者在架構設計時做出更明智的決策。
除了資料本身,資料庫系統還維護著滿足特定查找演算法的資料結構——索引。它們透過指標引用實際資料,使得高級查找演算法得以在索引層面執行。然而,建立索引並非零成本:一是佔用額外儲存空間,二是資料異動(INSERT/UPDATE/DELETE)時需同步維護索引,增加寫入開銷。
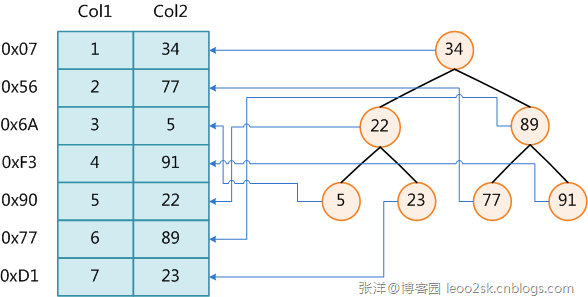
上圖示範一種索引方式:左側為資料表(兩欄七筆),最左欄為物理地址(邏輯相鄰不代表物理相鄰)。為加速Col2查找,右側維護一棵二元搜尋樹,節點包含索引鍵值與指向資料物理地址的指標,查找複雜度降為O(log₂n)。
索引的三大劣勢:
磁碟存取速度遠慢於主存(數百分之一),機械尋道是主要瓶頸。為減少I/O,作業系統採用「預讀」機制:每次讀取一頁(通常4KB)或其整數倍。理論依據是局部性原理——當某資料被訪問,其鄰近資料大概率很快被用到。順序讀取無需尋道,僅需極少旋轉延遲,效率極高。
資料庫系統巧妙利用此特性:將B樹節點大小設定為一頁,使單節點載入僅需一次I/O。實現技巧:新建節點時直接申請一頁空間,配合頁對齊分配,確保節點物理連續。
B樹檢索最多訪問h個節點(h為樹高),根節點常駐內存,故最多h-1次I/O,複雜度O(logdN)。實際應用中出度d極大(通常>100),樹高h極小(≤3),效能極高。紅黑樹雖同為O(h),但邏輯鄰近節點物理可能離散,無法利用局部性,I/O效率遠遜於B樹。
| 特性 | B樹 | B+樹 |
|---|---|---|
| 節點內容 | 鍵值+資料指標 | 非葉節點僅存鍵值(純索引),葉節點存所有鍵值+資料指標 |
| 葉節點連結 | 無 | 雙向鏈表串聯,支援範圍掃描 |
| 查找路徑 | 可能在非葉節點命中 | 必走至葉節點,路徑長度固定 |
| 插入/刪除 | 可能在內部節點,操作複雜 | 僅在葉節點進行,維護較簡單 |
| 空間利用 | 鍵值不重複,節省空間 | 非葉節點冗餘鍵值,空間換取穩定效能 |
B+樹透過「冗餘換穩定」的設計,成為關係型資料庫索引的主流選擇。
建議:深入學習B樹與B+樹資料結構,是掌握資料庫核心技術的必修課。