面對 MySQL 性能問題,盲目調參往往事倍功半。本文建立系統化診斷框架:從現象觀測、根因定位、針對性優化到架構演進,提供完整實戰方法論。
SHOW FULL PROCESSLISTmysql> SHOW FULL PROCESSLIST;
+----+------+-----------+------+---------+------+-----------+------------------+
| Id | User | Host | db | Command | Time | State | Info |
+----+------+-----------+------+---------+------+-----------+------------------+
| 12 | root | localhost | test | Query | 15 | Sending | SELECT * FROM... |
+----+------+-----------+------+---------+------+-----------+------------------+關鍵觀測指標:
Locked、Sending data、Sorting result、Copying to tmp table| 現象 | 可能原因 |
|---|---|
| 大量相同 SQL 並發 | 應用層無緩存、N+1 查詢、死循環 |
| Time 持續增長 | 鎖等待、大事務、鎖升級、死鎖 |
| State=Locked 佔比高 | MyISAM 表鎖、MDL 鎖、行鎖爭用 |
| Sleep 連接數暴增 | 連接池洩漏、未正確關閉連接 |
| 列 | 關注點 | 優化信號 |
|---|---|---|
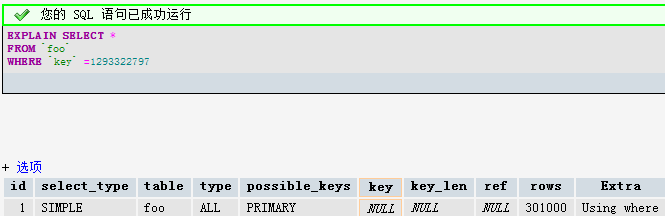
| type | 訪問類型 | ALL=全掃, index=全索引掃, range=範圍, ref/eq_ref=索引查找, const=常量 |
| key | 實際使用索引 | NULL=無索引, 驗證是否命中預期索引 |
| rows | 預估掃描行數 | 越小越好,大於實際行數 10 倍需關注 |
| Extra | 額外信息 | Using filesort/Using temporary=需優化, Using index=覆蓋索引 |
-- 原始慢查詢
SELECT * FROM imgs WHERE userid='admin' ORDER BY clicks DESC LIMIT 10;
-- EXPLAIN: type=ref, key=userid, rows=2944, Extra=Using where; Using filesort優化演進:
INDEX(userid) → rows=2944,仍需 filesortINDEX(clicks) + WHERE clicks > 1000 → 強制索引、範圍掃描,rows=312,無 filesortINDEX(userid, clicks) → Extra=Using where(無 filesort),索引天然有序滿足 ORDER BY核心洞察:INDEX(userid, clicks) 使 WHERE 過濾與 ORDER BY 排序在同一索引內完成,避免臨時表與排序。
| 參數 | 建議基準值 | 調整依據 |
|---|---|---|
| innodb_buffer_pool_size | 物理內存 60-80% | 核心緩衝區,觀察 Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests 命中率 |
| innodb_log_file_size | 512MB-2GB | 大事務場景適當增大,避免頻繁 checkpoint |
| innodb_flush_log_at_trx_commit | 1(強一致) | 允許丟失 1 秒數據可設 0/2,大幅提升寫入吞吐 |
| max_connections | 200-500 | 配合應用連接池,避免連接風暴 |
| thread_cache_size | 32-64 | 觀察 Threads_created 增長速率 |
| sort_buffer_size | 256KB-2MB | 會話級,大查詢臨時調大 |
| query_cache_type | OFF | 高寫入場景關閉,唯讀場景 DEMAND |
| wait_timeout / interactive_timeout | 30-60s | 快速回收閒置連接 |
當單機優化觸達天花板:
long_query_time=1、log_queries_not_using_indexes=ONpt-query-digest 分析 Top N 慢查詢性能調優是持續迭代過程,而非一次性動作。建立觀測-分析-優化-驗證閉環,才能持續保障數據庫高可用高性能。