MySQL 查詢優化器的首要目標是盡可能使用索引,並選擇最嚴格的索引以過濾掉最大量的非目標資料行。優化器不直接「尋找」符合條件的行,而是透過「排除」不符合條件的行來縮小搜尋範圍,排除越快,找到目標行也就越快。
假設查詢:
SELECT col3 FROM mytable
WHERE col1 = 'some value' AND col2 = 'some other value';
若 col1 索引匹配 900 行,col2 索引匹配 300 行,兩者同時匹配僅 30 行。優化器會先測試 col2(僅需檢查 300 行,失敗 270 次),而非先測試 col1(需檢查 900 行,失敗 870 次),因後者 I/O 與計算開銷更大。
索引欄位參與比較運算時,確保兩側資料型別一致。INT 與 BIGINT、CHAR(10) 與 CHAR(12) 屬於不同型別,會導致索引失效。必要時使用 ALTER TABLE 修改欄位型別使其匹配。
避免在索引欄位上使用函數或複雜運算式。例如:
WHERE mycol < 4 / 2 → 優化器可簡化為 mycol < 2 並使用索引。WHERE mycol * 2 < 4 → 必須逐行計算 mycol * 2,索引無法使用,導致全表掃描。EXPLAIN 可在 SELECT 前加上,讓 MySQL 輸出執行計畫而不實際執行查詢。
mysql> EXPLAIN SELECT * FROM tbl_name WHERE 0\G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: NULL
type: NULL
possible_keys: NULL
key: NULL
key_len: NULL
ref: NULL
rows: NULL
Extra: Impossible WHERE
關鍵欄位解讀:
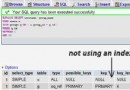
possible_keys:可能用到的索引。key:實際選用的索引。key_len:索引鍵長度,判斷複合索引使用了幾個欄位。rows:預估需掃描的行數。Extra:額外資訊(如 Using index、Using where、Using filesort 等)。理解優化器「以排除代替搜尋」的思維,配合 EXPLAIN 觀察實際執行計畫,並遵循「同型別比較」、「索引欄位獨立」兩大原則,即能撰寫出更易於優化器產生高效執行計畫的 SQL 語句。