構建基於 IBM DB2 UDB 與 Borland 工具(Delphi、C++Builder、Kylix)的企業應用,程序員可借助 DB2 優化器處理複雜 SQL 並給出有效存取路徑。但拙劣編碼的 SQL 仍會拖垮性能。本文揭示優化器工作原理,給出編寫高效 SQL 的三大核心准則,並針對 Delphi 等工具提供進階技巧。
BETWEEN vs <=/>=、IN vs OR、連接 vs 子查詢)性能可能天差地別。優化器是基於成本的專家系統:解析 SQL → 查詢系統目錄統計信息 → 應用查詢成本公式(CPU、I/O、統計信息、SQL 文本) → 選擇總成本最低的存取路徑。四步驟:語法驗證、環境分析優化、生成機器指令、執行/存儲。
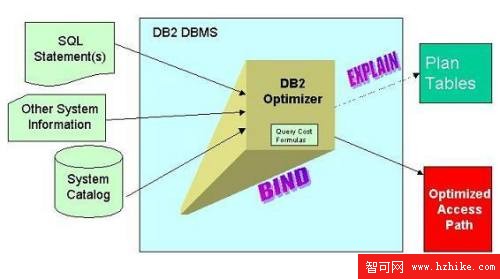
RUNSTATS 定期收集表/列/索引/表空間統計,無統計信息優化器「盲人騎瞎馬」。WHERE EMPNO='000010' AND DEPTNO='D01' 為例,(EMPNO, DEPTNO) 復合索引通常最優。權衡因素:修改開銷、現有索引覆蓋、查詢業務重要性、是否實現「僅索引訪問」(含覆蓋列)。EXPLAIN、Visual Explain 觀察計劃。害處: 表結構變更導致程序崩潰;傳輸無用列消耗網絡/CPU/內存;可讀性差、易引入隱性 Bug。正例: SELECT LASTNAME, SALARY FROM EMP WHERE EMPNO='000010';
反例: SELECT EMPNO, LASTNAME, SALARY FROM EMP WHERE EMPNO='000010'; — EMPNO 已在 WHERE 給出,重複檢索純屬浪費。
反例: 全表讀回應用層再判 SALARY > 50000。正例: SELECT EMPNO, LASTNAME, SALARY FROM EMP WHERE SALARY > 50000; — DB2 過濾後傳輸少量行,I/O/CPU 雙贏。
用參數標記(?)替代字面值,優化器可重用存取路徑,避免重複優化開銷。應用設計為用戶運行時提供參數值。
COMMIT,異常時 ROLLBACK。FETCH FIRST n ROWS ONLY 截斷結果集(超過報 SQLCODE +100),適配分頁顯示。OPTIMIZE FOR n ROWS 告訴優化器優先快速返回前 n 行(不截斷),適配分批獲取場景。FOR READ ONLY 消除歧義,DB2 可應用更激進優化(Delphi 不支持位置更新)。掌握優化器原理與三大法則,性能即刻提升。但這只是冰山一角:連接、子查詢、集合運算、存取路徑分析……精通之路漫長。享受探索樂趣,構建極速應用!