DB2 9 提供 pureXML 儲存、XQuery 與 SQL/XML 查詢語言。XML 索引為高查詢效能所必需,但其在查詢評估中的使用取決於查詢謂詞的表示方式。本文以一致方式提供編寫 XML 查詢與建立 XML 索引的指導原則,確保如期加速查詢。介紹查詢執行計畫中需尋找的內容以偵測效能問題並尋找解決方案。可下載「備忘單」摘要最重要指導原則。
DB2 9 提供 pureXML 儲存、XML 索引、XQuery/SQL/XML、XML Schema 支援、工具程式 XML 擴展。如關聯查詢般,索引對高效能 XQuery/SQL/XML 至關重要。DB2 允許在 XML 欄位定義路徑專用 XML 索引,可索引頻繁用於謂詞與聯結的選定元素與屬性。例如,基於作者 ID,可用索引 idx1 查找與聯結表 books XML 欄位 bookinfo 中所有文件:
create table books(bookinfo XML);
create index idx1 on books(bookinfo) generate keys
using XMLpattern '/book/authors/author/@id' as sql double;
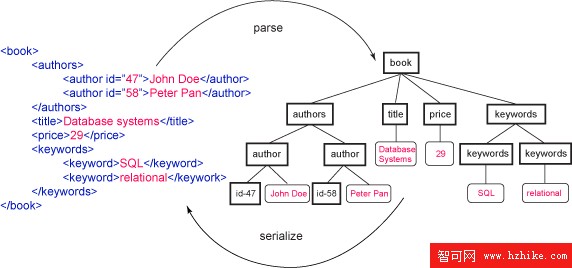
圖 1. 示例 XML 文件文字與解析階層格式
因 DB2 不強制單一 XML Schema 對應 XML 欄位所有文件,特定元素/屬性資料型別預先未知,故每個 XML 索引須指定目標型別。可用型別:
VARCHAR(n):已知最大長度 n 的字串值節點VARCHAR HASHED:任意長度字串值節點,含雜湊值,僅用於等式謂詞DOUBLE:任意數值型別節點DATE、TIMESTAMP:日期/時間戳值節點VARCHAR(n) 長度為強制約束:插入文件若索引元素/屬性值超過 n 則失敗;建立索引時若現有值超過 n 亦失敗。DOUBLE/DATE/TIMESTAMP 非強制約束:如作者 ID 索引定為 DOUBLE 期望數值,插入非數值 "MN127" 文件仍成功但不加入索引(因數值謂詞永不匹配非數值),此行為正確。
應用提交查詢時,查詢編譯器比較查詢謂詞與現有索引定義,確定可用索引——此過程稱「索引匹配」,產生合適索引集合(可能為空)輸入基於成本的優化器決定是否使用。本文專注索引匹配而非優化器選擇。關聯查詢中索引匹配通常微不足道,但 XML 欄位更複雜:關聯欄索引含該欄所有值,XML 索引僅含同時匹配 XML 模式與索引定義資料型別的節點值。故 XML 索引僅當擁有「正確」資料型別且至少包含滿足謂詞的所有 XML 節點時,才能評估 XML 查詢謂詞。合格性兩大要求:
本文闡述如何設計索引與查詢確保符合要求、避免常見錯誤。先理解查詢執行計畫。DB2 現有解釋工具(Visual Explain、db2exfmt)可檢視 XQuery/SQL/XML 執行計畫。
DB2 9 引入三個新內部查詢運算子:XSCAN、XISCAN、XANDOR,配合現有運算子(TBSCAN、FETCH、SORT)生成執行計畫。
IXSCAN,在 XML 索引上執行查找/掃描。輸入值謂詞(如 /book[price=29] 或 $i/book/price=29 的路徑值對),回傳行 ID 與節點 ID(識別合格文件與節點)XISCAN 同時評估兩個以上等式謂詞,回傳滿足所有謂詞文件的行 ID查詢:where $i/book/title="Database systems" and $i/book/price=29,索引 idx1 於 /book/title (VARCHAR(50))、idx2 於 /book/price (DOUBLE)。圖 2 展示三種簡化計畫(db2exfmt 輸出),邏輯流自下而上、左至右,最佳從左下運算子開始看。
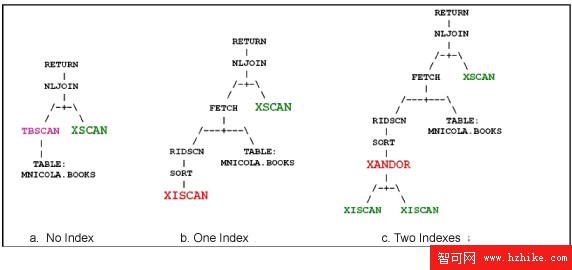
TBSCAN 讀取所有列 → NLJOIN 傳遞 XML 文件指標給 XSCAN → 遍歷評估謂詞、提取 authors → RETURNidx2 於 /book/price):XISCAN 用路徑值對 (/book/price, 29) 檢查索引 → 回傳行 ID → 分類去重、優化 I/O → RIDSCN 掃描行 ID 觸發預取 → FETCH 讀取對應列 → XSCAN 處理 XML 文件、評估 title 謂詞、提取 authors。僅檢索部分列,遠低於全表掃描成本XISCAN 分別用於各謂詞/索引 → XANDOR 輪流檢查兩索引高效找到同時匹配的行 ID → FETCH 僅檢索這些列 → XSCAN 提取 authors。謂詞含 // 或 * 或範圍比較時用 IXAND 替代 XANDOR,邏輯相同但針對不同謂詞類型優化優化器可能決定不使用索引(如第二索引未有效減少檢索列數、或存取索引成本超過節省 I/O)。但需確保優化器考慮所有合適索引,以最低成本最短時間選擇計畫——即遵守 XML 索引合格性兩要求:索引至少包含滿足謂詞所有 XML 節點、查詢謂詞資料型別與索引定義相容。
萬用字元 // 與 * 影響索引與謂詞間包含關係。路徑表達式不同:/book/price 識別 book 直接子元素 price;//price 識別文件所有層級 price。故 /book/price 為 //price 子集,//price「包含」/book/price 但反之不然。
以查詢 where $i//price=29 等四種謂詞變化為例,表 1 展示兩可選索引(/book/price、//price,皆 DOUBLE)的合格性:
| # | 謂詞/索引定義 | /book/price | //price |
|---|---|---|---|
| 1 | where $i//price = 29 | - | + |
| 2 | where $i/book/price = 29 | + | + |
| 3 | where $i/book/* = 29 | - | - |
| 4 | where $i/*/price = 29 | - | + |
分析:謂詞 1 僅 //price 合格(索引含所有層級 price);謂詞 2 兩索引均合格;謂詞 3 用 * 查找 book 下任意值為 29 的子元素,兩索引均不含 title 等可能匹配元素,故不可用;謂詞 4 查找任意根元素下 price,/book/price 索引遺漏 /journal/price 等,//price 含任意根元素下 price 故合格。結論:DB2 編譯器必須驗證索引限制等同或低於謂詞限制。建議索引定義與查詢盡量用精確路徑避免萬用字元;//*、//text() 等通用模式可接受但慎用——//* 甚至索引非葉元素,易超過 VARCHAR(n) 長度限制。
索引合格性須考量命名空間。若 XML 文件含命名空間,索引定義必須考慮。例:文件含 xmlns:bk="https://mybooks.org",索引 idx3 定義為 /book/price(空命名空間)則無索引條目。以下三種定義均可適當索引 price:
idx4: declare namespace bk="https://mybooks.org"; /bk:book/bk:price
idx5: declare default element namespace "https://mybooks.org"; /book/price
idx6: /*:book/*:price
XQuery 謂詞亦有相應選項(查詢 4/5/6)。表 2 展示合格性矩陣:idx3 無法用於任何考慮命名空間的查詢;idx4/idx5 邏輯相同(顯式 vs 預設命名空間);idx6(命名空間萬用字元)對所有查詢合格,甚至可用於無命名空間謂詞;idx4/idx5 含特定命名空間條目,不可用於查詢 6(尋找任意命名空間書價),違反包容性要求。
除萬用字元與命名空間包容性,第二要求為謂詞與索引資料型別匹配。以 /book/price 為例,表 3 對比 DOUBLE 與 VARCHAR(10) 索引:字串謂詞 < "29" 僅 VARCHAR 索引可評估;數值謂詞 < 29 僅 DOUBLE 索引可評估。關聯索引型別由欄型別決定,但 XML 元素/屬性型別非預先確定(不強制 XML Schema),故每 XML 索引需目標型別。型別關鍵:假設 price 值為 9,字串比較 "9" < "29" 為假,數值比較 9 < 29 為真——若欲語義正確數值比較,應用 DOUBLE 索引。
值謂詞含字面值決定比較型別,但聯結謂詞通常無字面值。例:books 表含作者 ID,authors 表含詳細作者資訊,欲聯結檢索書籍作者詳細資訊。作者 ID 索引定為 DOUBLE:
create index authorIdx1 on books(bookinfo) generate key using
XMLpattern '/book/authors/author/@id' as sql double;
create index authorIdx2 on authors(authorinfo) generate key using
XMLpattern '/author/@id' as sql double;
查詢 where $i/book/authors/author/@id = $j/author/@id 未使用索引。因聯結謂詞無字面值指示型別,DB2 必須考慮匹配任意型別作者 ID。若存在非數值 ID(如 "TN28"),數值索引找不到,回傳不完整結果,故 DB2 採用表掃描確保正確性。
兩種情況可幫助 DB2 使用 DOUBLE 索引:
xs:double(.)),要求數值比較、排除非數值匹配。加謂詞 > 0 排除非數值 ID此時查詢無值謂詞限制表,DB2 必須兩表掃描讀取所有作者 ID,對每 ID 用索引檢查另一表是否出現——仍比無索引雙表掃描巢狀迴圈快得多。表 5 展示兩執行計畫(db2exfmt 產生),XMLEXISTS 謂詞寫法影響聯結順序、決定哪表用表掃描哪表用索引。若無法避免表掃描,用在較小表上。
總結建議:將聯結謂詞轉換為應用的 XML 索引型別。表 6 對照:DOUBLE 用 xs:double、VARCHAR 用 fn:string、DATE 用 xs:date、TIMESTAMP 用 xs:dateTime。
XQuery 無專用「between」功能。表達範圍條件時需注意 XQuery 一般比較謂詞的存在語義。直覺用 /book[price>20 and price<30] 不構成「between 謂詞」:書可能有多個 price 子元素(如幣別不同),一般比較有存在語義——若存在值>20 的 price 同時存在值<30 的 price(可為不同元素),謂詞選中該書。但這兩價格均不在 20-30 間。若 DB2 用單一索引範圍掃描 20-30 會遺漏該文件、回傳不完整結果;或計算兩索引掃描交集(成本高)。圖 3 對比:左側 IXAND 計畫無效(產生大量行 ID 需大量排除);右側單一範圍掃描啟動謂詞 20 < price < 30 效能高 1-2 個數量級。
僅當 DB2 確定資料項為單一項而非序列時,同一資料項上的一對範圍謂詞才被解釋為「between」並用單一索引掃描評估。三種實現方式:
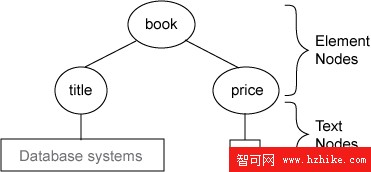
price 元素,用 XQuery 值比較強制運算元為單一數。若出現多 price 執行期失敗報錯. 表示,/book/price[.>20 and .<30] 確保兩謂詞用於相同 price 元素。Self 軸恆評估單一值,構成「between」。優勢:允許書有多 price 但要求所有值在 20-30 間,無執行期錯誤風險price 為屬性,每書至多出現一次,/book[@price>20 and @price<30] 操作元為單一數,可單一索引範圍掃描圖 4 展示範例文件 XML 資料模型:元素由元素節點表示,實際資料值由文字節點表示。元素值定義為該元素下子樹所有文字節點串聯。最底層元素值等於其文字節點。
XPath /book/price 識別元素節點 price;/book/price/text() 指向值 "29" 的文字節點。兩查詢回傳不同:前者回傳完整元素 <price>29</price>,後者僅回傳文字節點值 29。謂詞用不帶 /text() 的 XPath(如 $b/book)時,DB2 自動用元素值評估——book 元素值為 "Database Systems29",故匹配。但謂詞加 /text()($b/book/text())則不匹配(文字節點非直接位於 book 下)。
故一般查詢語義隨 /text() 使用而異,索引合格性也異。表 7:帶 /text() 謂詞僅能由 XML 模式亦指定 /text() 的索引評估。建議不要在索引定義或查詢謂詞用 /text()。為支援以 /text() 結尾路徑謂詞,可在 //text() 定義索引,但將包含所有文件所有文字節點值——索引龐大、維護開銷大。除非應用多為唯讀且確無法預測搜尋條件用哪些元素,否則應避免。
非葉(非原子)元素含其他元素。雖可定義索引,但少數情況有用。例:/book 索引含單一索引項,值為 "John DoePeter PanDatabase Systems29SQLrelational"——無用,因一般查詢不在謂詞用此類串聯值。大多數索引應在葉元素上。
特定情況非葉元素索引有意義:查詢含區碼與完整電話號碼謂詞時,設計 phone 元素含 areacode、number 子元素,於非葉 phone 與 areacode 分別定義索引,可支援 phone=4084511234 與 phone/areacode=408 兩查詢用索引而非表掃描。XML 索引無法組合類似多欄關聯索引的複合鍵,但適當巢狀元素可模擬複合索引(如 phoneidx 類似 /phone/areacode 與 /phone/number 複合索引)。
所有 XML 索引合格性指導原則適用於 XQuery/SQL/XML 查詢。對 XMLQUERY、XMLEXISTS 另有考量:
XMLQUERY 在 SELECT 子句用 XML 謂詞不排除結果集列,故不可用索引。僅單一文件用、回傳文件片段(可能為空)。文件過濾謂詞與列過濾謂詞應放入 WHERE 子句 XMLEXISTSXMLEXISTS 謂詞必須用方括號($a/author[phone=4084511234]),而非 $a/author/phone=4084511234。後者為布林謂詞,若 phone 無所需值回傳 "false",但 XMLEXISTS 檢查值存在,「false」存在也滿足,導致所有文件成結果。用方括號則 XPath 評估失敗空序列,排除相應列XQuery let、return 子句不過濾結果集,故涉及元素結構時不可用索引。例:兩查詢必對每作者回傳 phone408 元素(含區碼 408 外作者的空元素),故不可用索引。
DB2 9 不用索引處理出現於父級(..)下的謂詞。可改寫避免父軸:$b/price<10 替代 $b/../price<10。
謂詞用 // 需加點(self 軸)指明從當前元素向下。錯誤://@id = 129 引用文件根;正確:.//@id = 129。加點後可用定義於 /book//@id 或 //@id 的索引;無點則不使用任何索引。
XML 索引對 XML 查詢高效能至關重要,但查詢萬用字元、命名空間、資料型別、聯結、文字節點等語義決定索引可用性。需注意這些面向確保索引定義與查詢謂詞相容。本文提供指導原則與範例展示如何用 XML 索引避免表掃描、提升查詢效能。備忘單摘要最重要原則。