整理自資深 DBA 經驗,釐清常見錯誤觀念,避免誤導調優方向。
| # | 迷思 | 真相 |
|---|---|---|
| 1 | 邏輯設計必須與物理設計完全對應 | 物理設計為效能可偏離邏輯結構 (分區、叢集、MVC 等) |
| 2 | 所有物件放入 BP0 讓 DB2 自管 | 僅目錄/目錄表放 BP0;用戶表應依存取模式分配專屬緩衝池 |
| 3 | DSNDB07 100% 循序 I/O | 工作檔含 3-45% 隨機 I/O (典型 3-10%) |
| 4 | VARCHAR 應永遠放行末 | 唯讀表放行末省 CPU;頻繁更新表放行末反而最差,甚至壓縮表更糟 |
| 5 | 程式碼應遵循邏輯流程撰寫 | OLTP 高併發下需考慮鎖順序、索引覆蓋等物理層面,偽碼不足夠 |
| 6 | 大多數邏輯不在 SQL 中處理 | SQL 是集合運算語言,能處理多數業務邏輯;誤用為 I/O 處理器才是問題 |
| 7 | 代碼/參考表應配合 RI 使用 | RI 僅用於真正父子關係,非編輯驗證捷徑 |
| 8 | 表最多 1-2 個索引 | 索引數量應依查詢負載決定,多索引常見且必要 |
| 9 | 非分區索引 (NPI) 不該用,尤其大表 | NPI 對特定存取路徑必要,問題可克服,不可一概禁用 |
| 10 | 大表必須分區 | 60 億列以上表未分區仍可高效運行,分區非唯一解 |
| 11 | 未授權讀 (UR) 是壞事 | UR 是強效能增強,適用範圍遠超常認知 (唯讀報表、近似統計等) |
| 12 | WHERE 謂詞不可用否定 | 僅單一否定謂詞可能導致表掃描;複合謂詞中否定通常無害 |
| 13 | 只靠 EXPLAIN 判斷存取路徑好壞 | EXPLAIN 不顯示查詢塊順序、階段謂詞、執行時間,需結合 Visual Explain、監控數據綜合判讀 |
| 14 | EDM Pool 不要太大避免分頁 | EDM Pool 透過擴展儲存分頁反而提升效能,過小導致持續重建內部結構 |
| 15 | 擴展 (Extent) 不影響其他 | 雖新控制器降低影響,仍有額外檢查/管理開銷 |
| 16 | 關聯劃分 (Relation Partitioning) 不用於 DB2 | BI/市場系統中常被單一程序多次使用,極具價值 |
| 17 | 所有套件綁定到兩個計劃 (批次/線上) | 包綁定策略靈活多樣,雙計劃說法過時且有害 |
| 18 | ESA 壓縮總是好 | 壓縮需個案評估,高層決策,非可選項 |
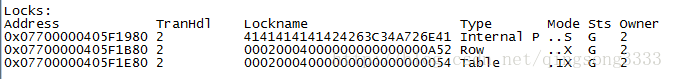
| 19 | 無逾時/死鎖即無鎖問題 | 鎖等待時間才是關鍵指標,統計死鎖數量屬事後反應 |
| 20 | DB2 預設值即最佳 | 預設值隨版本變動,非最佳 (如 CURRENTDATA 綁定參數) |
db2pd、MON_GET_* 表函數獲取即時運行指標。