| # | 流傳誤區 | 實戰真相 |
|---|---|---|
| 1 | 邏輯設計必須 1:1 映射物理設計 | 為性能 (分區、MCC、聚簇) 做的物理調整不來自邏輯模型,必須允許偏離。 |
| 2 | 所有表丟進 BP0 讓 DB2 自管 | 僅在內存極小 (<10k 頁) 且無精力調優時才這樣。生產環境應將業務表移出 BP0,獨立緩衝池。 |
| 3 | DSNDB07 (工作庫) 100% 順序 I/O | 工作文件含 3%-45% 隨機頁訪問,並非純順序。 |
| 4 | VARCHAR 必須放行末 | 唯讀/少更新表放行末省 CPU;高頻更新表放行末反而最差 (行遷移)。視業務模式決定。 |
| 5 | 代碼按邏輯流程寫 (偽代碼風格) | OLTP 高並發下必須按性能模式寫 (如預取、批量、減少往返),邏輯順序常是反模式。 |
| 6 | 大多數業務不在 SQL 做 | SQL 是集合處理器,能完成絕大多數業務邏輯;濫用為 I/O 接口才是反模式。 |
| 7 | 代碼表/引用表用 RI (Referential Integrity) 維護 | RI 用於真實父子業務關係,不作編輯校驗捷徑 (觸發器/應用層更靈活)。 |
| 8 | 表至多 1-2 個索引 | 索引數量由訪問路徑決定,高並發 OLTP 常需 5-10+ 索引支撐不同查詢模式。 |
| 9 | 非分區索引 (NPI) 不能用,特別是大表 | NPI 對分區表跨分區唯一性、全局排序、某些訪問路徑不可或缺,問題可通過設計規避。 |
| 10 | 大表必須分區 | 60 億行+ 單分區表運行良好;分區是為管理/可用性/並行,非單純為行數。 |
| 11 | DB2 默認值都是最好的 | 默認值隨版本變化 (如 CURRENTDATA),必須顯式綁定參數鎖定行為。 |
| 12 | WHERE 子句禁用否定邏輯 (NOT/!=) | 僅當否定導致全表掃描時才惡化;多數情況下引擎內部高效過濾,可讀性優先。 |
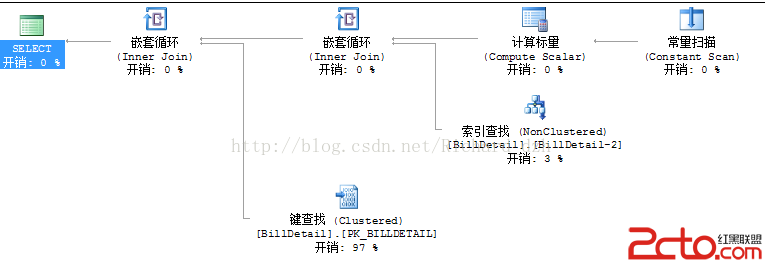
| 13 | 只看 EXPLAIN 判斷訪問路徑好壞 | EXPLAIN 不顯示塊執行順序、一/二階段謂詞、塊耗時;需結合監控、Visual Explain 綜合判讀。 |
| 14 | EDM 池不能太大以免分頁 | EDM 池分頁到擴展存儲反而提升性能 (避免重建結構);過小才是禍根。 |
| 15 | 擴展 (Extent) 不影響其他 | 雖緩存控制器弱化了影響,但擴展管理仍有額外元數據檢查開銷,大表受益於大擴展。 |
| 16 | 關係劃分 (Vertical/Horizontal Partitioning) 在 DB2 不用 | BI/市場系統大量使用關係劃分 (如按月分表、熱冷分離),極其有效。 |
| 17 | 所有包綁定進兩個 Plan (批/線) | Package 粒度綁定靈活得多;大 Plan 導致綁定鎖爭用、回滾困難、版本管理混亂。 |
| 18 | 未提交讀 (UR) 是壞事 | UR 是極佳性能增強手段,適用於報表、只讀、可容忍髒讀的海量查詢,遠超常規認知。 |
| 19 | 無超時/死鎖即無鎖問題 | 鎖等待時間長嚴重拖慢響應,卻不產生死鎖/超時;必須監控 LOCK WAIT TIME 而非只數事件。 |
| 20 | ESA 壓縮總是好 | 壓縮省空間但增 CPU;OLTP 高並發寫入場景可能反降性能。須逐表壓測決策,非全開關。 |
DB2 優化無銀彈,**拒絕教條、依賴測量、理解機制、因表制宜**。每條「最佳實踐」背後都有適用邊界,打破認知誤區是進階 DBA 的必修課。