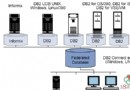
優化需從資料庫設計、查詢重寫、並發控制、客戶/伺服器架構四大支柱系統推進。
不熟悉業務的設計師,縱使精通 DB2 內核,也無法產出最優實體模型。業務實體識別、流程邊界、數據生命週期、訪問熱點分佈 是設計輸入的核心元數據。
| 分區類型 | 切分依據 | 收益 |
|---|---|---|
| 水平(範圍/雜湊) | 日期、地區、租戶 ID | 分區剪枝、並行掃描、歸檔/清理即時完成 |
| 垂直 | 高頻欄位 vs 低頻/大物件欄位 | 熱點表窄化、緩存命中率提升、LOB 離線存儲 |
INT/BIGINT):比較/連接/索引成本遠低於字串。CREATE TYPE EMAIL AS VARCHAR(254) WITH WEAK TYPE RULES),提升模型自描述能力。GROUP BY/ORDER BY 高頻欄位 → 建索引(避免排序溢寫磁碟)。利用索引順序天然滿足 ORDER BY/GROUP BY,避免顯式排序。排序不可避免時:縮小排序列寬度、限制排序行數(FETCH FIRST n ROWS ONLY)、增加 SORTHEAP/SHEAPTHRES 記憶體配額。
字串主鍵比較開銷約為整數的 5-10 倍;資料量達千萬級時,改用 BIGINT 代理鍵可顯著降低連接/索引遍歷成本。
反模式:WHERE col IN (SELECT ...) 導致外層每行觸發內層全表掃描(N×M 複雜度)。
正模式:INNER JOIN ... ON ... 使優化器能選擇 Hash Join / Merge Join,複雜度降為 O(N+M)。
原則:能 JOIN 絕不子查詢;子查詢不可避免時,內層盡早過濾(WHERE 下推)。
LIKE 'M%' 可走索引範圍掃描;LIKE '%M%' 或 LIKE '_M_' 必觸發全表掃描。改寫為範圍條件:col >= 'M' AND col < 'N' 充分利用索引順序。
DISTINCT 產生工作表 + 排序 + 去重,I/O 與 CPU 雙重打擊。替代方案:GROUP BY(可利用索引分組)、應用層去重、或資料模型層面保證唯一性(UK 約束)。
!=、<>、NOT IN、NOT EXISTS 導致全表掃描。改寫為正向條件或 LEFT JOIN ... WHERE right.key IS NULL(反連接模式)。
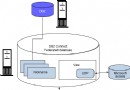
磁碟物化中間結果,引入 I/O 延遲;分散式環境下還涉及進程同步。優先考慮:CTE(WITH 子句)、內聯視圖、物化查詢表(MQT)/ 物化視圖。
複雜業務邏輯封裝為 Stored Procedure,首次執行生成最優計畫並缓存,後續調用跳過解析/優化/編譯階段。配合 DB2 Query Patroller 對比多計畫代價、Performance Monitor 監控 I/O/排序/同步讀寫指標,持續迭代優化。
WITH UR)、LOCKSIZE ROW 強制行鎖、LOCK TABLE ... IN SHARE MODE 短時共享鎖。FETCH FIRST n ROWS ONLY + OPTIMIZE FOR n ROWS 引導優化器選擇最適合的存取路徑。DB2_ASYNC_COMMIT=ON(需業務容忍極小概率丟失)。TCP_SEND_BUF/TCP_RECV_BUF、關閉 Nagle 算法(TCP_NODELAY=ON)降低小包延遲。db2top、db2pd -agents -locks -transactions、MONREPORT.DBSUMMARY 定位 Top SQL/等待事件。將四大支柱融入 DB2 全生命週期管理,讓效能優化從「救火式被動響應」轉型為「架構級主動治理」,支撐業務持續高速增長。