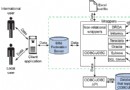
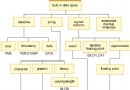
OpenDocument Format (ODF, ISO 26300) 和 Office Open XML (OOXML, ISO 29500, Office 2007+) 均基於 XML 封裝 (ZIP 容器內多 XML 部件:content.xml, styles.xml, meta.xml, settings.xml 等)。DB2 9 pureXML 原生存儲、索引、查詢、驗證 XML,是管理此類文檔的理想存儲庫:無需解壓縮即可查詢內容、元數據、樣式;支持版本控制、全文搜索、XQuery 轉換、Schema 驗證、ACL 安全。
| 模式 | 結構 | 優點 | 缺點 |
|---|
| 整文檔單列 | docs (id PK, filename, mimetype, pkg_xml XML, created_ts) | 簡單、原子事務、備份整體 | 大文檔 ( > 50MB) 內存壓力、更新需整體替換 |
| 部件拆解存儲 (推薦) | docs (id, filename, mimetype) + doc_parts (doc_id, part_name, part_xml XML) | 細粒度查詢/更新、並行處理、部件級索引/權限 | 應用層需組裝/拆解 ZIP、事務跨表 |
| 混合模式 | 核心部件 (content, meta) 拆解,其餘整包存儲 | 平衡查詢性能與存儲簡單度 | 邏輯較複雜 |
關鍵技術實現
1. 導入流程 (Java 示例)
// 1. 解壓 ZIP 到內存 (Apache POI / zip4j / java.util.zip)
ZipFile zip = new ZipFile(file);
ZipEntry contentEntry = zip.getEntry("content.xml");
InputStream is = zip.getInputStream(contentEntry);
String contentXml = IOUtils.toString(is, StandardCharsets.UTF_8);

// 2. 可選:Schema 驗證 (ODF/OOXML XSD)
SchemaFactory sf = SchemaFactory.newInstance(XMLConstants.W3C_XML_SCHEMA_NS_URI);
Schema schema = sf.newSchema(new StreamSource(getClass().getResourceAsStream("/schemas/oodf-content.xsd")));
Validator validator = schema.newValidator();
validator.validate(new StreamSource(new StringReader(contentXml)));

// 3. 存入 DB2 (ibm_db2 驅動)
String sql = "INSERT INTO doc_parts (doc_id, part_name, part_xml) VALUES (?, ?, ?)";
try (PreparedStatement ps = conn.prepareStatement(sql)) {
    ps.setLong(1, docId);
    ps.setString(2, "content.xml");
    ps.setSQLXML(3, conn.createSQLXML()); // 設置 XML 內容
    ps.getSQLXML(3).setString(contentXml);
    ps.executeUpdate();
}
2. 核心查詢場景
- 全文搜索內容:`CONTAINS(part_xml, 'quarterly report')` (需 Text Search 索引 `part_xml`)。
- 元數據提取:`XMLQUERY('$d/meta:document-meta/meta:creation-date' PASSING part_xml AS $d)` (需命名空間聲明)。
- 結構化內容查詢:`XMLTABLE('$d/office:body/office:text/text:p' PASSING part_xml AS $d COLUMNS para_num FOR ORDINALITY, text VARCHAR(1000) PATH '.')` 提取所有段落。
- 樣式/模板分析:查詢 `styles.xml` 中樣式定義、使用頻率。
- 版本比對:兩版本 `content.xml` XMLDIFF (DB2 11.1+ 自定義函數) 或應用層 diff。
3. XML 索引設計
-- 內容部件常用 XPath 索引
CREATE INDEX idx_doc_content_para ON doc_parts(part_xml)
  GENERATE KEY USING XMLPATTERN '/office:text/text:p' AS SQL VARCHAR(1000)
  WHERE part_name = 'content.xml';

-- 元數據索引
CREATE INDEX idx_doc_meta_date ON doc_parts(part_xml)
  GENERATE KEY USING XMLPATTERN '/meta:document-meta/meta:creation-date' AS SQL TIMESTAMP
  WHERE part_name = 'meta.xml';
4. 安全與合規 (LBAC)
為 `doc_parts` 定義安全標籤 (機密級、部門、項目),行級控制敏感文檔部件訪問,列級掩碼 `meta.xml` 中作者信息。
性能與存儲優化
- 壓縮:`COMPRESS YES` 表屬性 + `RUNSTATS` + `REORG`,XML 文本壓縮率通常 70-90%。
- 大對象流式處理:導入/導出時使用 `setBinaryStream` / `getBinaryStream` 避免全量內存。
- 分區表:按 `created_ts` 月度分區 `doc_parts`,歷史分區移至冷存儲、壓縮率更高、獨立備份。
- 異步索引維護:DB2 11.1+ `DEFERRED INDEX MAINTENANCE` 批量導入時減寫入開銷。
應用集成模式
- 內容管理系統 (CMS):DB2 作為後端存儲,CMS 提供 WebDAV/CMIS 接口,內部調用 pureXML 查詢。
- 協同編輯:Operational Transformation (OT) / CRDT 算法在應用層合併操作,最終持久化為 XML 部件更新。
- 報表生成:XQuery/XSLT 將 `content.xml` 轉換為 PDF/HTML 報表模板。
- 歸檔合規:定期導出原始 ZIP 包 (重新組裝部件) 存入 WORM 存儲,滿足法律保留要求。
總結
DB2 9 pureXML 為 ODF/OOXML 文檔管理提供了強大的原生 XML 能力:結構化查詢、索引、驗證、安全、壓縮、分區。通過部件拆解存儲模式、針對性索引、流式處理、LBAC 安全,可構建高性能、合規、可擴展的企業級文檔管理平台,支撐協同編輯、智能檢索、自動化報表等高級場景。
- 上一篇文章: DB2 資料庫分區建立與分區群組配置完整操作手冊
- 下一篇文章: DB2 無限作用日誌策略配置指南:突破 256 個日誌檔案限制
Copyright ©
程式碼之家 All Rights Reserved