數據庫系統的核心承諾是「數據不丟、狀態一致」。當事務失敗、系統崩潰甚至磁盤損壞發生時,恢復子系統必須將數據庫從不一致狀態還原到一致狀態。本文系統梳理恢復的基本概念、存儲模型、基於日誌的兩大策略(推遲/立即修改)、檢查點優化、影子分頁、並發事務恢復以及緩存管理,助你構建完整的恢復知識體系。
恢復的本質是利用冗余(物理冗余,如日誌、備份)將數據庫從失敗導致的不一致狀態恢復到一致狀態。常見失敗類型:
恢復策略分兩階段:正常運行時記錄足夠信息,失敗發生時利用信息還原。
為了精確描述恢復過程,引入分層存儲模型:
| 層級 | 名稱 | 特性 |
|---|---|---|
| L1 | 易失性存儲器 | 主存、Cache,斷電丟失 |
| L2 | 非易失性存儲器 | 磁盤、閃存、NVRAM,斷電保留 |
| L3 | 穩定存儲器 | 理想模型,任何失敗不丟數據(如 RAID、異地備份) |
數據在層間流動的四種基本操作:
input(A):磁盤物理塊 → 主存緩沖塊output(A):主存緩沖塊 → 磁盤物理塊read(X):主存緩沖塊 → 事務私有工作區write(X):事務私有工作區 → 主存緩沖塊注意:DBMS 不必每次 write 都調用 output,寫回策略由 OS 決定(如延遲寫回)。
日誌記錄格式(存放於穩定存儲器):
<Ti, start>:事務開始<Ti, X, old_value, new_value>:寫操作<Ti, commit>:事務提交假設同一時刻最多一個活躍事務(單事務場景)。
partially committed 狀態(即將提交)時才將修改 write 到數據庫;<Ti, commit> → 無操作;有 <Ti, commit> → 順序 redo(重做,寫入 new_value)。old_value 其實可不記錄。write 到主存);log force);<Ti, commit> → 逆序 undo(撤銷,寫回 old_value);有 <Ti, commit> → 順序 redo。遍歷整個日誌開銷極大,引入 <checkpoint>:
output 到磁盤;<checkpoint> 記錄(可能有未提交事務正在進行)。恢復時:反向掃描日誌找到最近的 <checkpoint>,再繼續反向找到最近一個未提交事務的 <Ti, start>,從該處開始執行 redo/undo。
示例時序圖(立即修改模式):
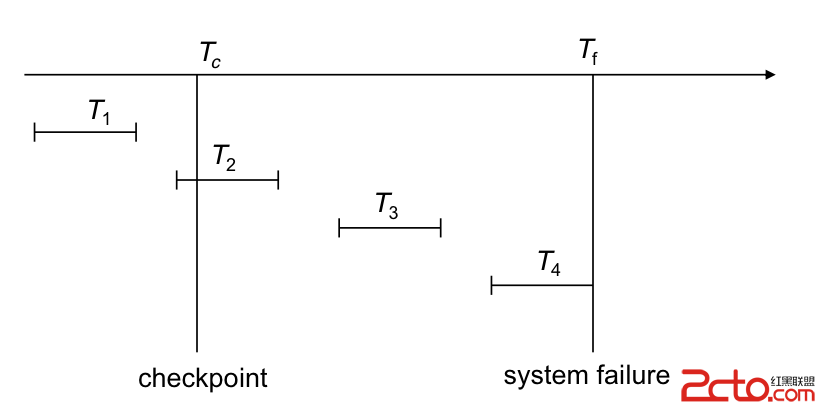
失敗發生時:T1 已在檢查點前提交 → 忽略;T2、T3 已提交但未 output → redo;T4 未提交 → undo。
假設:單活躍事務、磁盤不失敗、db_pointer 始終指向一致性副本。
db_pointer;db_pointer 仍指向舊一致副本。缺點:大型數據庫拷貝整個頁面開銷極大,難以應用於並發場景。
擴展假設:共享緩沖池、共享日誌、嚴格兩階段鎖(2PL)保證隔離性、日誌記錄交織、檢查點記錄活躍事務列表 <checkpoint, L>。
恢復算法:
undo_list、redo_list 為空;<checkpoint, L>;update 加入 undo_list,正序加入 redo_list;undo_list 再執行 redo_list。log force 時批量 output 到磁盤(減少 I/O);<Ti, commit> 落盤前不可進入 Committed 狀態、日誌先於數據頁落盤(WAL)。output;引入 dump 操作:定期將數據庫完整備份到更低層級的穩定存儲(如磁帶)。恢復時先恢復最近一次 dump,再重放其後的日誌。這是分層存儲思想在災難恢復中的延伸應用。
數據庫恢復是一個「以冗余換可靠」的系統工程:日誌是核心數據結構,WAL是核心協議,檢查點是核心優化,undo/redo是核心操作。理解單事務到並發、從主存到磁盤的層層遞進,才能在架構設計與故障排查時游刃有餘。