在數據分析與挖掘的流程中,異常值(Outlier)的檢測是至關重要的一環。異常值指在一組觀測數據中,與其他數據顯著偏離的個別觀測值。它們可能源於測量誤差、數據錄入錯誤,也可能代表著真實但罕見的業務事件(如欺詐交易、設備故障)。若不加處理直接建模,異常值會嚴重干擾統計分佈、拉偏均值與標準差,導致模型效果大打折扣。
本文基於 Excel 數據挖掘增益功能進行操作。若尚未配置環境,請參考前置文章完成安裝與配置。實驗使用的樣例文件為 DMAddins_SampleData.xlsx,其中包含 table analysis tools sample 工作表,記錄了用戶的婚姻狀況、性別、收入、子女數、教育程度、職業、房產、汽車數量、居住區域、年齡及是否購買自行車等屬性。
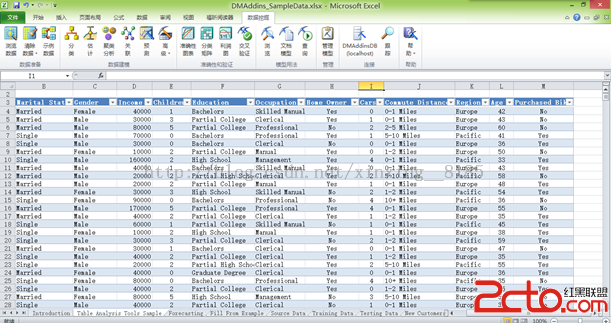
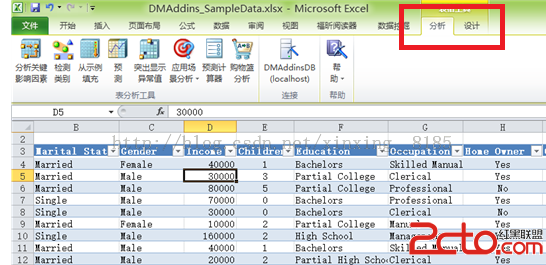
選中表格任意單元格後,功能區將顯示「表格工具」→「分析」選項卡,這是啟動數據挖掘功能的入口。
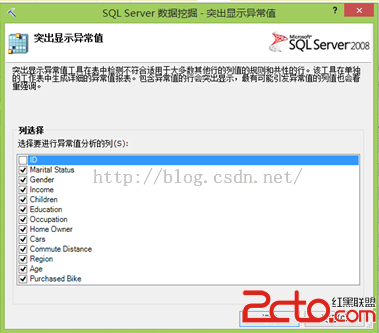
點擊「突出顯示異常值」按鈕,彈出配置對話框。此處可選擇需檢測的目標列(支持多選),工具將基於多維度的綜合統計模型,而非單列的孤立判斷,來識別異常記錄。
執行後,Excel 會在原表中新增標記欄,並生成詳細的分析報表。報表不僅列出異常行,還給出各屬性在該記錄中的異常程度評分,幫助分析師快速定位「為什麼這筆數據異常」。
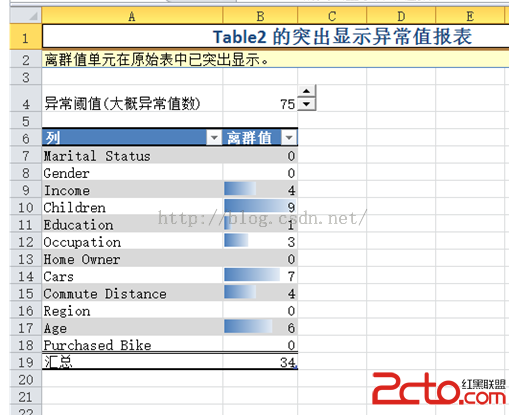
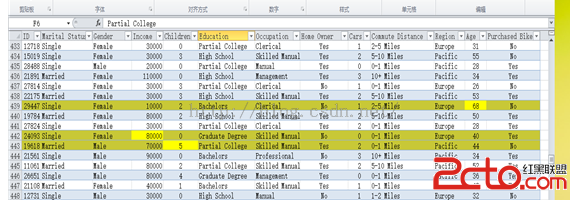
關鍵洞察: 異常值檢測並非孤立看待單一欄位的極大極小值,而是綜合考量各列間的關聯關係。例如,某用戶「收入低」但「汽車數量多」的組合可能被判定為異常,而單看收入或汽車數量可能都在正常範圍內。這種多維度的綜合判斷,極大降低了誤報率,更符合真實業務邏輯。