Python 數據庫 CRUD 通用腳本:基於 PyMySQL 的增刪改查封裝
腳本功能 封裝資料庫連接與游標創建(支持字典游標) 統一 sql() 入口執行 SQL,自動區分查詢與增刪改 查詢返回列表字典,增刪改返回影響行數狀態碼
網路壓力測試腳本集合:ARP/TCP/ICMP/CC/MAC Flood 與端口掃描
⚠️ 僅供學習與授權測試環境使用,嚴禁用於生產網路或未授權目標,違者自負法律責任。 環境依賴 pip install scapy beautifulsoup4
 深度解析Python解釋器、字節碼與虛擬機運行機制
引言 當我們編寫 Python 代碼並執行時,代碼在解釋器內部經歷了怎樣的轉換與處理?本文從 Python 解釋器、字節碼、Python 虛擬機 (PVM)、P
 Python爬蟲實戰:爬取二級頁面數據完整教程
項目背景 以某教學官網「最新課程」列表為例,演示如何爬取前 5 頁列表頁,並進入每門課程的二級詳情頁提取具體信息。 目標數據結構 列表頁:課程標題、縮略圖、
 Ubuntu 安裝 Prometheus 並監控 Nginx 響應速度與 Django 服務完整教學
安裝 Prometheus 1. 建立系統用戶與群組 sudo groupadd --system prometheus sudo useradd -s /sb
Python 數據分析與視覺化入門書籍推薦(有編程基礎者)
提問背景 想透過 Python 進行數據分析與視覺化,網上書籍眾多不知如何選擇。現狀:已有 Python 編程基礎。 經典推薦書籍(按學習路徑分類) 1.
 Python 類別加入 DDT 導致測試方法屬性消失的問題排查
問題現象 在 Python 測試類別上添加 @ddt 裝飾器後,執行測試時提示:AttributeError: TestLogin object has no
 Python 專案模組打包本地發布並上傳至 PyPI 官方倉庫完整教學(中英對照版)
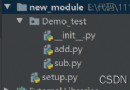
前言 完成功能模組開發後,可將其打包發布,供其他開發者以第三方套件方式安裝使用。本文記錄從本地打包到上傳 PyPI 的完整流程。 一、模組本地發布 1. 專案
Pandas 遍歷篩選與刪除資料補充說明
本文為 ID 250507「Pandas 遍歷篩選與刪除資料」的補充說明。核心內容已於主文詳細闡述,此處僅作索引連結。 請參考主文:Pandas 遍歷篩選與刪除
 Pandas 刪除指定行或列完整指南:drop() 與 del 詳細用法對比(英文版)
Create Sample DataFrame import pandas as pd data = {a: [a0, a1, a2], b:
 Pandas 實現 Excel 篩選與分組操作:groupby 實戰教學(英文版)
Data Preparation import pandas as pd df_1 = pd.read_excel(stu.xls) GroupBy Oper
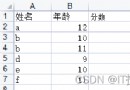 Pandas 實現 Excel 樣式透視表:完整參數詳解與實戰案例(英文版)
1. Get Help Information import pandas as pd df_1 = pd.read_excel(stu.xls) help(d
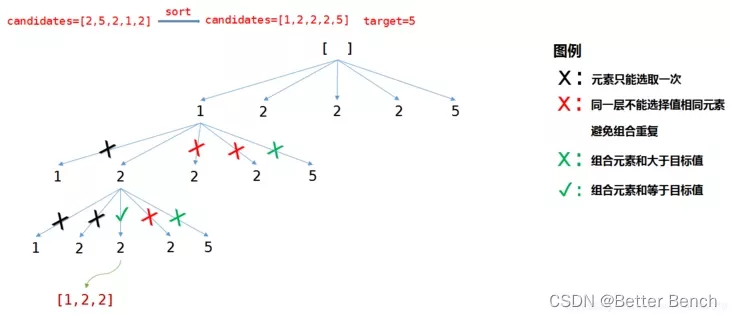 LeetCode 40. 組合總和 II - Python 回溯去重完整解析
題目描述 給定候選數字集合 candidates 和目標值 target,找出所有數字和為 target 的組合。每個數字在每個組合中只能使用一次,解集不能包含
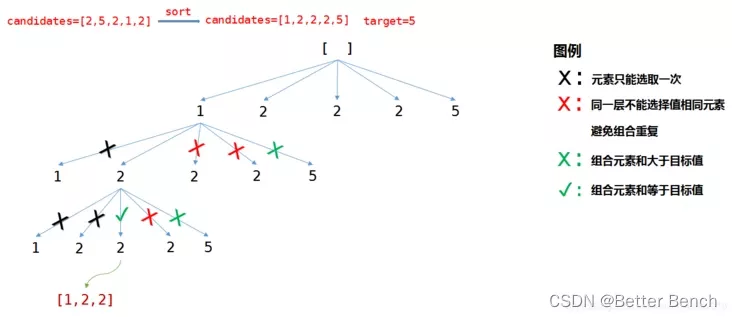 LeetCode 216. 組合總和 III - Python 回溯法完整解析
題目描述 找出所有相加之和為 n 的 k 個數的組合,條件: 只使用數字 1 到 9 每個數字最多使用一次 返回所有可能的有效組合列表,不包含重複組合,順序不
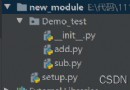 Python 專案模組打包本地發布並上傳至 PyPI 官方倉庫完整教學
前言 完成功能模組開發後,可將其打包發布,供其他開發者以第三方套件方式安裝使用。本文記錄從本地打包到上傳 PyPI 的完整流程。 一、模組本地發布 1. 專案
 Pandas 刪除指定行或列完整指南:drop() 與 del 詳細用法對比
建立範例資料 import pandas as pd data = {a: [a0, a1, a2], b: [b0, b1, b2],
Pandas 遍歷篩選與刪除資料:避免邊遍歷邊刪除報錯的正確姿勢
問題背景 在 Pandas DataFrame 中若直接邊遍歷邊刪除列(df.drop),會導致索引錯亂並拋出錯誤。正確做法是「先記錄符合條件的索引,再集中刪除
 Pandas 實現 Excel 篩選與分組操作:groupby 實戰教學
資料準備 讀取 Excel 檔案,假設包含「年齡」等欄位。 import pandas as pd df_1 = pd.read_excel(stu.xls)