 Appium Capability 詳解:Android 自動化測試啟動參數完整指南
Appium 自動化測試的核心在於 Desired Capabilities(期望能力),它是一組鍵值對,告訴 Appium 服務器如何啟動會話、連接哪台裝置、
 CentOS 7 從原始碼編譯安裝 Python 3.6.2 完整步驟
許多企業伺服器仍運行 CentOS 7,預設 Python 2.7 已停止維護。本文記錄從原始碼編譯安裝 Python 3.6.2 的完整流程,包含依賴套件、下
Python 進階文件處理:TXT、YAML、Excel、CSV 實戰(英文版重構)
本文將英文教學內容重構為繁體中文技術文檔,系統講解四大主流檔案格式在自動化測試與資料分析中的讀寫操作,提供可直接落地的代碼範例。 1. TXT 純文本:基礎中
Python 異常處理與時間日期模組完整教學
穩健的程式必須妥善處理異常,時間日期操作則是日誌、報表、排程的基礎。本文深入解析 try/except/else/finally 機制、自訂異常、calenda
Python 進階文件處理與 OS 模組(英文版核心概念中文重構)
本文將英文教學內容轉化為結構化繁體中文技術文檔,涵蓋文件操作基礎、多種訪問模式、相對與絕對路徑、讀取方法、with 上下文管理器、OS 模組目錄與檔案管理。
Python 進階:檔案處理與 os 模組完整指南
目錄 檔案基本操作 寫入資料 讀取資料 附加寫入 檔案路徑 存取模式 讀取操作進階 with 陳述式讀取檔案 檔案與目錄操作 1. 檔案基本操作 檔案
Python 文件與 OS 模組核心操作入門(重複內容整理版)
本文內容與 ID 257335 高度相似,此處針對重點進行補充與最佳實踐總結,避免單純重複。 補充:編碼與錯誤處理 # 指定 encoding 並處理解碼錯誤
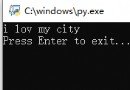 Python 程式執行後保持 CMD 視窗不自動關閉的最簡方法
在 Windows 下雙擊執行 .py 檔案時,程式跑完主控台視窗會瞬間關閉,導致無法查看輸出結果。最簡單的解決方案是在程式碼末尾加上 input() 等待使用
Python 文件與 OS 模組核心操作入門
文件操作是程式設計的基石,os 模組則提供跨平台的檔案系統控制。本文從檔案開啟模式、路徑處理、讀寫指針控制到目錄管理,系統梳理 Python 文件與 OS 核心
Python 進階文件處理:TXT、YAML、Excel 與 CSV 實戰指南
在自動化測試與資料處理專案中,讀寫各類格式檔案是核心技能。本文系統整理 Python 處理 TXT、YAML、Excel (openpyxl)、CSV 四大主流
Python 進階編程:時間日期模組與異常處理機制完整指南
一、異常處理 異常:程式運行時遇到錯誤自動停止並拋出錯誤訊息的行為。異常處理保障程式健壯性(小問題自我處理)與穩定性(持續穩定運行)。 1.1 基本捕獲語法
 Python + Pytest 介面自動化測試系列(一):介面測試基礎與 HTTP 協議核心詳解
前言 本系列從零開始講解介面自動化測試,涵蓋基礎理論、HTTP 協議、Pytest 框架、實戰專案。適合基礎薄弱者循序漸進,也適合資深工程師查漏補缺。 一、介
 Python + QtWebEngineWidgets 實現微信風聊天介面:支援文字、檔案、時間、表情
專案架構 前端:HTML + CSS + JavaScript(單頁面 chat.html) 後端:Python PyQt5 QWebEngineView 載
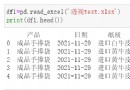 Pandas pivot_table 樞紐表完整教學:從入門到進階實戰
語法總覽 pd.pivot_table(data, values=None, index=None, columns=None, aggfunc=mean, f
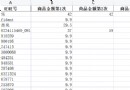 Python 資料處理:將同用戶歷史消費記錄按時間橫向展開為寬表格式
業務需求 將用戶多筆訂單的消費金額按時間順序,從長表(Long Format)轉換為寬表(Wide Format):同一用戶一行,欄位為「第 1 次消費金額」、
Pandas DataFrame 排序與排名完整指南:sort_index、sort_values、rank 詳解
三大排序/排名方法對比 方法用途關鍵參數 sort_index()依索引排序(行或列)axis, ascending, inplace sort_val
 Python 資料清洗實戰:pd.cut() 箱型分箱統計訂單金額分布
業務場景 將原始訂單商品金額進行區間劃分,統計各金額區間的訂單數量,支援業務決策分析。 核心工具:pd.cut() pd.cut(x, bins, right
Pandas set_index 與 reset_index 完整指南:索引重設與層級管理
1. set_index:設定行索引 DataFrame.set_index(keys, drop=True, append=False, inplace=Fa