在 Web 開發中,從遠端獲取網頁內容並提取所需資料是常見需求。PHP 提供了多種抓取網頁的方法,搭配不同的解析技術,能高效完成資料採集、API 整合等任務。本文系統梳理 PHP 抓取網頁的六大主流方式,以及三種主流 HTML/XML 解析策略,並附上可直接運行的代碼示例。
最基礎的方法,將整個文件讀入陣列,每行佔一個元素。
<?php
$url = 'https://t.qq.com';
$lines_array = file($url);
$lines_string = implode('', $lines_array);
echo htmlspecialchars($lines_string);
?>優點:代碼簡潔;缺點:記憶體佔用大,不適合大文件,需開啟 allow_url_fopen。
一行代碼獲取完整內容,是目前最常用的簡易抓取方式。
<?php
$url = 'https://t.qq.com';
$lines_string = file_get_contents($url);
echo htmlspecialchars($lines_string);
?>
同樣依賴 allow_url_fopen = On,且無法精細控制請求標頭、超時等參數。
適合大文件分塊讀取,可控制緩衝區大小。
<?php
$url = 'https://t.qq.com';
$handle = fopen($url, "rb");
$lines_string = "";
do {
    $data = fread($handle, 1024);
    if (strlen($data) == 0) { break; }
    $lines_string .= $data;
} while (true);
fclose($handle);
echo htmlspecialchars($lines_string);
?>功能最強大,支援 HTTPS、POST、Cookie、代理、超時控制等高級特性。
<?php
$url = 'https://t.qq.com';
$ch = curl_init();
$timeout = 5;
curl_setopt($ch, CURLOPT_URL, $url);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1);
curl_setopt($ch, CURLOPT_CONNECTTIMEOUT, $timeout);
$lines_string = curl_exec($ch);
curl_close($ch);
echo htmlspecialchars($lines_string);
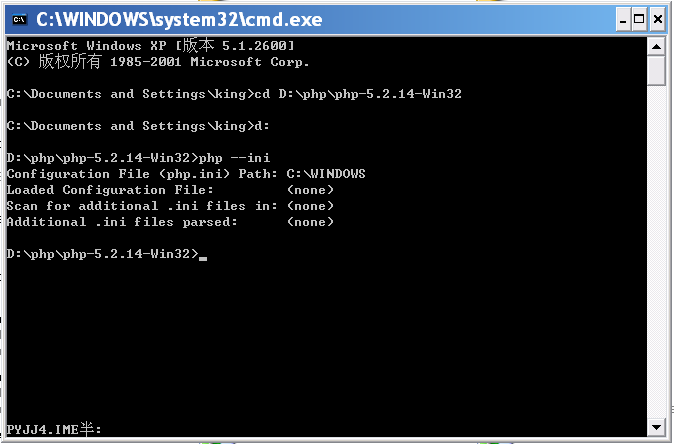
?>啟用方法:Windows 下 php.ini 取消 extension=php_curl.dll 註釋,並將 ssleay32.dll、libeay32.dll 複製到系統目錄;Linux 安裝 php-curl 擴展。
直接操作 TCP/UDP 協議,適合特殊協議或極致性能場景,但需手動構建 HTTP 協議報文。
<?php
$fp = fsockopen("udp://127.0.0.1", 13, $errno, $errstr);
if (!$fp) {
    echo "ERROR: $errno - $errstr<br />\n";
} else {
    fwrite($fp, "\n");
    echo fread($fp, 26);
    fclose($fp);
}
?>
受限於伺服器協議支援情況,通用性較差。
封裝良好、模擬瀏覽器行為的純 PHP 類庫,適合不支援 cURL 的虛擬主機環境。
靈活但脆弱,適合簡單、結構固定的片段提取。
<?php
$url = 'https://t.qq.com';
$html = file_get_contents($url);
preg_match('/<title>(.*?)<\/title>/is', $html, $matches);
echo htmlspecialchars($matches[1] ?? '');
?>注意:HTML 結構變動極易導致正則失效,不建議用於複雜文檔。
標準 W3C DOM API,健壯性強,支援 XPath 查詢。
<?php
$url = 'https://www.example.com';
$dom = new DOMDocument();
libxml_use_internal_errors(true); // 抑制格式錯誤警告
$dom->loadHTMLFile($url);
$title = $dom->getElementsByTagName('title');
echo $title->item(0)->nodeValue ?? '';
?>
可配合 DOMXPath 進行精準查詢:
$xpath = new DOMXPath($dom);
$nodes = $xpath->query('//div[@class="content"]/p');語法類似 jQuery,選擇器直觀易用,容錯性佳。
<?php
require_once 'simple_html_dom.php';
$url = 'https://t.qq.com';
$html = file_get_html($url);
$title = $html->find('title', 0);
echo $title->plaintext ?? '';
?>支援鏈式操作:$html->find('.list a')->href,開發效率極高。
mb_convert_encoding($html, 'UTF-8', 'auto')。文中提到「php小偷程序」現象值得深思:技術本身中性,但大量採集站未創造原創內容,僅搬運他人成果,違反搜索引擎指南且侵犯版權。作為開發者,應將抓取技術用於:
切勿用於內容盜版、SEO 作弊等灰產鏈條。
掌握 PHP 網頁抓取與解析,關鍵在於「工具選型」與「工程化思維」。cURL 提供最強大的網絡層控制,DOMDocument 保證標準合規,Simple HTML DOM 則極大提升開發體驗。結合緩存、異常處理、編碼轉換等工程細節,即可構建穩健、高效的資料採集系統。