JVM 運行時數據區中,**程序計數器、虛擬機棧、本地方法棧**隨線程生滅,自動回收無需 GC 介入。真正需要管理的是 **堆** 和 **方法區**(元空間),這裡存放對象實例與類元數據,空間有限且動態分配,必須依賴垃圾收集器回收無用對象,保障程序持續運行。
為對象添加計數器,引用+1,失效-1,計數為 0 即可回收。無法解決循環引用(A→B,B→A),主流 JVM 未採用。
以 **GC Roots** 為起點,向下搜索形成引用鏈。不可達對象判定為可回收。
可作為 GC Roots 的對象:
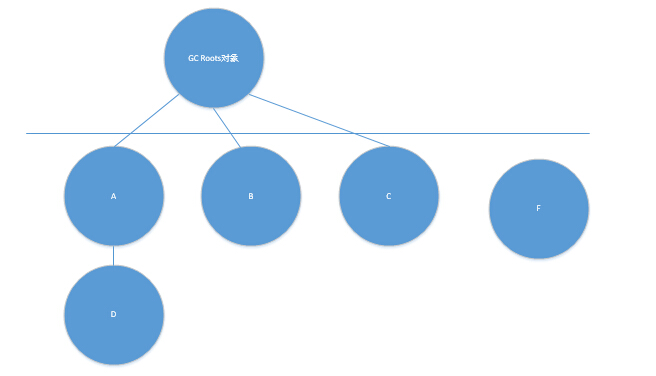
圖中 A、B、C、D 可達,F 不可達 → F 被回收。
| 算法 | 核心思想 | 優點 | 缺點 | 適用場景 |
|---|---|---|---|---|
| 標記-清除 | 標記不可達對象,統一清除 | 實現簡單 | 產生大量碎片,分配大對象困難 | 老年代(配合空閒列表) |
| 標記-整理 | 標記後,移動存活對象一端,清理邊界外內存 | 無碎片,分配效率高 | 需移動對象、更新引用,耗時 | 老年代、大對象存活率高區域 |
| 複製 | 內存劃分兩塊,每次用一塊,GC 時存活對象複製到另一塊 | 無碎片,分配極快(指針碰撞) | 內存利用率僅 50% | 新生代(存活率低) |
| 分代收集 | 新生代用複製,老年代用標記-清除/整理 | 針對對象生命週期特性優化 | 實現複雜 | 通用堆(HotSpot 默認) |
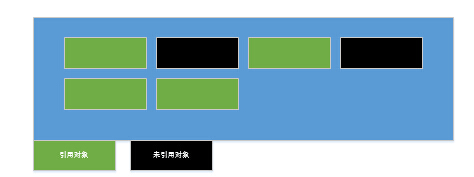
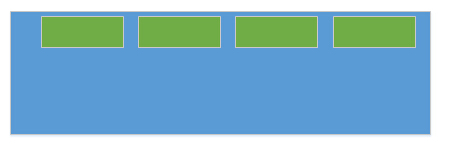
標記-清除前後:
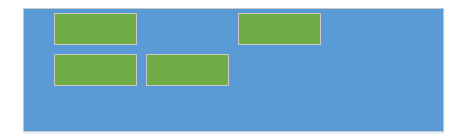
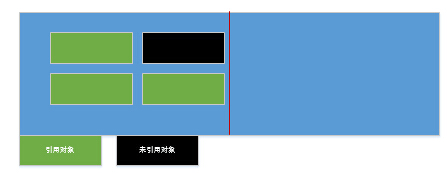
標記-整理前後:
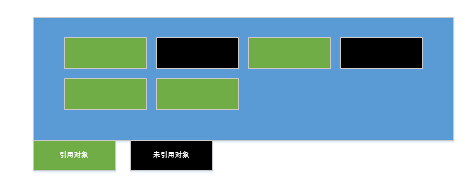
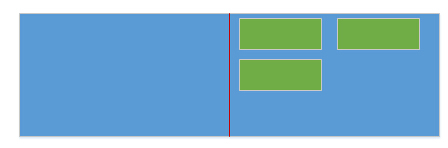
複製算法前後:
 | 收集器 | 線程模式 | 算法 | 目標區域 | 核心特點 | 適用場景 |
|--------|----------|------|----------|----------|----------|
| **Serial** | 單線程 | 標記-整理 | 新生代/老年代 | 簡單高效,無線程切換開銷,但 **Stop-The-World (STW)** | Client 模式、單核、嵌入式 |
| **Serial Old** | 單線程 | 標記-整理 | 老年代 | Serial 老年代版本,CMS 失敗備用 | 同上 |
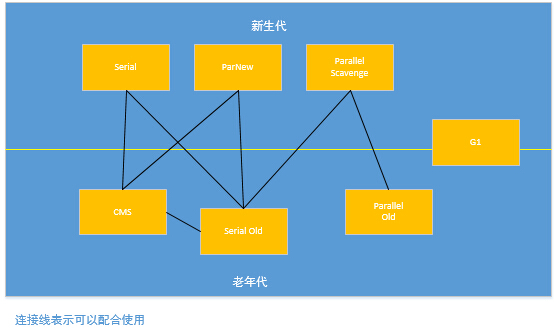
| **ParNew** | 多線程 | 複製 | 新生代 | Serial 多線程版,**唯一能與 CMS 配合**的新生代收集器 | Server 模式、需配合 CMS |
| **Parallel Scavenge** | 多線程 | 複製 | 新生代 | **關注吞吐量**,自適應調節(`-XX:+UseAdaptiveSizePolicy`) | 批處理、科學計算、後台任務 |
| **Parallel Old** | 多線程 | 標記-整理 | 老年代 | Parallel Scavenge 老年代版,**吞吐量優先組合** | 同上 |
| **CMS** | 多線程 | 標記-清除 | 老年代 | **關注低停頓**,四階段:初始標記(STW)→並發標記→重新標記(STW)→並發清除 | Web 服務、響應敏感應用 |
| **G1** | 多線程 | 標記-整理+複製 | 全堆 | **面向服務端**,Region 劃分、優先回收垃圾多區域、可預測停頓 | 大堆(>4GB)、多核、替代 CMS |
缺陷: 碎片化、並發階段佔用 CPU、浮動垃圾、對 CPU 敏感。
# 基礎堆設定
-Xms4g -Xmx4g -Xmn1.5g          # 固定堆大小,避免動態擴縮容抖動
-XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m

# 收集器組合選擇(二選一)
# 1. 吞吐量優先
-XX:+UseParallelGC -XX:+UseParallelOldGC
-XX:ParallelGCThreads=8
-XX:GCTimeRatio=19              # 吞吐量目標 95% (1/(1+19))

# 2. 低停頓優先 (JDK 8/11 推薦 G1)
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200        # 目標停頓 200ms
-XX:G1HeapRegionSize=16m        # Region 大小
-XX:InitiatingHeapOccupancyPercent=45  # 觸發混合 GC 堆佔比

# 通用優化
-XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/logs/gc.log
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/logs/dump.hprof
-XX:+UseStringDeduplication     # G1 字符串去重 (JDK 8u20+)
垃圾回收是 JVM 自動內存管理的基石。深入理解算法與收集器特性,結合業務負載特徵,通過 GC 日誌持續觀測與調優,才能構建高穩定、高性能的 Java 應用。