在上一篇文章中,我們手動編寫代碼實現了一個確定性有限狀態自動機(DFA),並用它來識別整數和浮點數。這個過程本質上就是詞法分析的核心:構造狀態機並驅動它識別輸入字符串。不過,那個狀態機是硬編碼在程序中的,實際上它對應著一組正則表達式:
D [0-9] 表示 0-9 的字符類{D}+ 表示由 0-9 構成的整數({D}+ | {D}*\.{D}+ | {D}+\.{D}*)(e{D}+)? 表示浮點數或科學計數法那麼,給定一個正則表達式,能否自動生成對應的有限狀態自動機?答案是肯定的。大多數正則表達式引擎內部都是先將正則轉換為自動機,再驅動自動機進行匹配。這幾節我們將重點講解如何用代碼實現「正則表達式 → NFA → DFA」的完整轉換流程。
有限狀態自動機分為 DFA(確定性有限自動機) 和 NFA(非確定性有限自動機)。
以正則 (and|any) 為例,其 DFA 和 NFA 結構差異明顯:
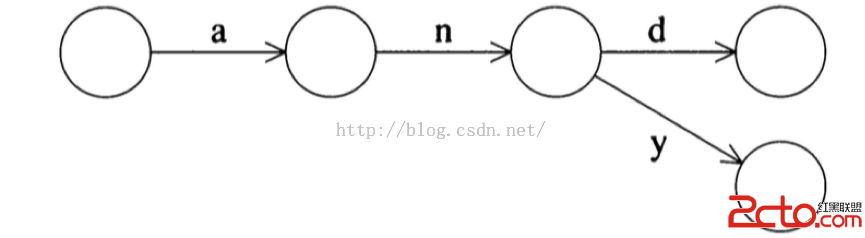
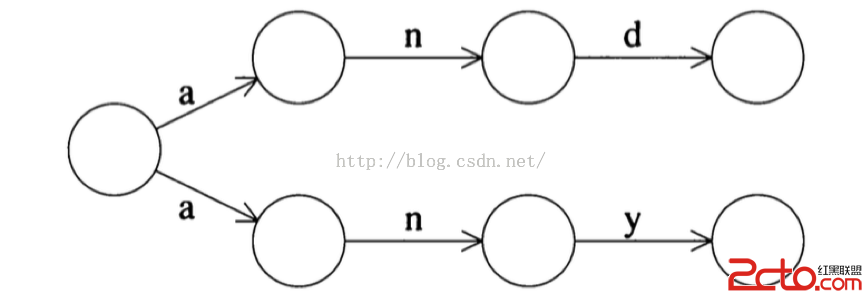
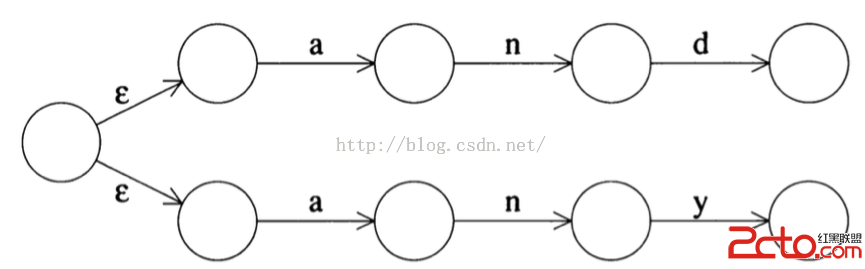
第二種帶 ε 轉移的 NFA 在程序中更易構造,因此我們採用此模式。NFA 雖然好構造,但難以直接驅動識別字符串(一個輸入可能對應多個下一狀態),通用做法是:正則 → NFA → DFA,後續文章將給出代碼實現。
Ken Thompson(Unix 合著者、B 語言作者)提出的算法遞歸定義了正則表達式到 NFA 的轉換規則:
a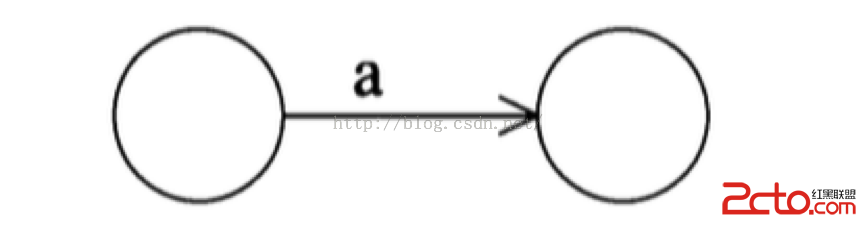
ab分別構造 a、b 的 NFA,再用一條 ε 邊首尾相連。
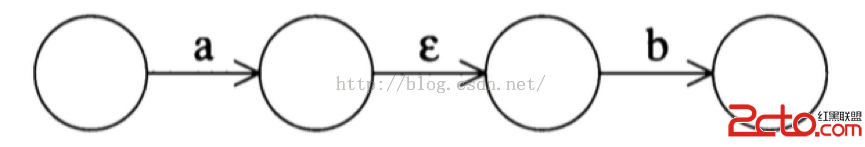
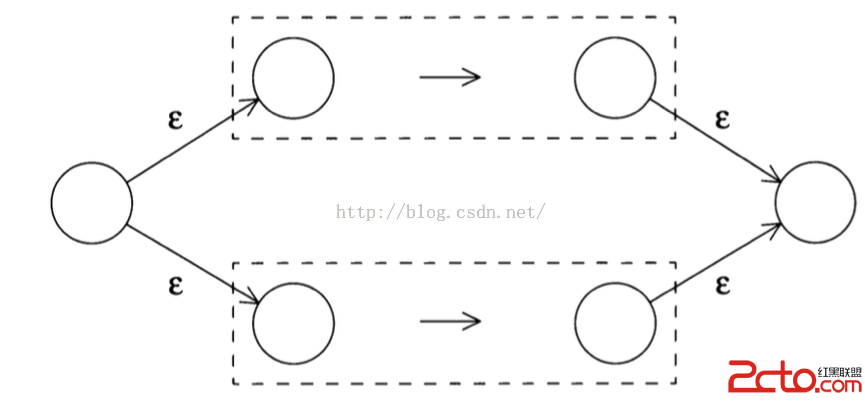
exp1 | exp2新建初始狀態和接受狀態,初始狀態分別 ε 連向兩個子 NFA 的起點,兩個子 NFA 的終點再各自 ε 連向接受狀態。
a|b 的具體圖示:
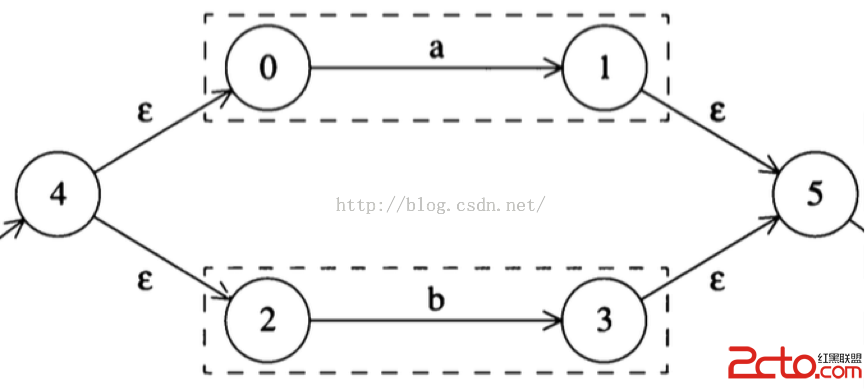
更複雜的 ((a|b)|cd) 同理遞歸組合:
exp*(0 次或多次):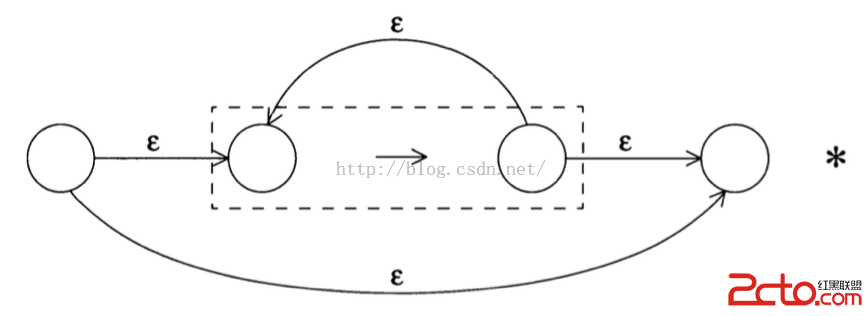
exp+(至少 1 次):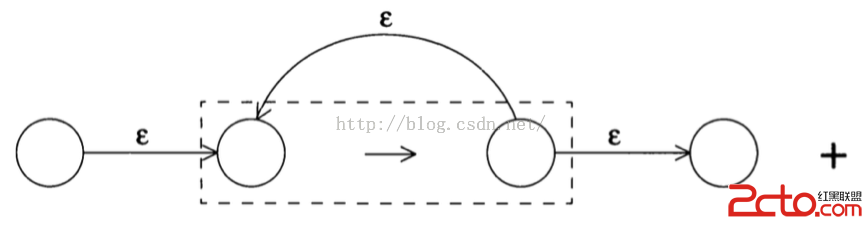
exp?(0 次或 1 次):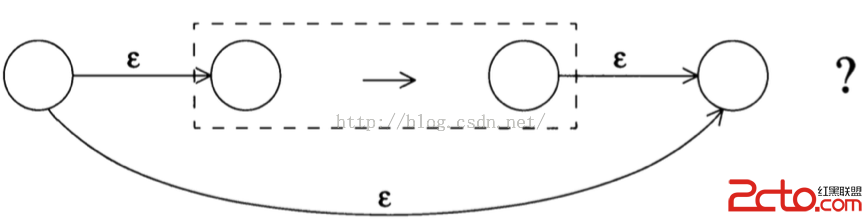
(D*\.D | D\.D*)步驟拆解:
D 的 NFA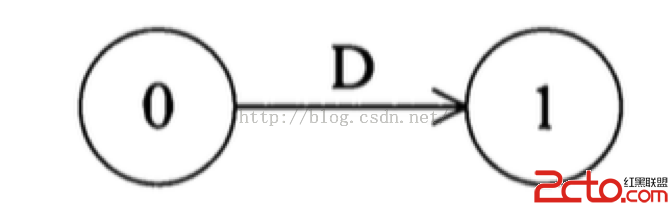
D*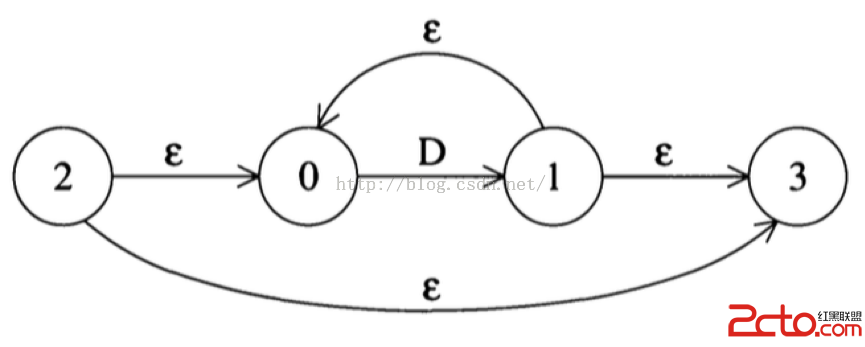
D*\.D(注意 . 需轉義)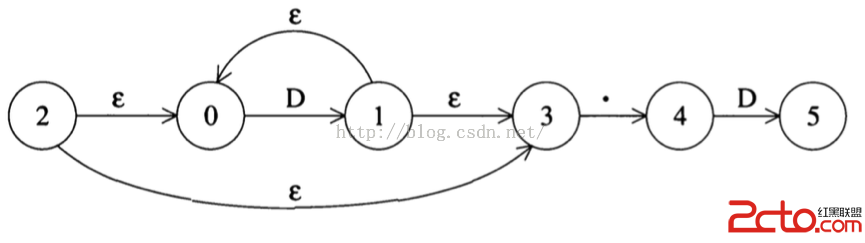
D\.D*(將上圖後半部分前移)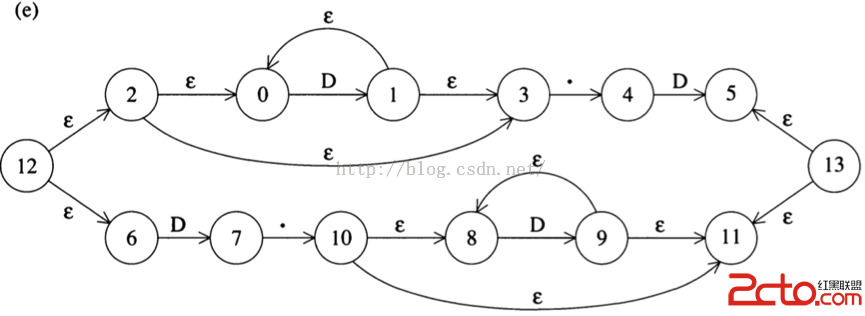
任何複雜正則表達式的 NFA 構造,本質上都是上述基礎規則的遞歸組合。下一節我們將上代碼實現這一算法。