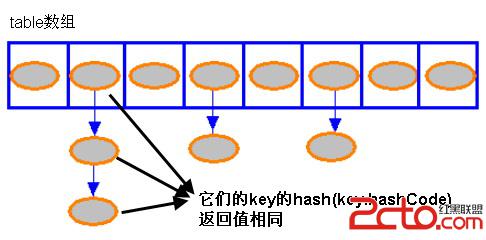
HashMap 底層維護一個 Entry[] table 數組 (JDK8 稱 Node[]),每個位置稱為 桶。每個 Entry 包含:key、value、hash、next (指向下一個 Entry,形成鏈表/紅黑樹)。
public V put(K key, V value) {
    if (key == null) return putForNullKey(value); // null key 固定放 table[0]

    int hash = hash(key.hashCode());           // 1. 計算 hash
    int i = indexFor(hash, table.length);      // 2. 定位桶索引

    // 3. 遍歷鏈表檢查 key 是否已存在
    for (Entry e = table[i]; e != null; e = e.next) {
        if (e.hash == hash && (e.key == key || key.equals(e.key))) {
            V old = e.value;
            e.value = value;
            e.recordAccess(this);
            return old; // 覆蓋舊值
        }
    }

    // 4. 不存在則頭插法添加新 Entry
    modCount++;
    addEntry(hash, key, value, i);
    return null;
} // 擾動函數:高低位混合,減少碰撞
static int hash(int h) {
h ^= (h >>> 20) ^ (h >>> 12);
return h ^ (h >>> 7) ^ (h >>> 4);
}
// 索引計算:length 為 2 的 n 次方,h & (length-1) 等價 h % length 但更快
static int indexFor(int h, int length) {
return h & (length - 1);
}
// 頭插法:新 Entry 指向舊頭節點,成為新頭
void addEntry(int hash, K key, V value, int bucketIndex) {
Entry e = table[bucketIndex];
table[bucketIndex] = new Entry<>(hash, key, value, e);
if (size++ >= threshold) resize(2 * table.length); // 擴容檢查
} public V get(Object key) {
if (key == null) return getForNullKey();
int hash = hash(key.hashCode());
for (Entry e = table[indexFor(hash, table.length)]; e != null; e = e.next) {
if (e.hash == hash && (e.key == key || key.equals(e.key)))
return e.value;
}
return null;
} 性能關鍵:理想情況 O(1) 直接定位;哈希衝突退化為 O(k) 鏈表遍歷 (k 為鏈長)。JDK8 引入紅黑樹將最壞情況優化為 O(log k)。
| 構造器 | 初始容量 | 負載因子 |
|---|---|---|
| HashMap() | 16 | 0.75 |
| HashMap(int initialCapacity) | ≥initialCapacity 的最小 2 次冪 | 0.75 |
| HashMap(int initialCapacity, float loadFactor) | 同上 | 指定值 (>0) |
int capacity = 1;
while (capacity < initialCapacity) capacity <<= 1; // 找到 ≥ initialCapacity 的最小 2 次冪
// 例:initialCapacity=10 → capacity=16threshold = capacity * loadFactor16 * 0.75 = 12 達到 12 個元素觸發首次擴容void resize(int newCapacity) {
Entry[] oldTable = table;
int oldCapacity = oldTable.length;
if (oldCapacity == MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return; }
Entry[] newTable = new Entry[newCapacity];
transfer(newTable); // 重新哈希遷移所有 Entry
table = newTable;
threshold = (int)(newCapacity * loadFactor);
}
void transfer(Entry[] newTable) {
for (Entry e : table) {
while (e != null) {
Entry next = e.next;
int i = indexFor(e.hash, newTable.length); // 重新計算索引
e.next = newTable[i]; // 頭插法 (注意:舊版本會導致鏈表倒序,並發下可能成環)
newTable[i] = e;
e = next;
}
}
} JDK8 優化:使用尾插法保持順序,避免並發擴容死循環;引入紅黑樹 (TreeNode) 當鏈長 ≥ 8 且容量 ≥ 64 時樹化。
| 參數 | 默認值 | 調優建議 |
|---|---|---|
| initialCapacity | 16 | 預估元素數量 / 0.75,避免頻繁擴容 (如預期 1000 個 → new HashMap<>(1365)) |
| loadFactor | 0.75 | 空間換時間:降低→查詢快但內存大;升高→省內存但查詢慢。一般不建議修改 |
hashCode() 和 equals()ConcurrentHashMap 或 Collections.synchronizedMapentrySet() 效率最高,避免 keySet() + get() 兩次查找// 高效遍歷模板
for (Map.Entry entry : map.entrySet()) {
K key = entry.getKey(); V value = entry.getValue();
// 業務邏輯
} HashMap 作為 Java 集合框架核心成員,其哈希分佈、衝突解決、動態擴容機制體現了經典的工程權衡思想。深入理解其原理,能避免生產環境常見的性能抖動、死循環、數據丟失等疑難雜症。