基於數組 + 鏈表 + 紅黑樹 實現 Map 接口,JDK 8 引入尾插法、紅黑樹化、擴容優化 大幅提升性能。本文從接口定義、四大構造器、哈希碼計算、put/get 核心流程、擴容遷移、樹化閾值、線程不安全根因全方位剖析。
| 接口/類 | 特點 |
|---|---|
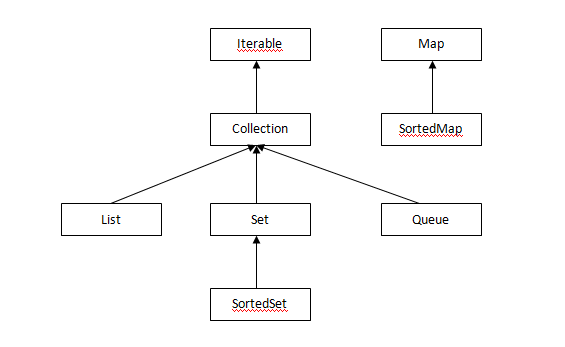
Map | 鍵值對集合,鍵唯一,值可重複 |
Map.Entry | 鍵值對實體,內部類 |
SortedMap | 鍵有序 |
HashMap | 哈希表,無序,允許 null 鍵/值,非線程安全 |
TreeMap | 紅黑樹,有序 |
Hashtable | 同步,舊 API,不允許 null |
ConcurrentHashMap | 高併發,分段鎖/CAS |
// 1. 默認:容量 16,負載因子 0.75
new HashMap<>();

// 2. 指定初始容量 (避免擴容)
new HashMap<>(int initialCapacity);

// 3. 指定容量+負載因子
new HashMap<>(int initialCapacity, float loadFactor);

// 4. 複製現有 Map
new HashMap<>(Map m);// JDK 8 靜態擾動函數
static final int hash(Object key) {
int h;
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
// 索引計算 (位運算替代取模,前提 capacity 是 2 的冪)
int index = (n - 1) & hash;原理:高 16 位參與低位運算,分散高位變化導致的碰撞。null 鍵固定放桶 0。
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
    Node[] tab; Node p; int n, i;
    // 1. 首次擴容/初始化
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;

    // 2. 計算桶索引,桶為空直接放入
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    else {
        Node e; K k;
        // 3. 鍵已存在 (hash 相等 + key equals) → 覆蓋值
        if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k))))
            e = p;
        // 4. 紅黑樹節點 → 樹插入
        else if (p instanceof TreeNode)
            e = ((TreeNode)p).putTreeVal(this, tab, hash, key, value);
        // 5. 鏈表節點 → 遍歷尾部尾插法插入
        else {
            for (int binCount = 0; ; ++binCount) {
                if ((e = p.next) == null) {
                    p.next = newNode(hash, key, value, null);
                    // 6. 達到樹化閾值 → 轉紅黑樹
                    if (binCount >= TREEIFY_THRESHOLD - 1)
                        treeifyBin(tab, hash);
                    break;
                }
                if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
                    e = e; break; // 找到覆蓋點
                }
                p = e;
            }
        }
        if (e != null) { // 覆蓋舊值
            V oldValue = e.value;
            if (!onlyIfAbsent) e.value = value;
            afterNodeAccess(e);
            return oldValue;
        }
    }
    ++modCount;
    if (++size > threshold) resize(); // 擴容檢查
    afterNodeInsertion(evict);
    return null;
} e.hash & oldCap 判斷高位變化,原地遷移或偏移 oldCap,無需重新計算 hash。public V get(Object key) {
Node e;
return (e = getNode(hash(key), key)) == null ? null : e.value;
}
final Node getNode(int hash, Object key) {
Node[] tab; Node first, e; int n; K k;
if ((tab = table) != null && (n = tab.length) > 0 &&
(first = tab[(n - 1) & hash]) != null) {
// 桶首節點直接命中
if (first.hash == hash && ((k = first.key) == key || (key != null && key.equals(k))))
return first;
// 紅黑樹查找
if ((e = first.next) != null) {
if (first instanceof TreeNode)
return ((TreeNode)first).getTreeNode(hash, key);
// 鏈表遍歷
do {
if (e.hash == hash && ((k = e.key) == key || key.equals(k)))
return e;
} while ((e = e.next) != null);
}
}
return null;
} final Node[] resize() {
Node[] oldTab = table;
int oldCap = (oldTab == null) ? 0 : oldTab.length;
int oldThr = threshold;
int newCap, newThr = 0;
if (oldCap > 0) {
if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; }
newCap = oldCap << 1; // 翻倍
newThr = oldThr << 1;
} else if (oldThr > 0) {
newCap = oldThr;
} else {
newCap = DEFAULT_INITIAL_CAPACITY;
newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
}
threshold = newThr;
@SuppressWarnings({"rawtypes","unchecked"})
Node[] newTab = (Node[])new Node[newCap];
table = newTab;
if (oldTab != null) {
// 遷移每個桶
for (int j = 0; j < oldCap; ++j) {
Node e = oldTab[j];
if (e != null) {
oldTab[j] = null; // 釋放引用
if (e.next == null) // 單節點直接遷移
newTab[e.hash & (newCap - 1)] = e;
else if (e instanceof TreeNode) // 紅黑樹拆分遷移
((TreeNode)e).split(this, newTab, j, oldCap);
else { // 鏈表拆分遷移 (JDK 8 核心優化)
Node loHead = null, loTail = null;
Node hiHead = null, hiTail = null;
Node next;
do {
next = e.next;
if ((e.hash & oldCap) == 0) { // 高位不變 → 留原索引
if (loTail == null) loHead = e;
else loTail.next = e;
loTail = e;
} else { // 高位變化 → 索引 + oldCap
if (hiTail == null) hiHead = e;
else hiTail.next = e;
hiTail = e;
}
} while ((e = next) != null);
if (loTail != null) { loTail.next = null; newTab[j] = loHead; }
if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; }
}
}
}
}
return newTab;
} e.hash & oldCap 判斷擴容前後高位是否變化:
j (低位組合不變)。j + oldCap (高位多出 1,索引偏移舊容量)。單次遍歷即可完成拆分,**無需重新計算 hash**,性能大幅提升。
TreeNode 繼承 Node,增加 parent/left/right/red 字段。binCount >= 8 且 capacity >= 64。<= 6。newNode 覆蓋。size++ 非原子。結論:多線程環境**必須用 ConcurrentHashMap**,HashMap 絕不裸用。
HashMap = 數組 + 鏈表/紅黑樹,JDK 8 關鍵優化:**尾插法保序、擴容拆分無需重算 hash、樹化防退化**。掌握 hash() 擾動、putVal 覆蓋/插入/樹化邏輯、resize 高位判斷拆分、getNode 雙路徑查找,即通透底層。面試必會:**擴容機制、樹化閾值、JDK 7/8 差異、線程不安全根因、ConcurrentHashMap 對比**。