Hive 本質上是一個分布式數據倉庫,同時具備查詢引擎功能。在企業級應用中,常見架構為 Hive + Spark SQL:Hive 負責廉價海量數據存儲與元數據管理,Spark SQL 則接管高性能計算任務。
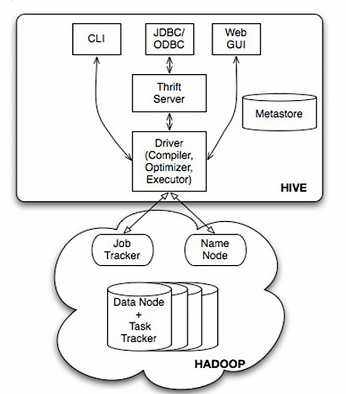
預設使用 Derby 存儲元數據,生產環境強建議遷移至 MySQL 等多用戶資料庫,支援讀寫分離與備份策略(主節點寫入、從節點讀取)。
| 組件 | 核心職責 |
|---|---|
| Hive | 廉價海量數據倉庫存儲 |
| Spark SQL | 高速分布式計算引擎 |
| DataFrame | 複雜數據挖掘與進階分析 |
| 特性 | RDD | DataFrame |
|---|---|---|
| 數據抽象 | 分布式物件集合 | 分布式表結構 |
| 優化基礎 | 基於行的優化 | 基於列的優化(含 Metadata) |
| Schema 感知 | 無 | 完整 Schema 資訊 |
| 催化優化器 | 不支援 | 深度整合 Catalyst 優化器 |

現代數據倉庫架構建議採用 Hive (存儲) + Spark SQL (計算) + DataFrame (分析) 三層架構,充分發揮各組件優勢:Hive 低成本存儲 PB 級數據,Spark SQL 秒級查詢響應,DataFrame 無縫對接 MLlib/GraphX 進行進階分析。