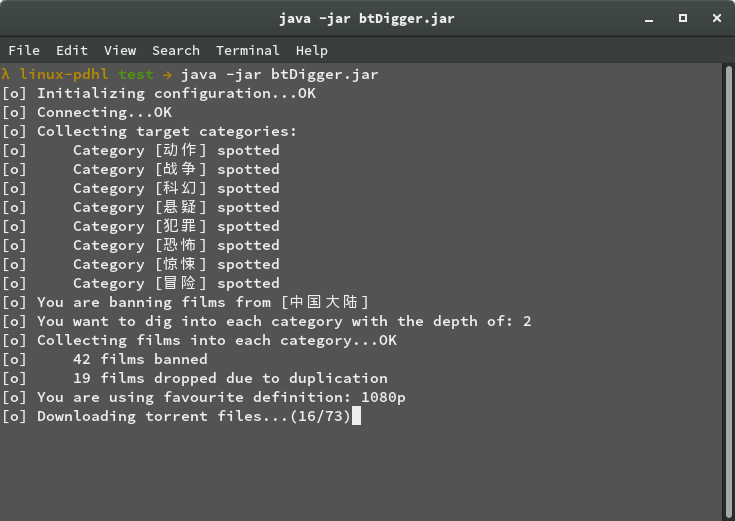
每次想看電影卻發現種子庫空空如也?每天逛 BT 站篩選優質資源耗時費力?本文介紹一款基於 Java 開發的電影種子自動挖掘器(btDigger),支持通過 JSON 配置文件靈活定義抓取規則:指定電影分類、畫質偏好、地區過濾、翻頁深度等,自動去重、下載種子文件。項目已開源於 GitHub,歡迎共建。
config.json 即可調整抓取策略。{
"regions-banned": ["中國大陸"],
"depth": "2",
"definition": "1080p",
"categories": [
"動作", "戰爭", "科幻", "懸疑",
"犯罪", "恐怖", "驚悚", "冒險"
]
}
字段含義:
regions-banned:屏蔽產地列表,種子詳情頁包含該關鍵字即跳過。depth:分類頁翻頁深度,2 表示抓取前 2 頁。definition:首選畫質標識,解析種子列表時優先匹配。categories:目標分類名稱,需與目標站點(bt天堂)分類標題完全一致。採用單例模式確保全局唯一配置實例,使用 org.json 解析 JSON,將屬性映射到類成員變量,提供靜態獲取方法供各模塊調用。
class ConfigLoader {
    private static ConfigLoader configLoader = null;
    private static final String FILE_NAME = "config.json";
    private static ArrayList<String> regions_banned = new ArrayList<>();
    private static ArrayList<String> categories = new ArrayList<>();
    private static int depth;
    private static String definition;

    private ConfigLoader() { /* 解析 JSON 賦值 */ }
    static synchronized ConfigLoader getInstance() { /* 雙重檢查鎖單例 */ }
    // Getter 方法...
}
利用 Jsoup 解析首頁 HTML,定位 class="Btitle" 的 div 標籤,提取 a 標籤文本與 categories 列表比對,匹配成功則保存其 href 作為該分類的入口 URL。
Elements bTitles = document.select("div[class=\"Btitle\"]");
for (Element each : bTitles) {
    Element thisCategory = each.select("a").first();
    if (!categories.contains(thisCategory.text())) continue;
    targetCategoriesSubURLs.add(thisCategory.attr("href"));
    System.out.println("[o] Category [" + thisCategory.text() + "] spotted");
}
遍歷每個分類 URL,按深度拼接頁碼(如 /category.php?/動作/1/、/2/)。解析 class="title" 的 div,提取電影標題(font 標籤文本)與詳情頁鏈接(a.href)。
雙重過濾邏輯:
class="des" 的 p 標籤文本是否包含禁用區域關鍵字。validFilmTitles 列表,新電影標題若已存在則判定為重複丟棄。for (String each : targetCategoriesSubURLs) {
for (int i = 1; i <= depth; i++) {
Document doc = Jsoup.parse(new URL(HOST + each + i), 5000);
Elements filmTitles = doc.select("div[class=\"title\"]");
for (Element film : filmTitles) {
String title = film.select("font").text();
// 區域檢查
boolean banned = config.getRegions_banned().stream()
.anyMatch(loc -> film.select("p[class=\"des\"]").text().contains(loc));
// 重複檢查
boolean duplicated = validFilmTitles.contains(title);
if (!banned && !duplicated) {
validFilmTitles.add(title);
validFilmSubURLs.add(film.select("a").first().attr("href"));
}
}
}
}
進入電影詳情頁,定位 class="tinfo" 的 div 遍歷種子列表。每個種子條目包含畫質標識(如【1080p高清】)、下載鏈接參數(arcid、uhash)。
畫質匹配策略:按配置優先級查找,找到目標畫質(如 1080p)立即跳出循環;若未找到則默認選擇列表中第一個(通常為最高畫質)。
for (Element link : btFileLinks) {
    String quality = link.select("span[class=\"video\"]").first().text();
    if (quality.contains(config.getDefinition())) {
        targetBtFileLinkSuffix = link.select("a").first().attr("href");
        break; // 命中優先畫質,停止搜索
    }
    targetBtFileLinkSuffix = link.select("a").first().attr("href"); // 兜底
}
POST 下載種子:訪問下載頁面,從 JS 變量 var _arcid、var _uhash 提取參數,構造 action=download&id=...&uhash=... 發送 POST 請求,將響應流寫入 {uhash}.torrent 文件。