記錄一次在 VirtualBox 中搭建 Hadoop 2.7.1 三節點叢集(1 Master + 2 Slave)的完整流程,採用「先配好一台 → 複製虛擬機 → 調整網路/主機名/SSH」的高效策略,避開常見坑點(JDK 位數、原生庫、權限、防火牆)。
libhadoop.so 無法載入,編譯極其耗時。core-site.xml/hdfs-site.xml/yarn-site.xml/mapred-site.xml、masters/slaves,再克隆。sudo chown -R hadoop:hadoop /opt/hadoop(依實際用戶調整)。service iptables stop、setenforce 0。.tar.gz.tar.gz/opt,建立軟連結 /opt/jdk、/opt/hadoop。~/.bashrc 設定環境變數:export JAVA_HOME=/opt/jdk
export HADOOP_HOME=/opt/hadoop
export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin$HADOOP_HOME/etc/hadoop/):# core-site.xml
fs.defaultFS hdfs://master:9000 hadoop.tmp.dir /opt/hadoop/tmp
# hdfs-site.xml
dfs.replication 2 dfs.namenode.name.dir /opt/hadoop/dfs/name dfs.datanode.data.dir /opt/hadoop/dfs/data
# yarn-site.xml
yarn.resourcemanager.hostname master yarn.nodemanager.aux-services mapreduce_shuffle
# mapred-site.xml (cp mapred-site.xml.template)
mapreduce.framework.name yarn
# masters
master
# slaves
slave1
slave2slave1、slave2。/etc/hostname:master、slave1、slave2。/etc/hosts:192.168.56.101 master
192.168.56.102 slave1
192.168.56.103 slave2# 在 master 上執行
ssh-keygen -t rsa -P '' # 一路 Enter
ssh-copy-id hadoop@master
ssh-copy-id hadoop@slave1
ssh-copy-id hadoop@slave2
# 驗證
ssh slave1 # 應直接登入無需密碼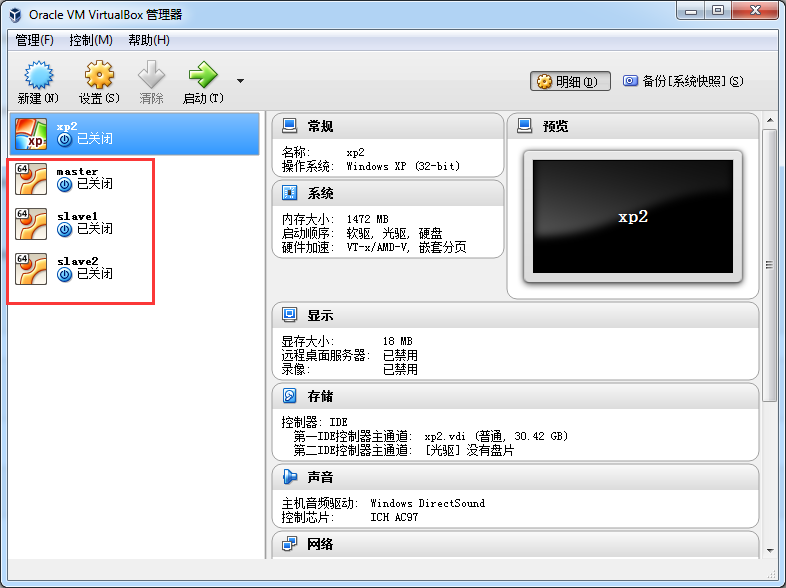
# 僅首次執行
hdfs namenode -format

# 啟動所有服務(HDFS + YARN)
start-all.sh
# 或分開啟動(推薦)
start-dfs.sh
start-yarn.sh# master
5858 ResourceManager
5706 SecondaryNameNode
5514 NameNode
6108 Jps
# slave1
3786 Jps
3646 NodeManager
3535 DataNode
# slave2
3796 Jps
3621 NodeManager
3510 DataNodehttps://master:50070(查看 DataNode 狀態、區塊分布)https://master:8088(查看 NodeManager、應用提交)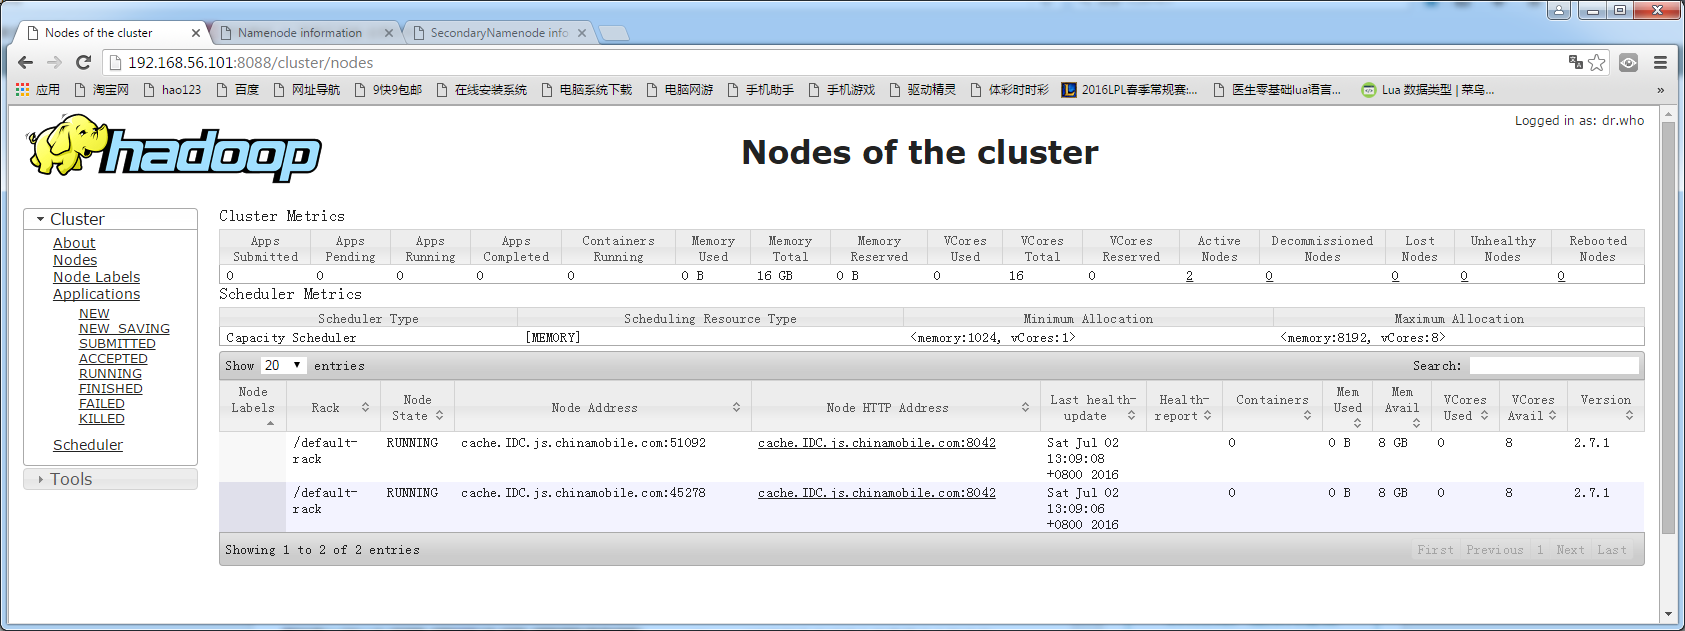
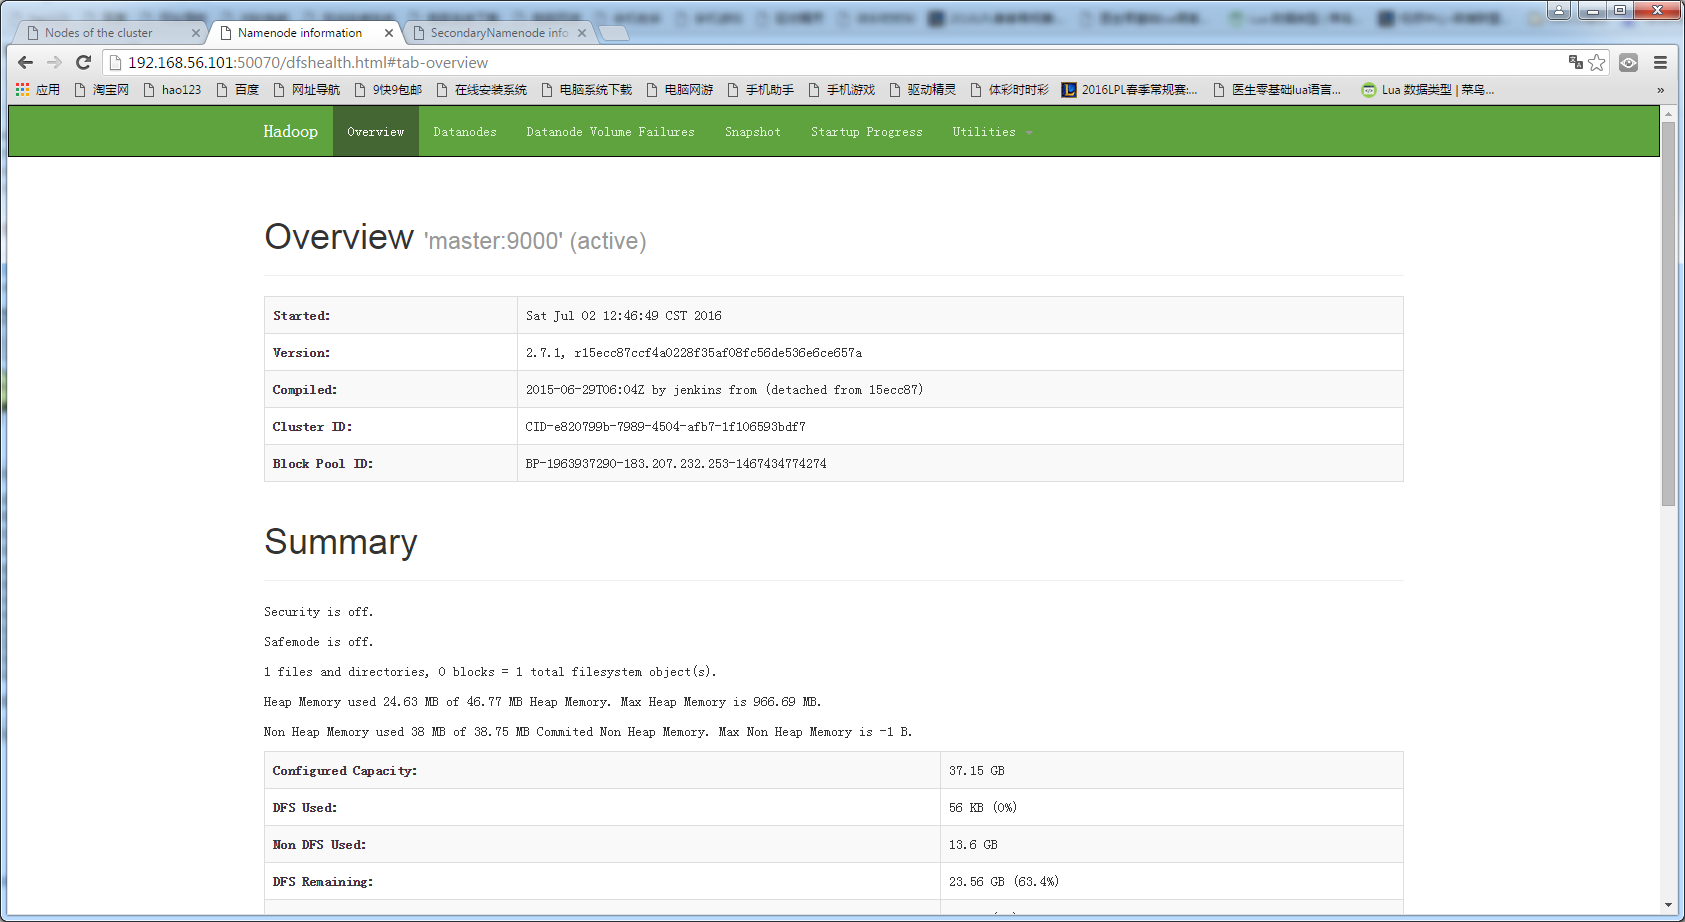
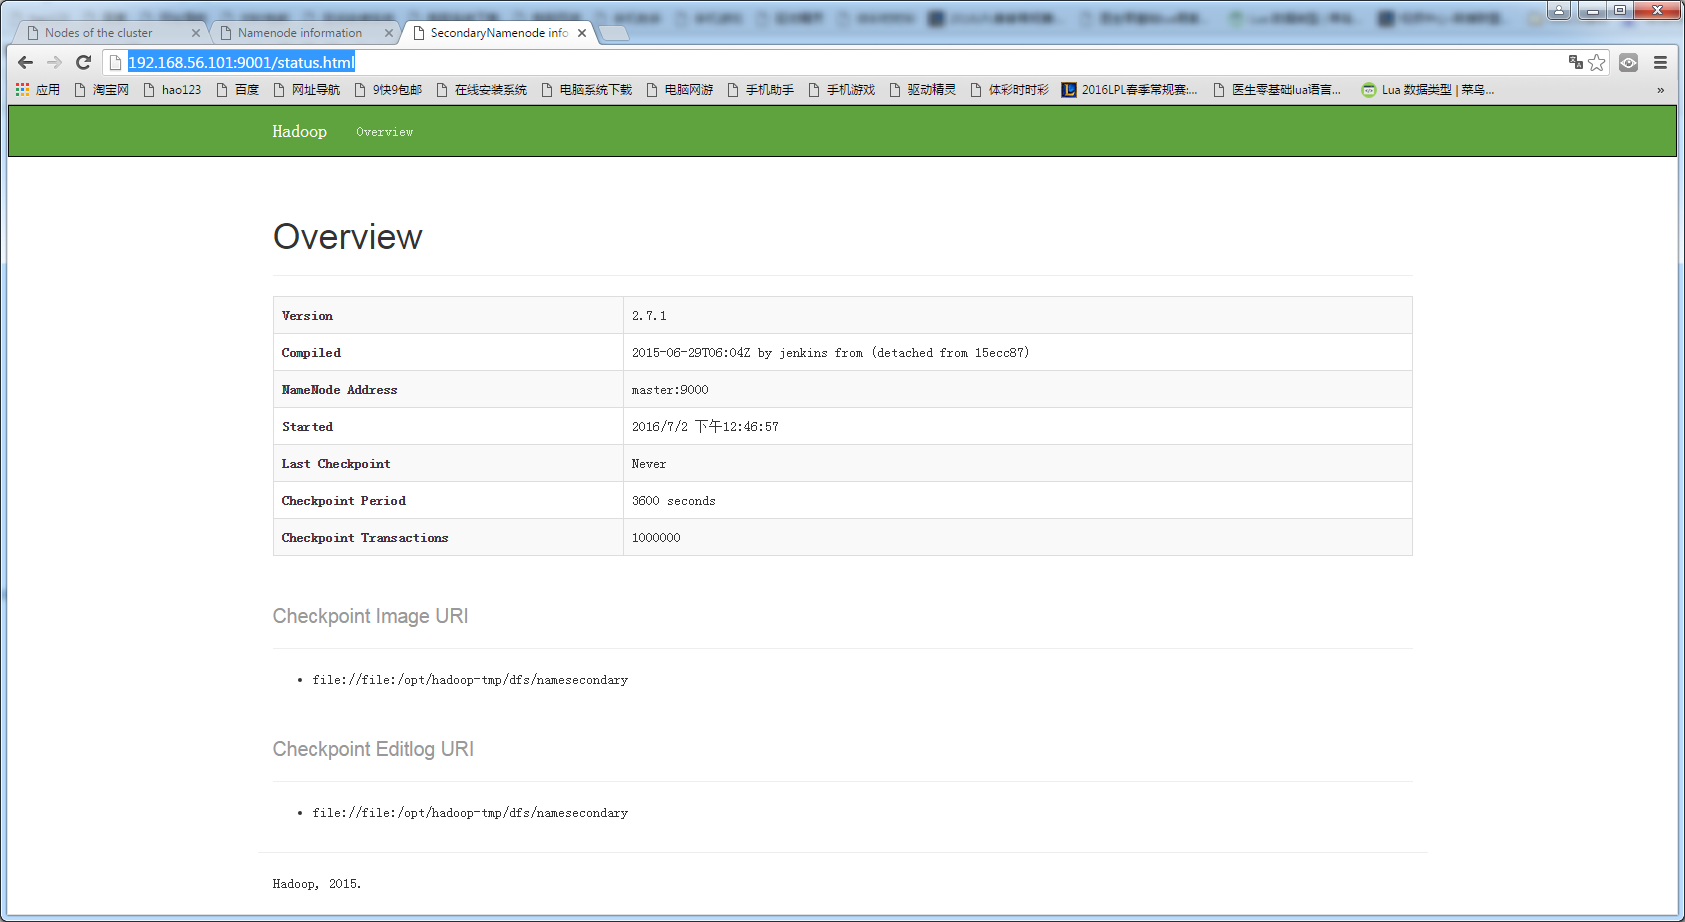
| 現象 | 可能原因 | 解決 |
|---|---|---|
| DataNode 啟動即停 | hostname/hosts 不匹配、防火牆、SSH 不通 | 檢查 hosts、關閉防火牆、驗證 SSH |
| NameNode 格式化失敗 | 目錄權限、磁碟空間、tmp 目錄殘留 | 刪除 tmp/dfs 目錄重試、確認權限 |
| 原生庫警告 | 32 位 JDK | 換裝 64 位 JDK |
| Web UI 打不開 | 端口未開放、綁定 0.0.0.0 | 配置 dfs.namenode.http-address、防火牆 |
「單機配妥 → 複製 → 改網路/主機名/SSH」是搭建 Hadoop 叢集最高效的路徑。關鍵在於 JDK 64 位、hosts 互解、SSH 免密、目錄權限 四大基石。驗證以 jps 進程齊全 + Web UI 可訪問為準。後續可擴展至 HA、Federation、Kerberos 安全模式等進階架構。