專案需對數千條敏感詞進行過濾。經方案對比:
DFA(Deterministic Finite Automaton):有限狀態集合、狀態轉移邊(邊標記符號)、唯一初態、若干終態。關鍵特性:同一狀態不會有兩條相同符號的出邊,即「確定性」。
簡化理解:Event + CurrentState = NextState。系統包含有限節點,輸入字符決定路由跳轉至下一節點。
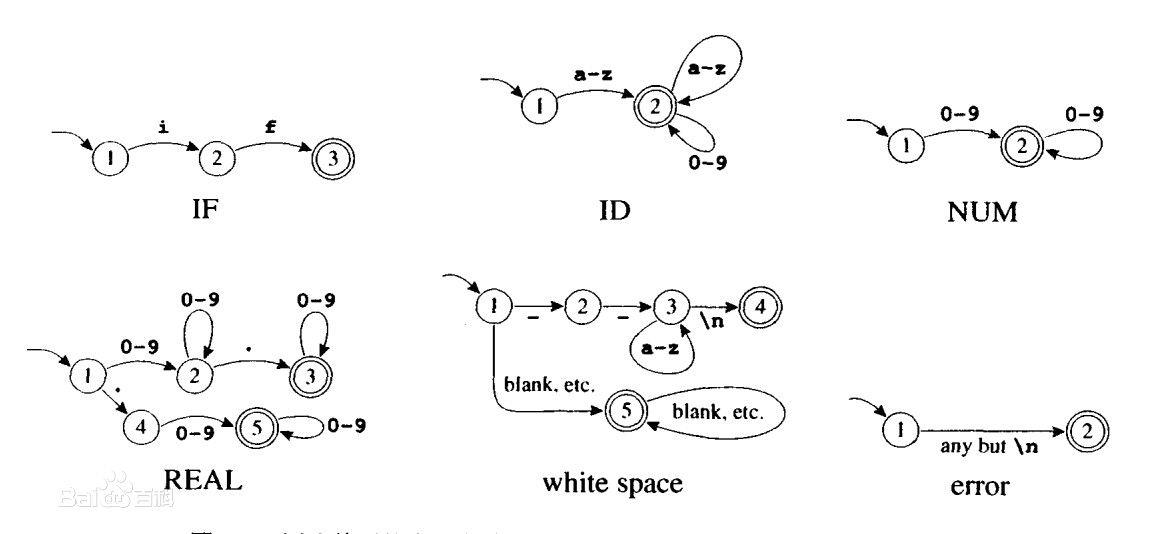
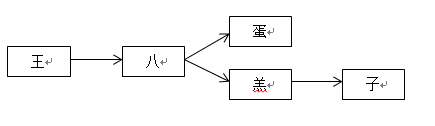
共用前綴「王八」,分支於「蛋」「羔子」。終態節點標記isEnd=true。
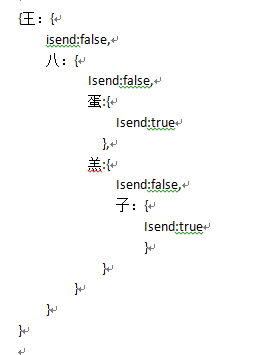
// 結構示例
Map<Character, Map> root = new HashMap<>();
// 「王」→「八」→{"蛋":{isEnd:true}, "羔"→"子":{isEnd:true}}
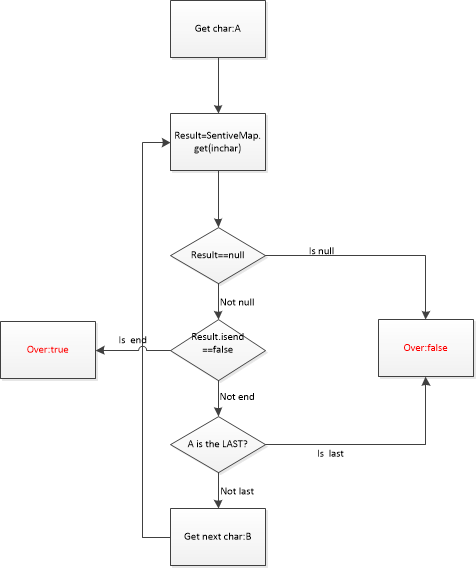
核心邏輯:指針不回退,狀態機單向流動,保證O(n)掃描。
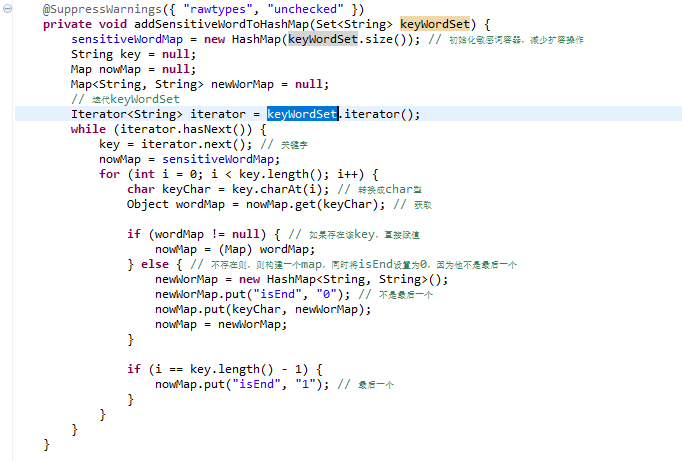
public void addSensitiveWord(String word) {
    Map nowMap = sensitiveWordMap;
    for (int i = 0; i < word.length(); i++) {
        char key = word.charAt(i);
        Map nextMap = (Map) nowMap.get(key);
        if (nextMap == null) {
            nextMap = new HashMap();
            nextMap.put("isEnd", "0");
            nowMap.put(key, nextMap);
        }
        nowMap = nextMap;
        if (i == word.length() - 1) nowMap.put("isEnd", "1");
    }
}
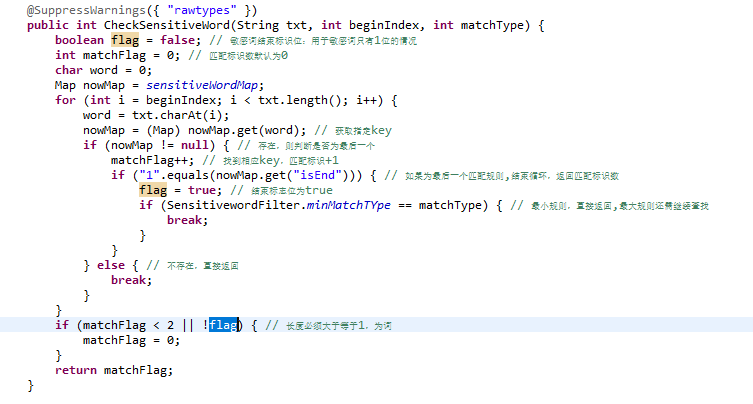
public Set<String> getSensitiveWords(String text) {
    Set<String> result = new HashSet<>();
    for (int i = 0; i < text.length(); i++) {
        int matchLen = checkSensitiveWord(text, i);
        if (matchLen > 0) {
            result.add(text.substring(i, i + matchLen));
            i += matchLen - 1; // 跳過已匹配部分
        }
    }
    return result;
}
檢測循環中維護停用詞集合(標點、特殊符號、零寬字符等),遇停用詞跳過不推進狀態機,僅移動文本指針,保持當前節點不變。
兩條路徑:
現階段雙方案並行,長期需引入NLP語義分析徹底解決。
DFA算法以空間換時間,構建Trie狀態機實現單次掃描多模式匹配,是敏感詞過濾的經典選型。工程落地需關注:內存佔用優化(雙數組Trie/AC自動機)、干擾字符處理、變體識別擴展。代碼結構清晰,易於維護與水平擴展。