在掌握了 HashMap(哈希表)與 HashSet 之後,我們發現它們雖然查找極快(O(1)),卻無法保持元素順序。當業務需要「有序遍歷」「範圍查詢」「查找最值」時,排序二叉樹及其平衡變體(AVL 樹、紅黑樹)便成為首選。本文系統梳理其核心概念、基本算法與工程化演進。
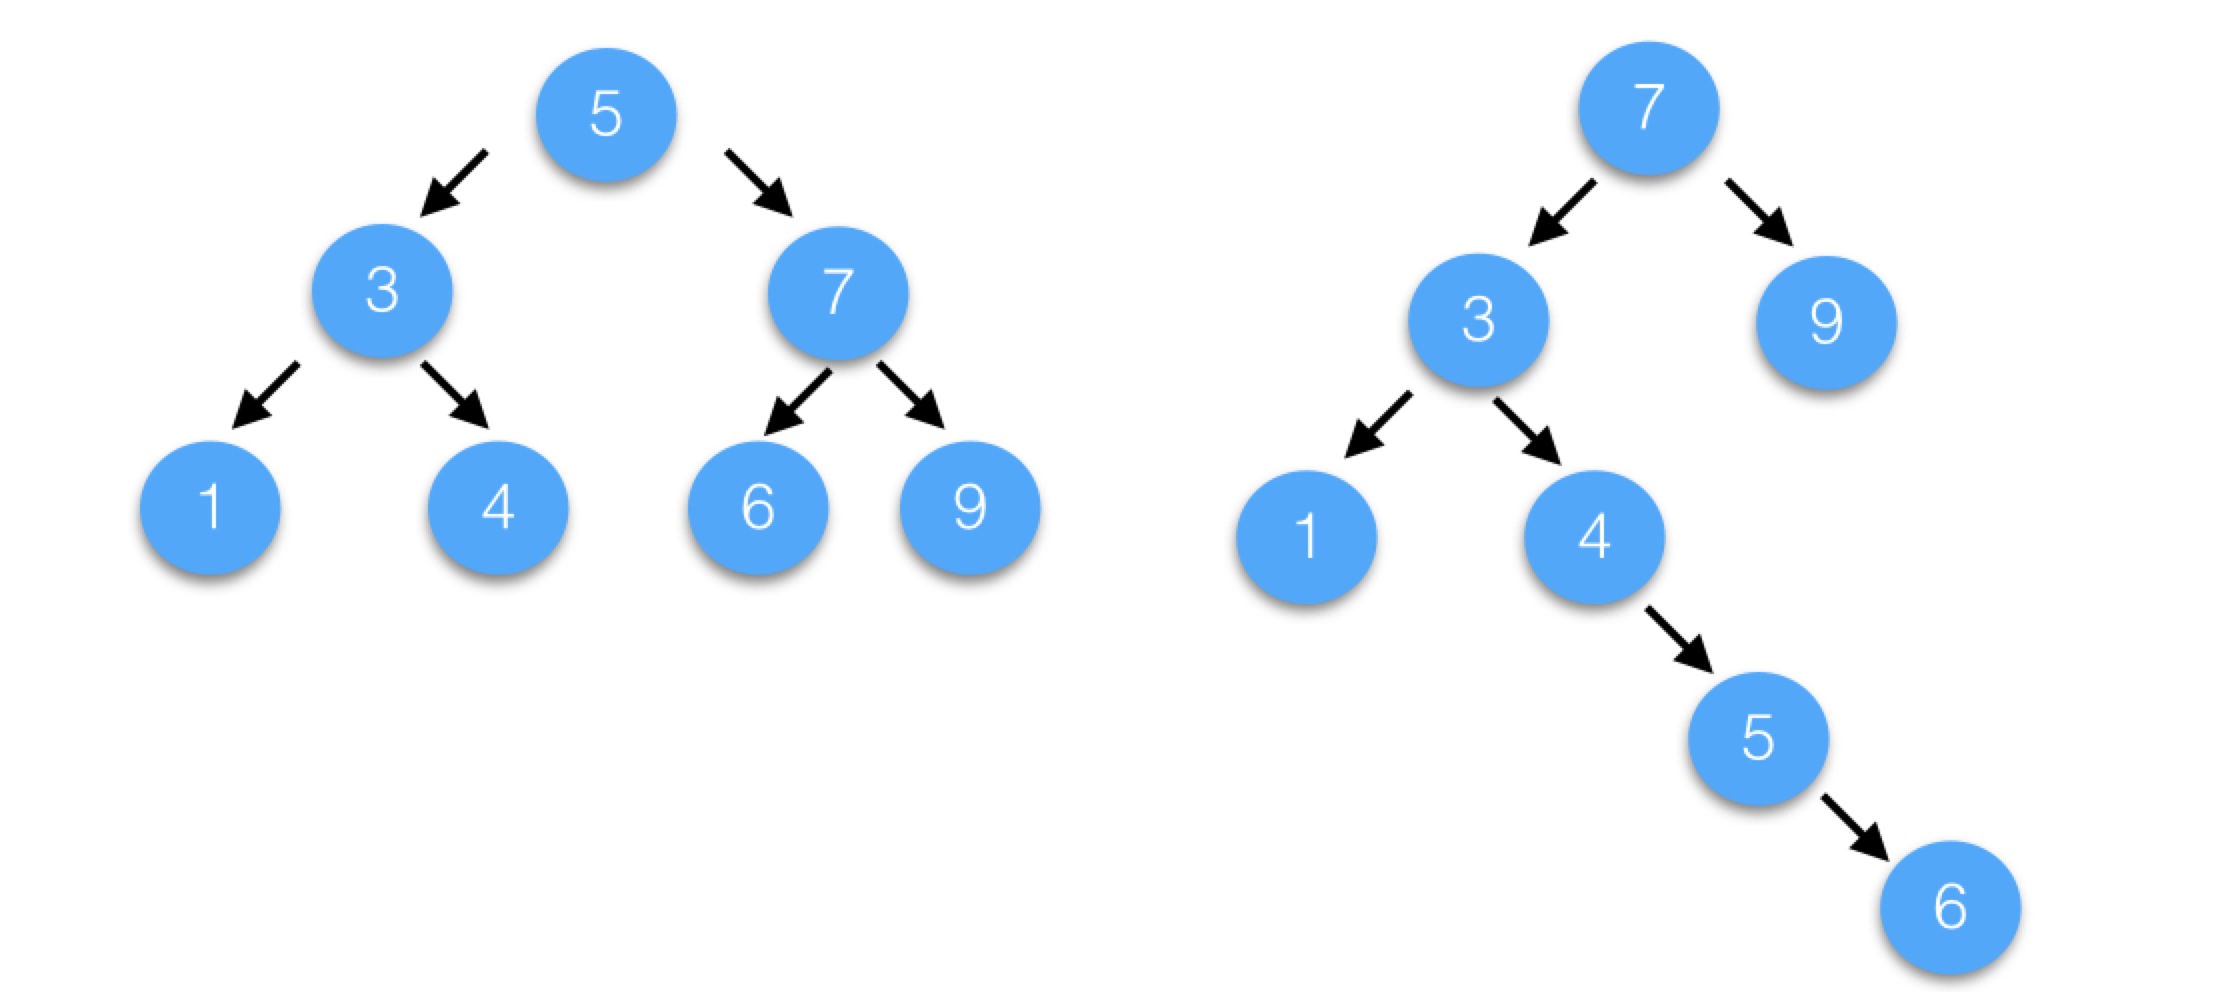
從根節點開始:
  若目標值 == 當前節點值 → 找到
  若目標值 < 當前節點值 → 進左子樹
  若目標值 > 當前節點值 → 進右子樹
  直到找到或走到 null
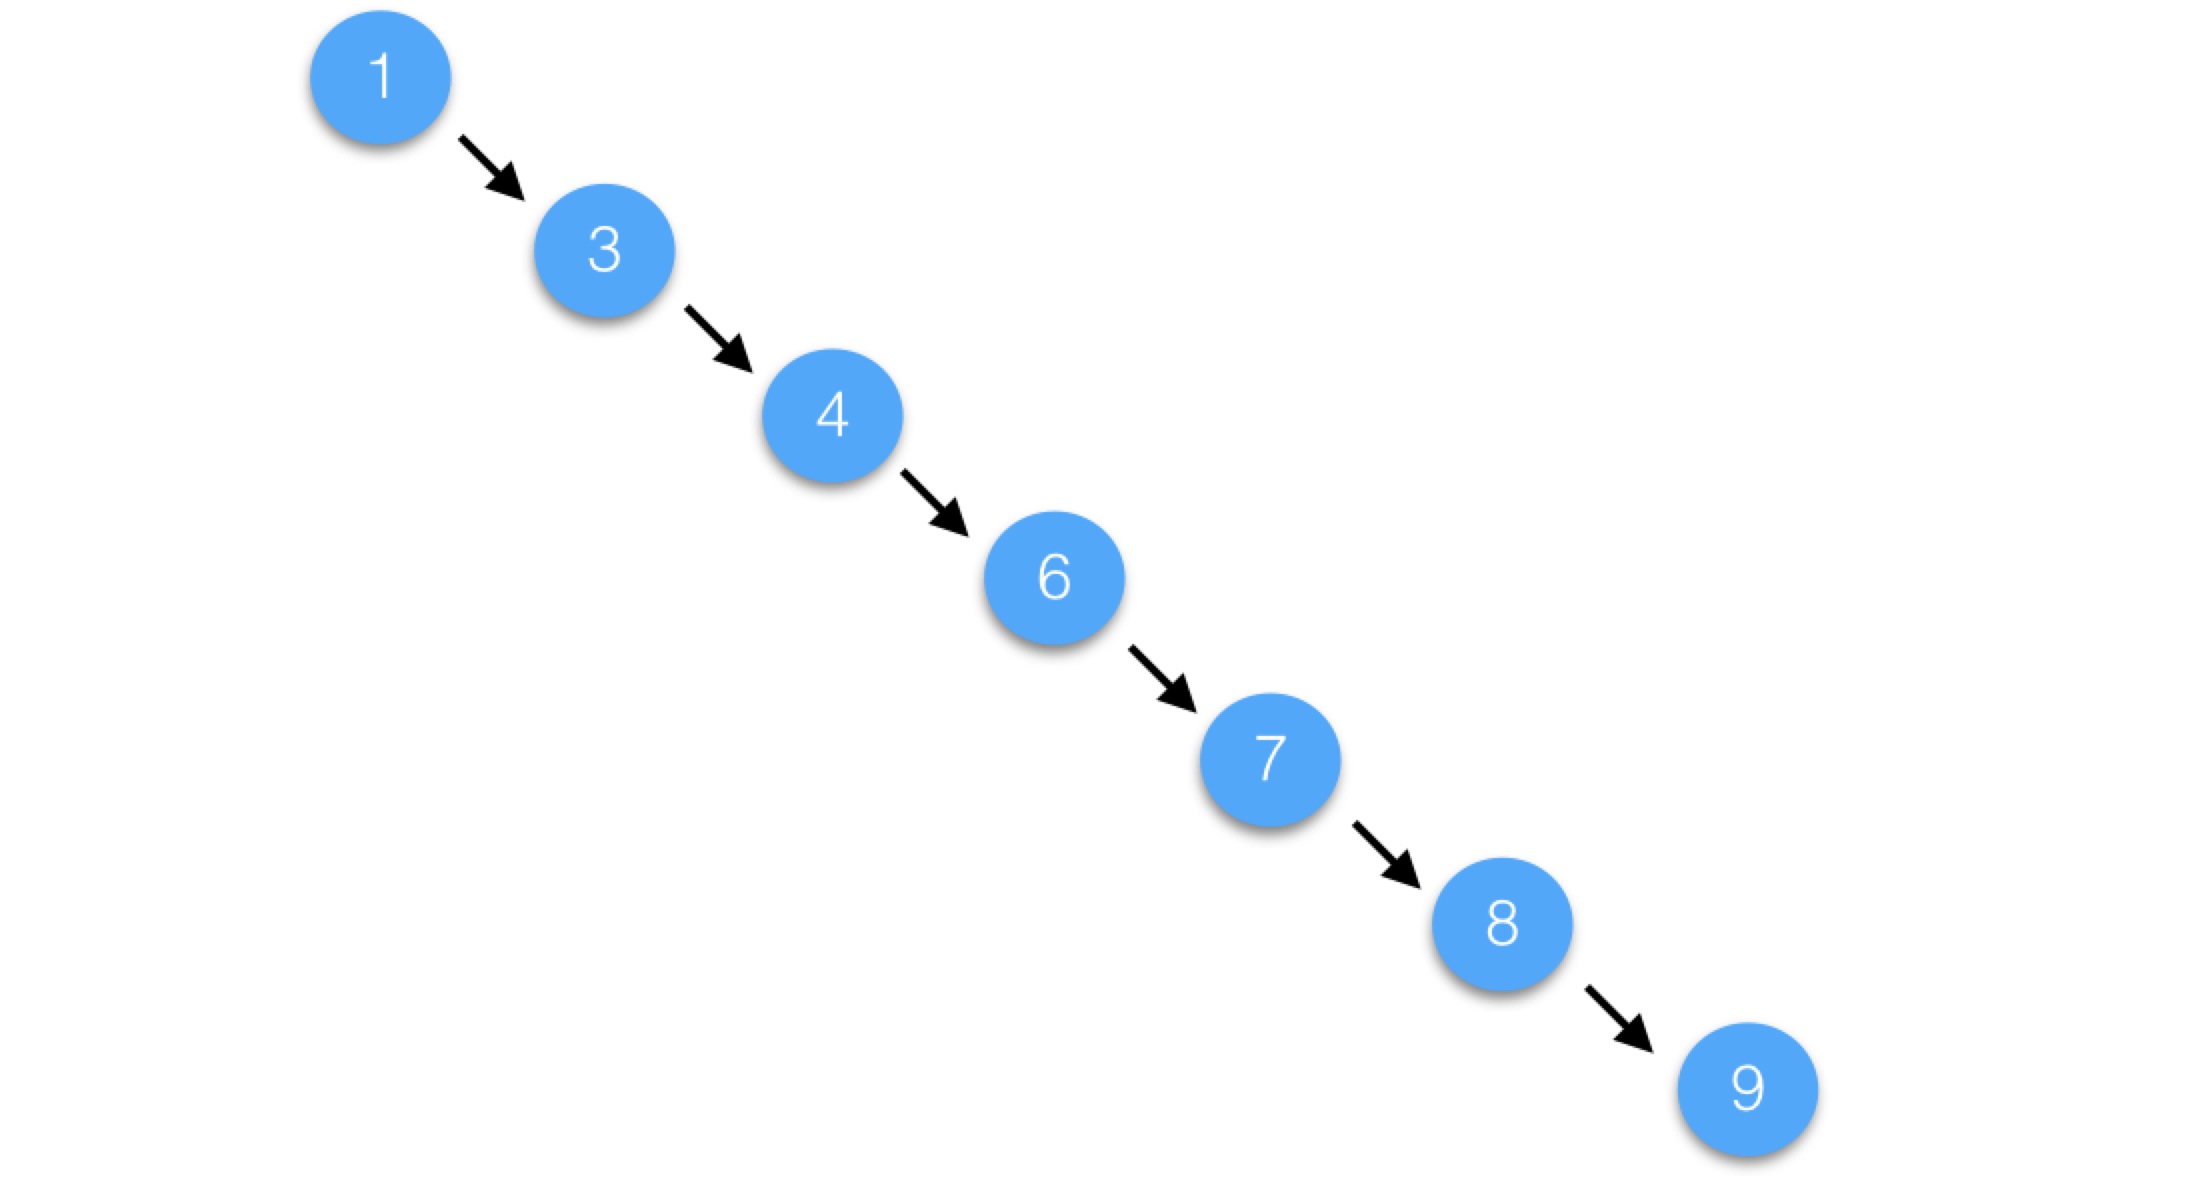
若樹平衡(h ≈ log₂N),查找極快;若退化成鏈表(h = N),效率驟降。
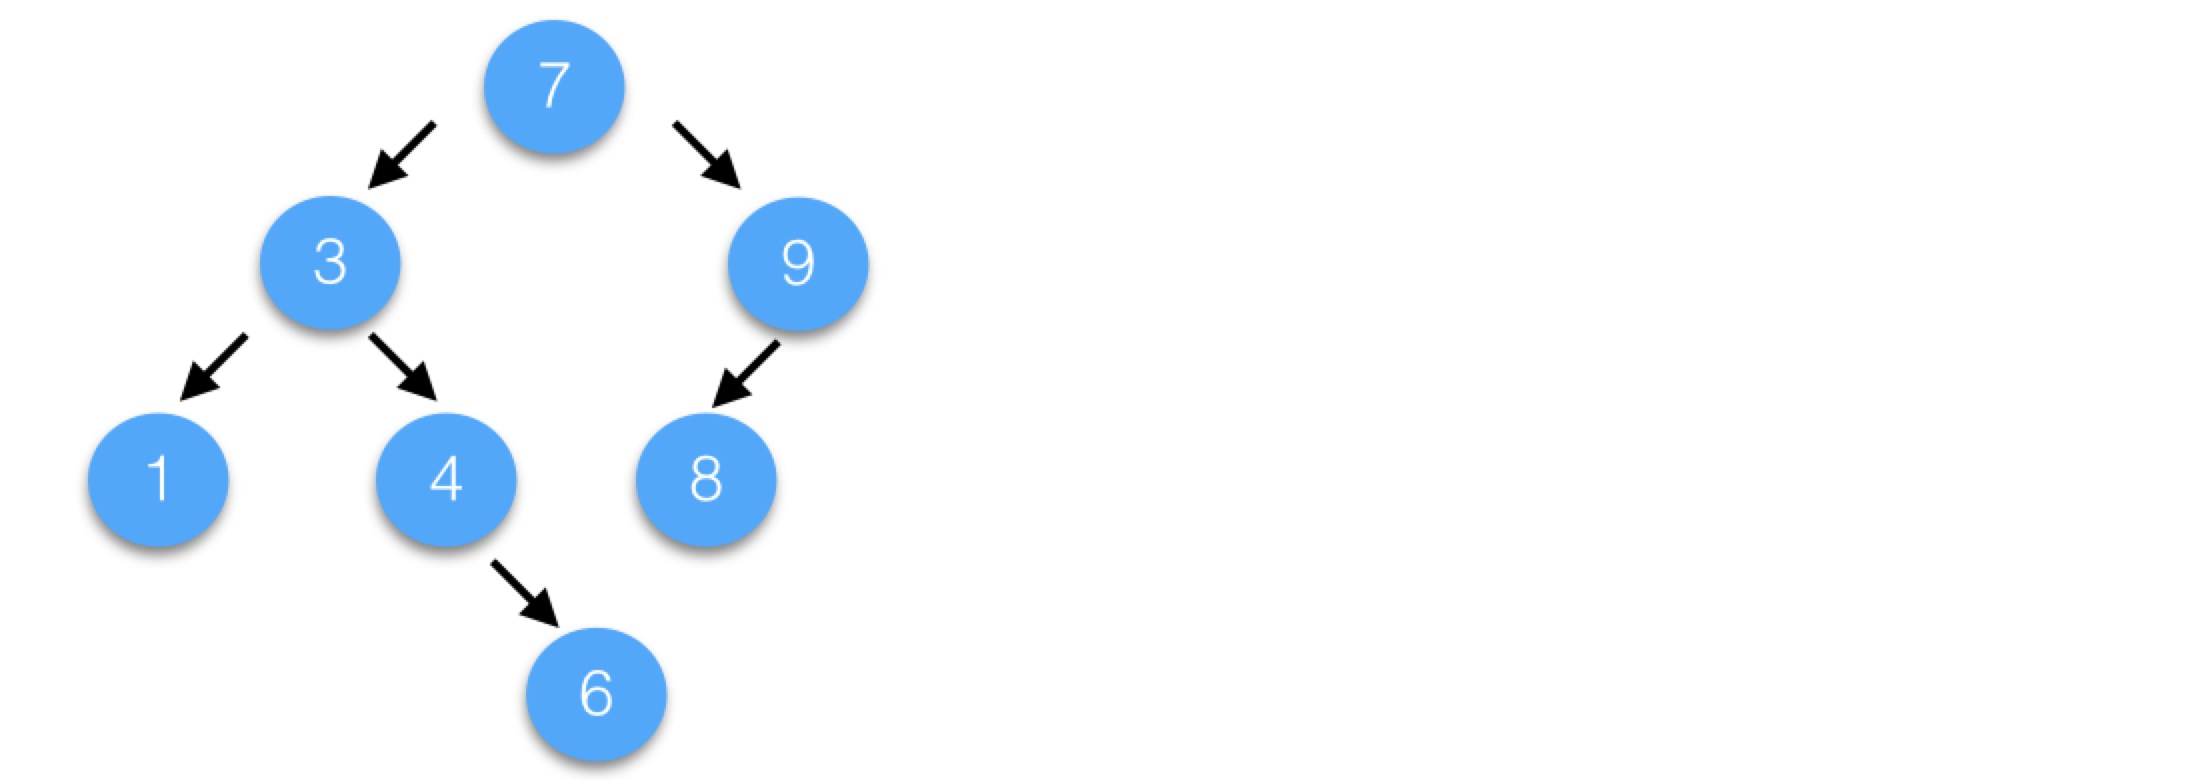
inOrder(node):
  if node == null: return
  inOrder(node.left)
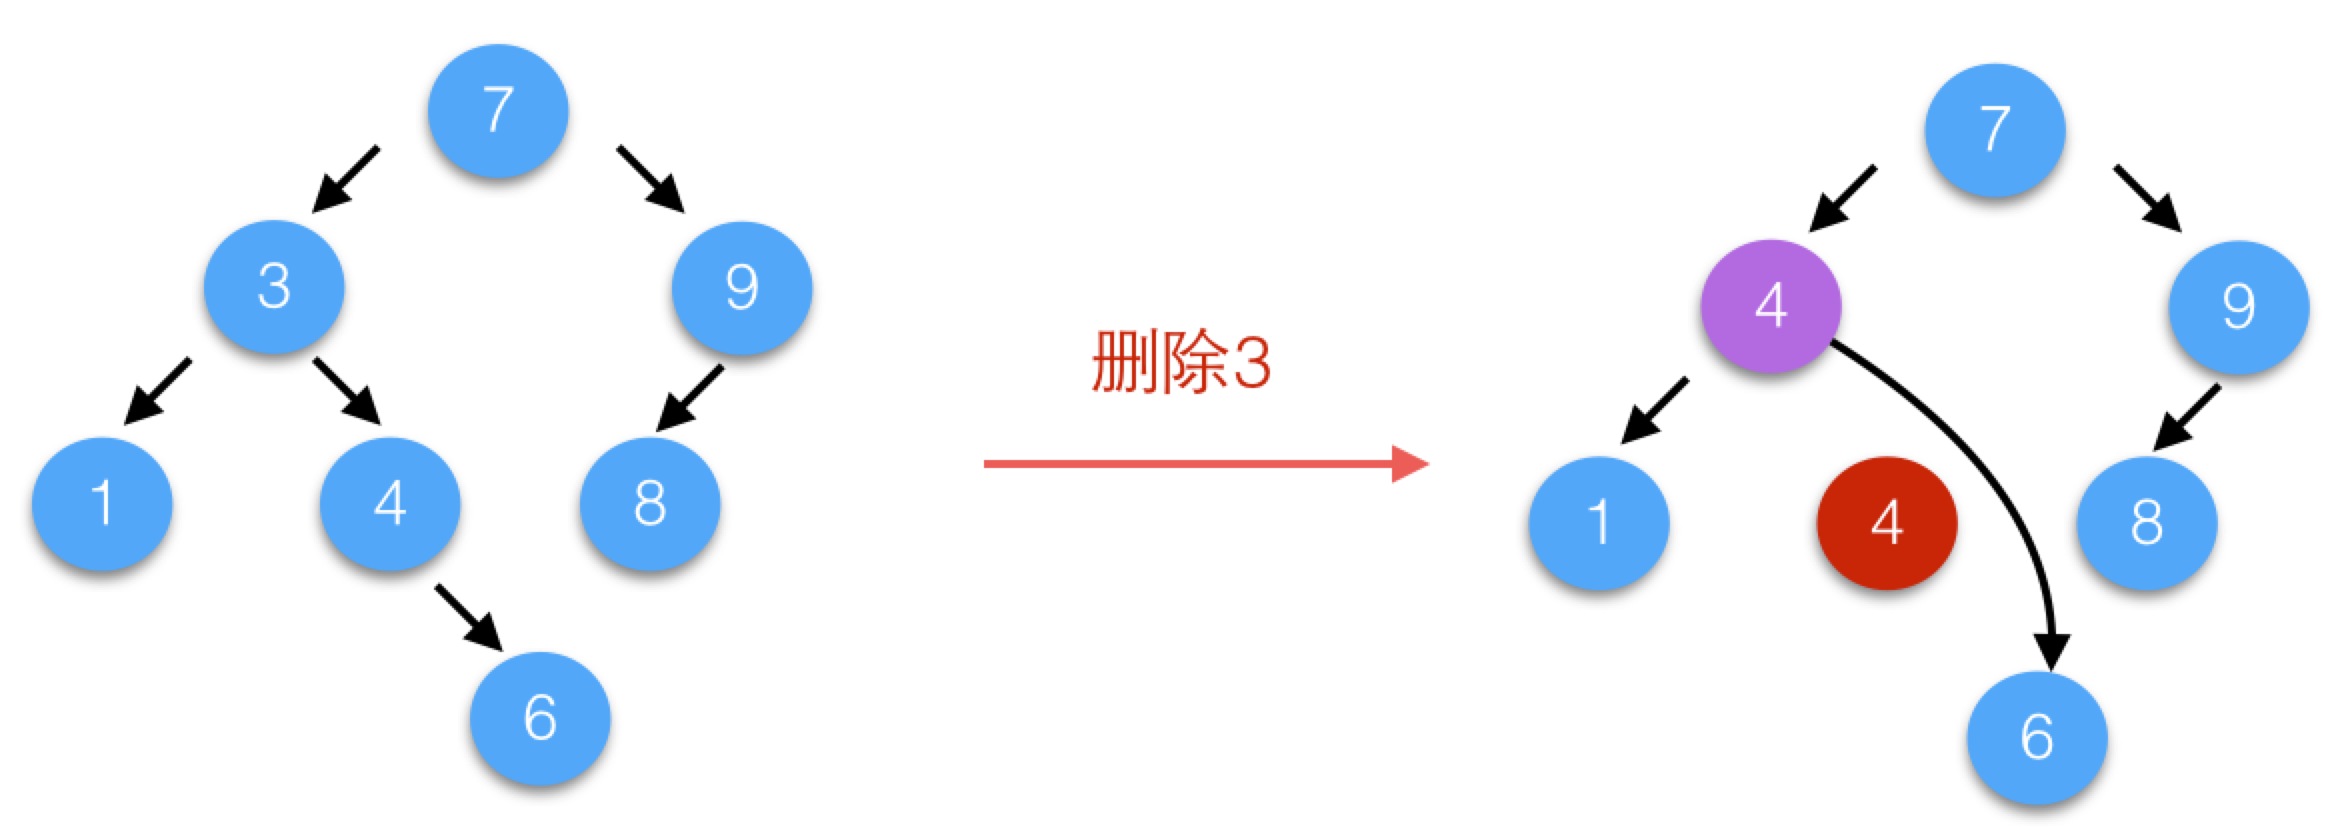
  visit(node)      // 1 → 3 → 4 → 6 → 7 → 8 → 9
  inOrder(node.right)
非遞歸後繼算法(用於迭代器實現):
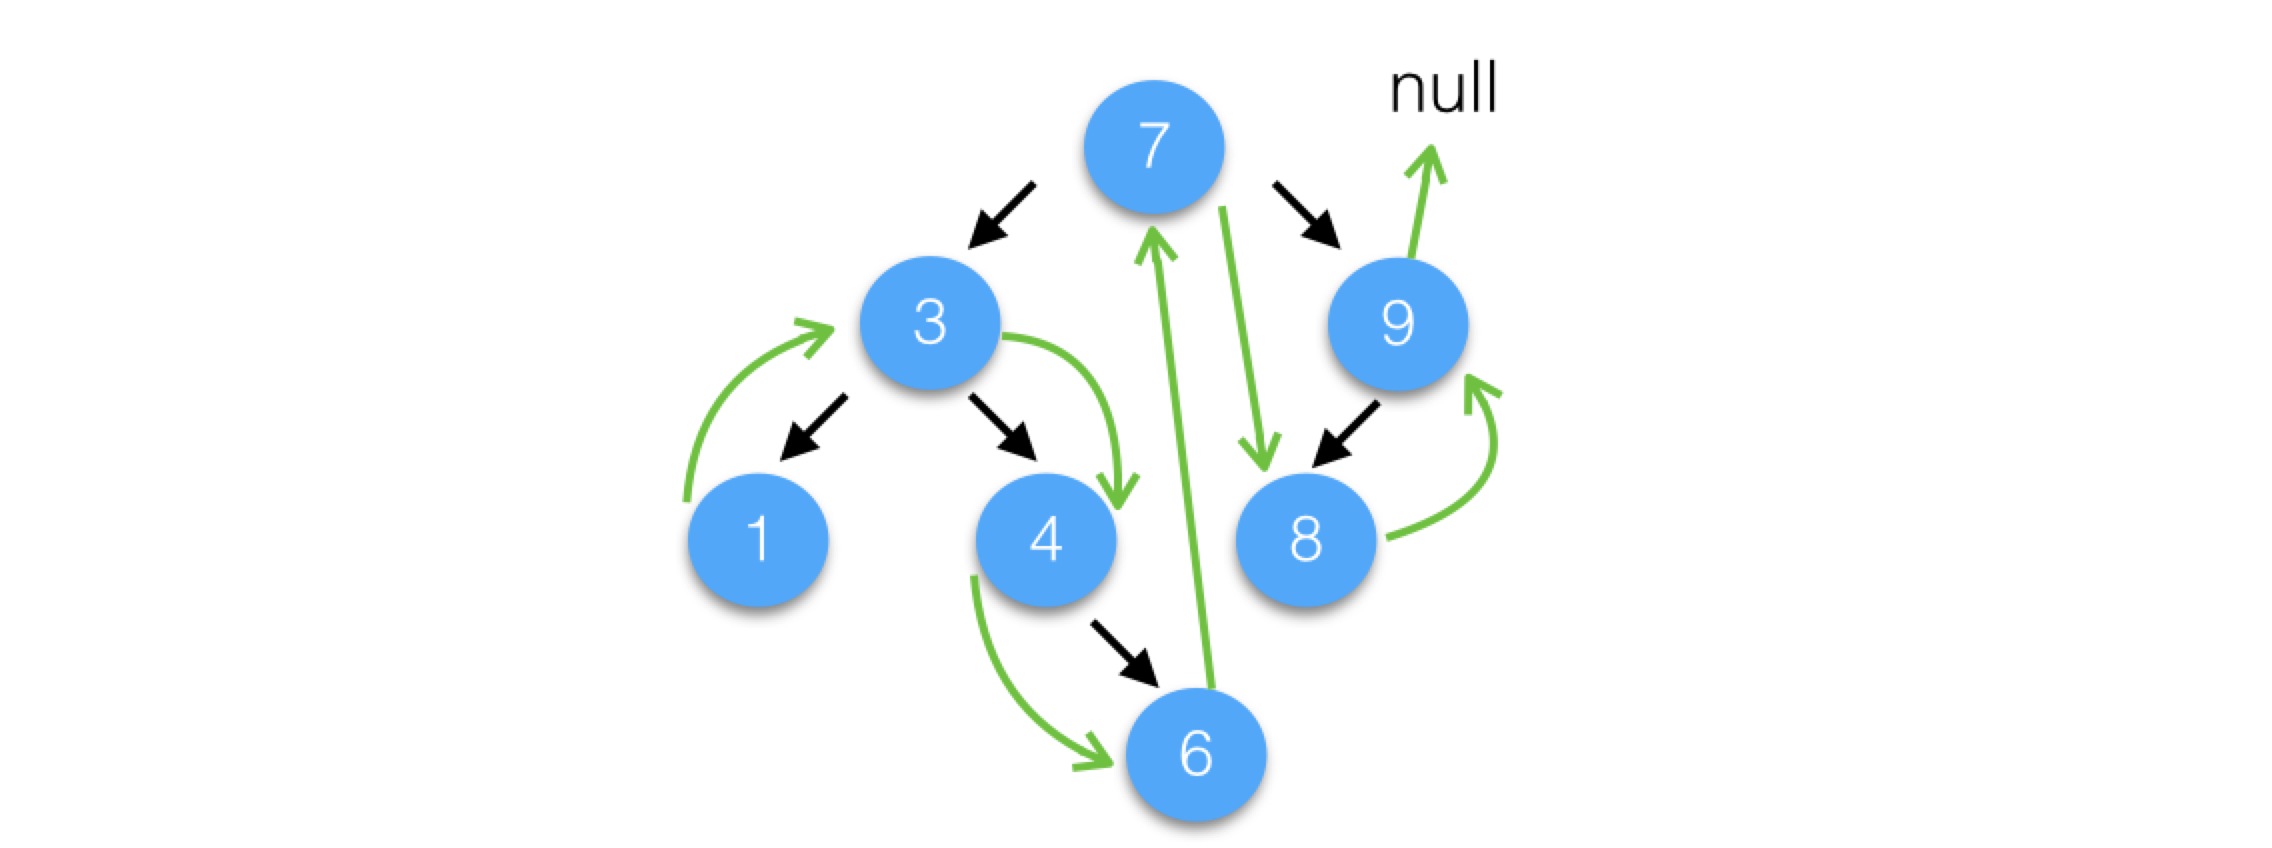
步驟與查找幾乎相同,只是在「應該插入卻發現 null」的位置掛上新節點。
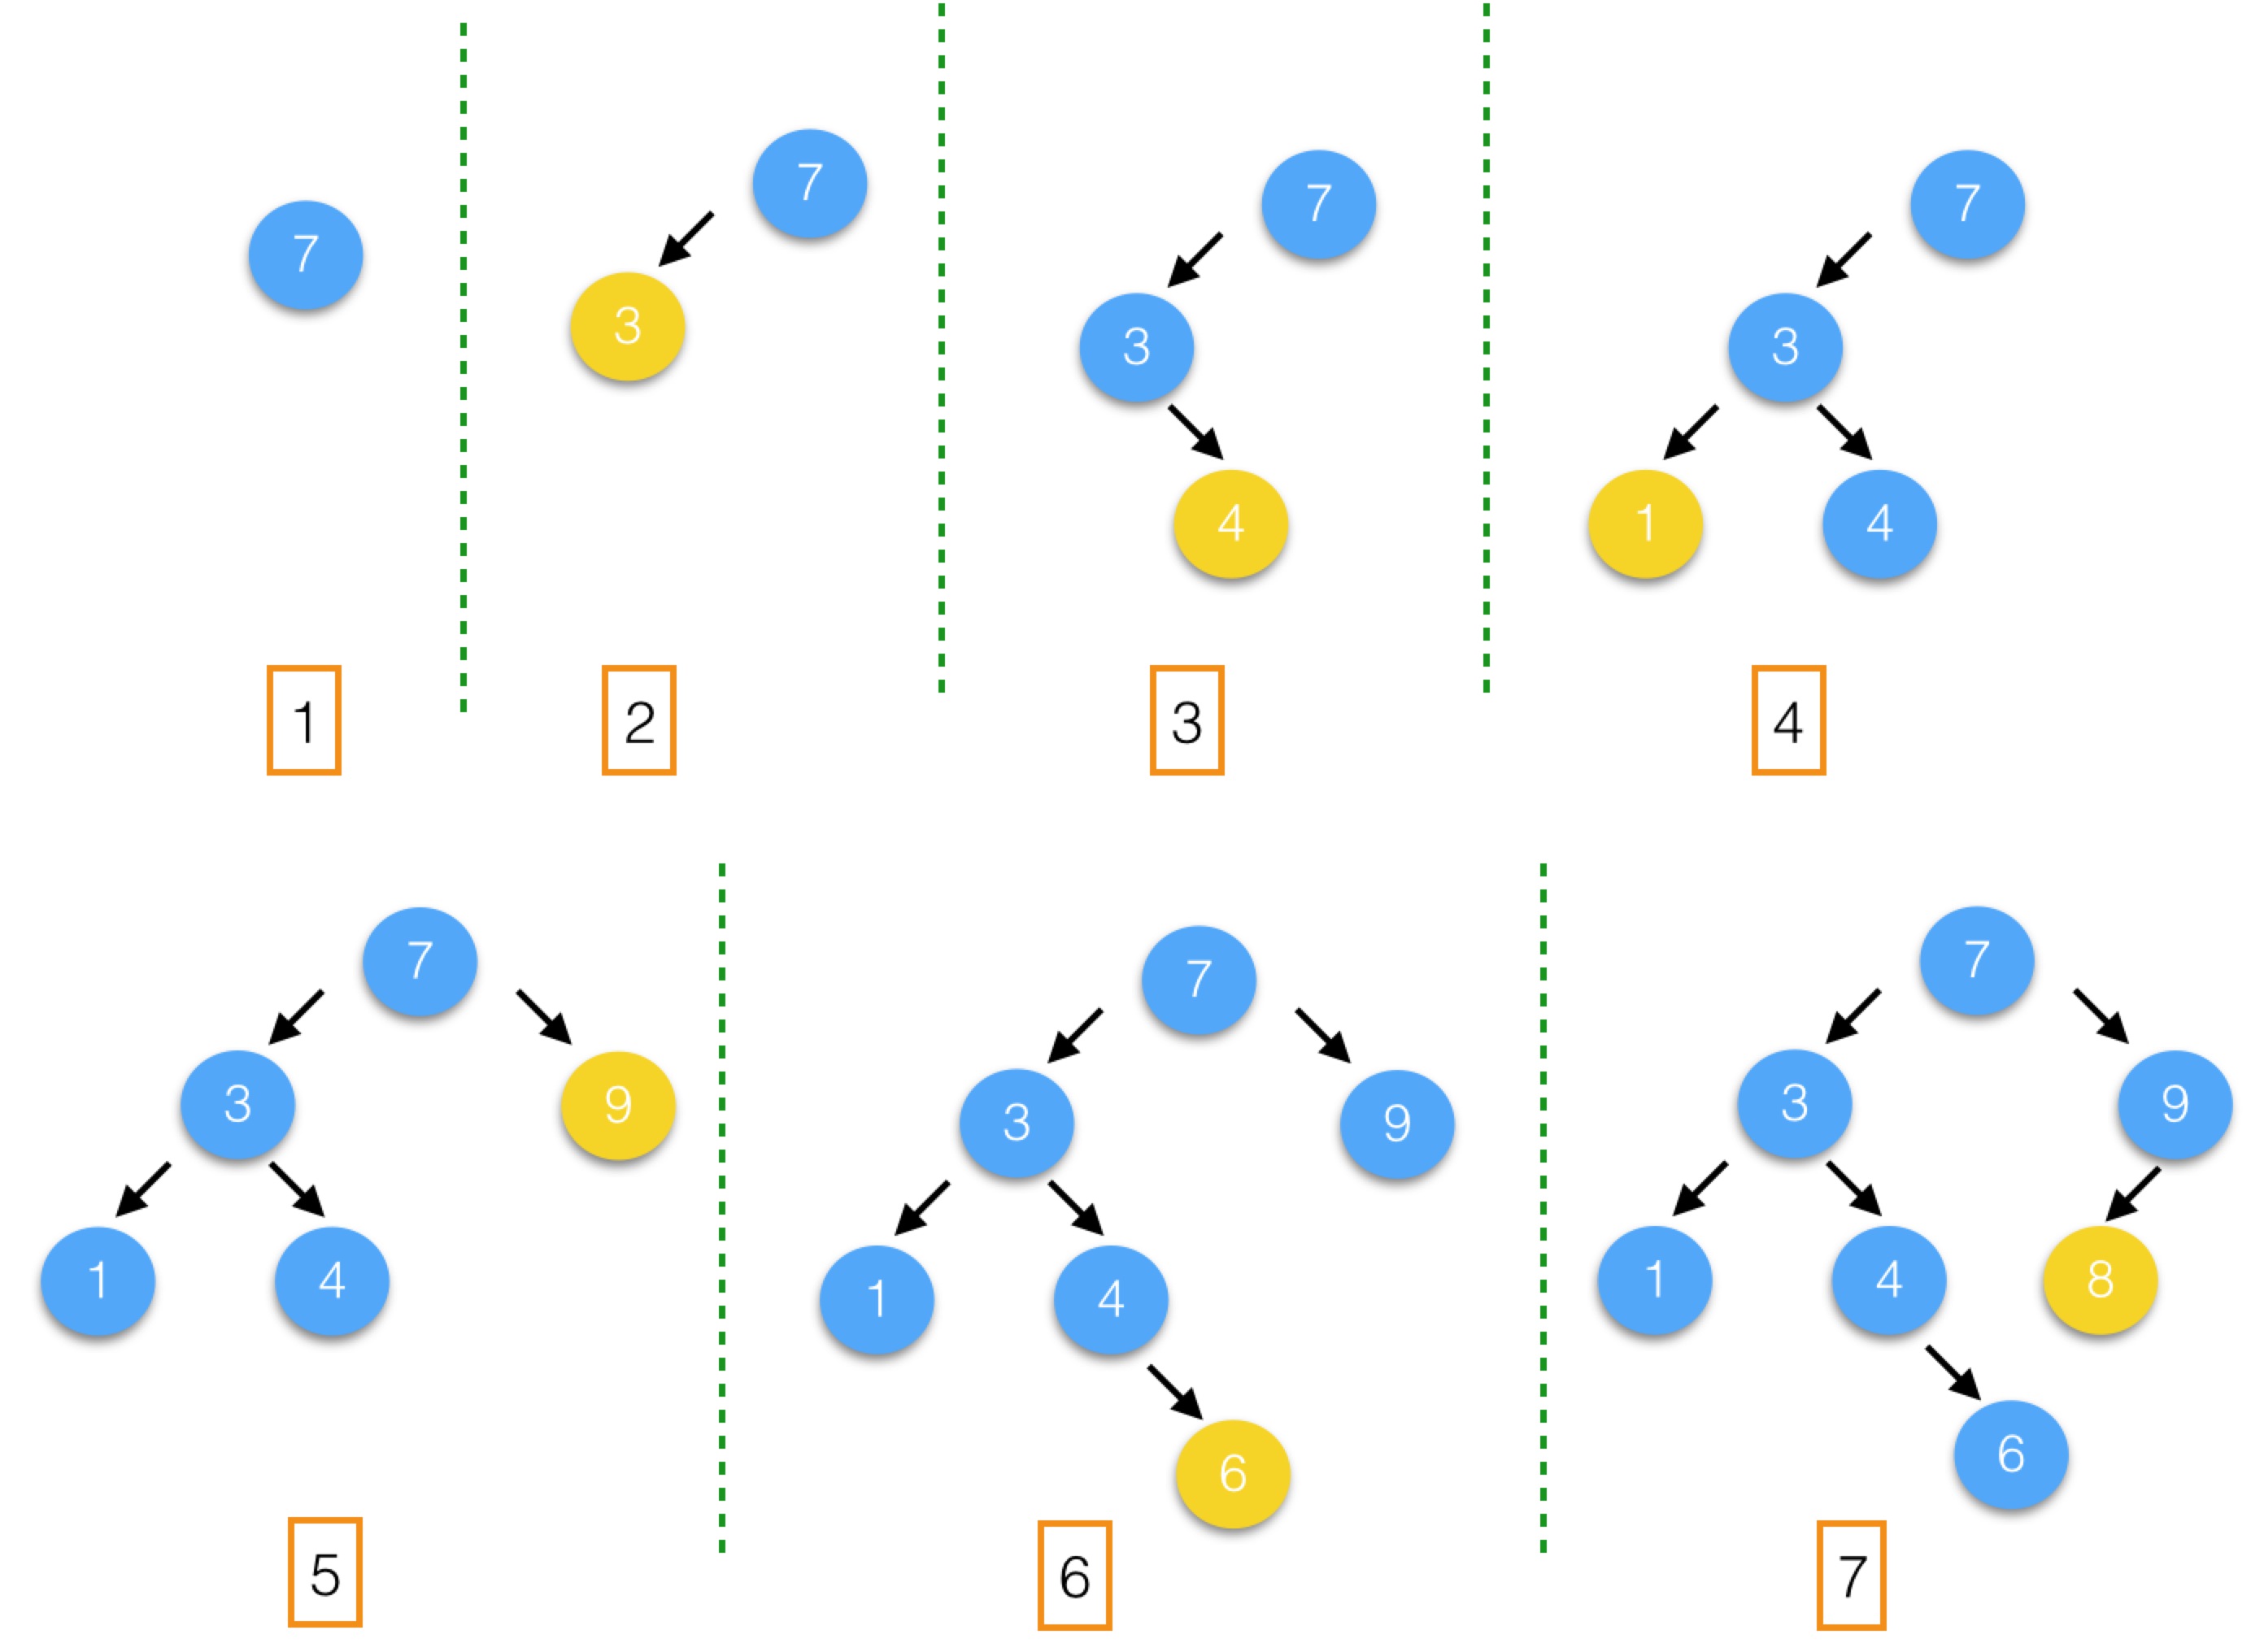
若插入序列有序(如 1,3,4,6,7,8,9),BST 退化為鏈表,查找/插入/刪除全變 O(N)。
TreeMap、TreeSet、Linux 內核 CFS 調度器、數據庫索引(B+樹變體)
| 操作 | 普通 BST | 平衡 BST (AVL/紅黑) |
|---|---|---|
| 查找/插入/刪除 | O(h) ,最壞 O(N) | O(log N) 穩定 |
| 有序遍歷 | O(N) | O(N) |
| 最值查找 | O(h) | O(log N) |
不需要順序 → 優先哈希(O(1))
需要順序/範圍查詢 → 選樹(O(log N))
這正是 HashMap vs TreeMap、數據庫 Hash 索引 vs B+樹索引 的本質區別。理解 BST,是通往高性能存儲引擎的敲門磚。
下兩節將深入剖析 TreeMap 與 TreeSet 源碼,揭秘紅黑樹在 JDK 中的工程化實現細節。敬請期待!