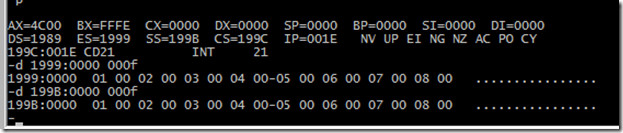
組合語言常被說「資料無型別」,這並非指缺乏 BYTE/WORD/DWORD/QWORD/TBYTE 等定義偽指令,而是指 型別僅存在於組譯期,執行期記憶體只是位元組序列,同一記憶體區塊可隨意以不同寬度存取。本文透過實例深度解析此特性。
wordData dw 100 dup (?)   ; 組譯期:定義 100 字 (200 位元組)
; 使用時可視為:
; - 100 WORD 元素
; - 200 BYTE 元素
; - 50 DWORD 元素
; - 25 QWORD 元素
invoke wsprintf, offset wordData, offset keyword, 100
; wsprintf 期望位元組緩衝區,wordData 以位元組視圖傳入完全合法
local rect:RECT          ; RECT = 4 DWORD = 16 位元組
lea esi, rect
lea edi, buffer
mov cx, sizeof rect      ; 16
rep movsb                ; 以位元組複製,無視結構欄位
invoke MessageBox, hWin, offset rect, 0, 0
; rect 內容作為字串緩衝區傳入 (需確保以 0 結尾)
| 階段 | 型別意義 | 範例 |
|---|---|---|
| 組譯期 | 決定指令編碼、位移計算、結構欄位偏移 | MOV AX, [BX] vs MOV AL, [BX] 編碼不同 |
| 連結期 | 解析符號位址、段屬性合併 | EXTRN var:WORD vs EXTRN var:DWORD 影響重定位 |
| 執行期 | 完全無型別,CPU 僅見位元組流 | 同一記憶體可被 MOV AL、MOV AX、MOV EAX 交替存取 |
.data
buffer db 1024 dup (?)   ; 統一緩衝區
.code
; 視為 DWORD 陣列清零
mov edi, offset buffer
mov ecx, 1024/4
xor eax, eax
rep stosd

; 視為 BYTE 陣列填入字串
invoke lstrcpy, offset buffer, offset srcString

; 視為 WORD 陣列進行 Unicode 處理
mov esi, offset buffer
movzx eax, word ptr [esi]  ; 讀取第一個 WCHAR
MYUNION struct
    dwordVal dd ?
    byteVal  db 4 dup (?)
    wordVal  dw 2 dup (?)
MYUNION ends

.data
myUnion MYUNION <>
.code
mov myUnion.dwordVal, 0x12345678
; myUnion.byteVal = 78h, 56h, 34h, 12h (小端序)
; myUnion.wordVal = 5678h, 1234h
mov eax, dword ptr [esi+1]  ; 從非 4 位元組對齊位址讀取 DWORD
; x86 支援非對齊存取 (效能較慢),組合語言無型別限制直接允許
; 此處視為 BYTE 緩衝區。組合語言「資料無型別」的本質是:型別是組譯器的靜態約束,記憶體是執行期的動態位元組序列。這賦予了極大的靈活性——同一緩衝區可作字串、陣列、結構、原始位元組流互轉——但也要求程式設計師自律:明確文件化視圖切換、注意對齊效能、除錯時補充型別提示。善用此特性,能寫出極度緊湊、多功能復用的底層程式碼。