並行運算透過多處理器同時計算縮短執行時間。缺乏多核心硬體時,可用 **多執行緒** 在單 CPU 上模擬並行邏輯,驗證演算法正確性。本文實作經典 **並行最大值歸約** 演算法:陣列大小 n = 2^m,資料置於 A[n] ~ A[2n-1],經 m 階段兩兩比較,最終最大值集中於 A[1]。時間複雜度 O(log n),最大平行度 n/2。
Input: n = 2^m, A[n..2n-1] 存放資料
Output: A[1] 為最大值

for k = m-1 downto 0:
    for j = 2^k to 2^(k+1)-1  parallel:
        A[j] = max(A[2j], A[2j+1])
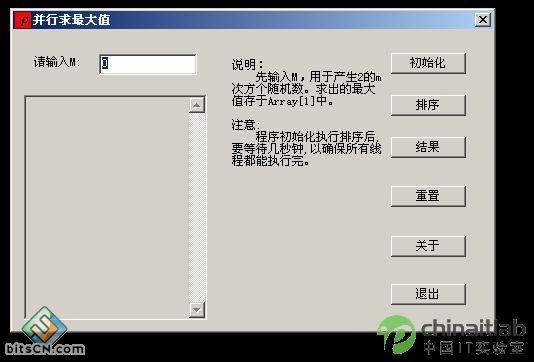
| 控制項 | ID | 說明 |
|---|---|---|
| 輸入 m (冪次) | IDC_M_COUNT | Edit, 變數 m_intCount |
| 初始化按鈕 | IDC_BTN_INITIAL | 產生 2^m 隨機數 |
| 計算按鈕 | IDC_BTN_COMPUTE | 啟動多執行緒計算 |
| 顯示按鈕 | IDC_BTN_SHOW | 列印陣列過程 |
| 清除按鈕 | IDC_BTN_CLEAR | 重置 |
| 結果顯示 | IDC_STR_ARRAY | Edit (Multi-line), 變數 m_strArray |
int g_nCount = 0; // n = 2^m
int g_j = 0;      // 執行緒參數索引
int* g_array = nullptr; // 動態陣列
void CDemoDlg::OnBtnInitial()
{
    UpdateData(TRUE);
    srand((unsigned)time(NULL));
    g_nCount = 1 << m_intCount; // 2^m
    g_array = new int[2 * g_nCount];

    CString str;
    for (int i = g_nCount; i < 2 * g_nCount; ++i) {
        g_array[i] = rand() / 100;
        str.Format(_T("Array[%d]= %d\r\n"), i, g_array[i]);
        m_strArray += str;
    }
    UpdateData(FALSE);
}
// 執行緒函式
UINT ComputeThread(LPVOID pParam)
{
    // 每個執行緒處理一對比較
    if (g_array[2 * g_j] >= g_array[2 * g_j + 1])
        g_array[g_j] = g_array[2 * g_j];
    else
        g_array[g_j] = g_array[2 * g_j + 1];
    return 0;
}

void CDemoDlg::OnBtnCompute()
{
    // 階段 k = m-1 .. 0
    for (int k = m_intCount - 1; k >= 0; --k) {
        int start = 1 << k;       // 2^k
        int end   = 1 << (k + 1); // 2^(k+1)
        // 該階段所有比較並行啟動
        for (g_j = start; g_j < end; ++g_j) {
            AfxBeginThread(ComputeThread, GetSafeHwnd(), THREAD_PRIORITY_NORMAL);
        }
        // 注意:此處未同步等待所有執行緒結束!
        // 正確做法需用事件/計數器等待,否則下一階段可能用到未更新的值。
    }
}
void CDemoDlg::OnBtnShow()
{
    CString str;
    for (int k = 1; k < 2 * g_nCount; ++k) {
        str.Format(_T("Array[%d]= %d\r\n"), k, g_array[k]);
        m_strArray += str;
    }
    UpdateData(FALSE);
}
void CDemoDlg::OnBtnClear()
{
    m_strArray.Empty(); UpdateData(FALSE);
    delete[] g_array; g_array = nullptr;
    g_nCount = 0; g_j = 0;
}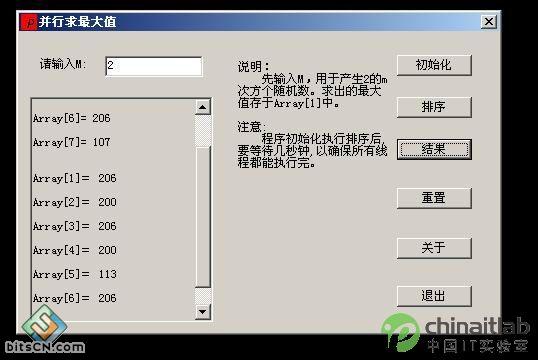
可觀察到各階段比較順序與結果收斂過程。
AfxBeginThread 非阻塞,迴圈直接進入下一階段,導致**競態條件** — 下階段可能讀取上階段尚未寫入的 g_array[j]。CEvent 陣列或 InterlockedIncrement 計數器,主執行緒 WaitForMultipleObjects 等待所有子執行緒完成後再進入下一階段。2^k 個執行緒,總數 n-1。實際專案應使用 **執行緒池** (QueueUserWorkItem/ThreadPool) 重複使用執行緒。g_j,但讀取 2*g_j 可能與其他執行緒寫入衝突。需保證 **階段屏障** (Barrier)。std::thread + std::barrier (C++20) / concurrency::parallel_reduce (PPL) / OpenMP #pragma omp parallel for reduction(max:val) 更簡潔高效。本範例展示多執行緒模擬並行邏輯的基本框架,但**未正確同步**,僅供演算法邏輯理解。實際並行程式設計務必嚴謹處理同步、資料競爭、執行緒生命週期,建議使用成熟並行庫 (PPL, TBB, OpenMP, CUDA) 而非手工管理執行緒。