ISO 10646 定義 31 位元字符空間,目前僅分配前 65534 碼位(BMP),即 UCS-2 可編址範圍。
ISO 10646 與 Unicode Consortium 1991 年合併,碼表保持兼容。Unicode 額外定義語意屬性(排版、雙向演算法等),為高品質排版系統提供參考。
解決 UCS-2/4 在 8 位元環境下的不相容問題。特性:
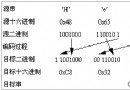
110xxxxx 兩字節、1110xxxx 三字節…)。0xFE、0xFF 永不出現,避免與 BOM 混淆。| UCS-4 範圍 | UTF-8 位元組序列 |
|---|---|
| 0000 0000 ~ 0000 007F | 0xxxxxxx |
| 0000 0080 ~ 0000 07FF | 110xxxxx 10xxxxxx |
| 0000 0800 ~ 0000 FFFF | 1110xxxx 10xxxxxx 10xxxxxx |
| 0001 0000 ~ 001F FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
| 0020 0000 ~ 03FF FFFF | 111110xx 10xxxxxx ... |
| 0400 0000 ~ 7FFF FFFF | 1111110x 10xxxxxx ... |
// Unicode → UTF-8
int UnicodeToUTF8(WCHAR ucs2, unsigned char* buffer) {
    memset(buffer, 0, 4);
    if (ucs2 <= 0x007F) { buffer[0] = (char)ucs2; return 1; }
    if (ucs2 <= 0x07FF) {
        buffer[1] = 0x80 | (ucs2 & 0x3F);
        buffer[0] = 0xC0 | ((ucs2 >> 6) & 0x1F);
        return 2;
    }
    // 0x0800 ~ 0xFFFF
    buffer[2] = 0x80 | (ucs2 & 0x3F);
    buffer[1] = 0x80 | ((ucs2 >> 6) & 0x3F);
    buffer[0] = 0xE0 | ((ucs2 >> 12) & 0x0F);
    return 3;
}

// UTF-8 → Unicode
WCHAR UTF8ToUnicode(unsigned char* buffer) {
    WCHAR temp = 0;
    if (buffer[0] < 0x80) return buffer[0];
    if (buffer[0] < 0xE0) {  // 2 bytes
        temp = (buffer[0] & 0x1F) << 6 | (buffer[1] & 0x3F);
    } else if (buffer[0] < 0xF0) {  // 3 bytes
        temp = (buffer[0] & 0x0F) << 12 | (buffer[1] & 0x3F) << 6 | (buffer[2] & 0x3F);
    } else return 0xFEFF;  // 非首位元組或超過 3 字節
    return temp;
}注意:解碼需加入安全檢查,防範非法序列(如 0xC0 0x80 解碼為 U+0000 導致緩衝區溢位)。
+ 啟始編碼,- 結束;+- 代表字面 +。AFTER_PLUS),位元緩衝區累積 6 位元輸出 Base64 字母表字元。文中提供完整 UnicodeToUTF7 / UTF7ToUnicode 狀態機實作,含哈希表加速字元分類與 Base64 反查。
// Unicode → 多位元組 (GB2312/UTF-8/UTF-7)
int UnicodeToGB2312(char** dest, const WCHAR* src) {
    int size = WideCharToMultiByte(CP_ACP, 0, src, -1, NULL, 0, NULL, NULL);
    *dest = new char[size];
    return WideCharToMultiByte(CP_ACP, 0, src, -1, *dest, size, NULL, NULL);
}
// 多位元組 → Unicode
int Gb2312ToUnicode(WCHAR** dest, const char* src) {
    int len = strlen(src);
    *dest = new WCHAR[len + 1];
    int ret = MultiByteToWideChar(CP_ACP, MB_PRECOMPOSED, src, len, *dest, len);
    (*dest)[ret] = 0;
    return ret;
}代碼頁參數:CP_ACP(系統預設)、CP_UTF7 (65000)、CP_UTF8 (65001)。
CString UrlToString(CString url) {
    CString str; url.MakeLower();
for (int i=0; i本文系統梳理 UCS/Unicode/UTF/GB2312 編碼體系與互轉算法,附實戰 C++ 代碼,另補充 MIME 等編碼請自行查閱。