百度網盤分享鏈接無法直接下載,需經過網頁跳轉。本文介紹如何使用 PHP 通過正則表達式解析分享頁面,提取文件真實下載地址,實現直鏈下載功能,適合圖床、資源站等需要外鏈的場景。
<?php
// 獲取查詢字符串參數
$canshu = $_SERVER["QUERY_STRING"];
if (empty($canshu)) {
die("文件不存在");
} else {
// 構造百度網盤分享頁面完整 URL
$wangzhi = "https://pan.baidu.com/share/link?" . $canshu;
// 獲取頁面源碼
$file = file_get_contents($wangzhi);
// 正則匹配下載按鈕鏈接
$pattern = '/a><a class="dbtn cancel singledbtn" href=(.*?)id="downFileButtom">/i';
preg_match_all($pattern, $file, $result);
// 提取並清理 URL
$tempurl = implode("", $result[1]);
$fileurlt = str_replace('"', '', $tempurl);
$fileurl = str_replace("&", "&", $fileurlt);
// 重定向到真實下載地址
header("location:$fileurl");
}
?>file_get_contents 獲取分享頁面 HTMLheader("location:...") 直接跳轉到真實文件地址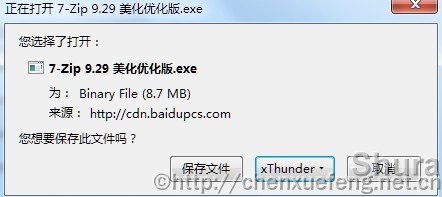
<?php
function getBaiduPanContent($url) {
    $ch = curl_init();
    curl_setopt_array($ch, [
        CURLOPT_URL => $url,
        CURLOPT_RETURNTRANSFER => true,
        CURLOPT_FOLLOWLOCATION => true,
        CURLOPT_USERAGENT => 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
        CURLOPT_TIMEOUT => 10,
        CURLOPT_SSL_VERIFYPEER => false
    ]);
    $content = curl_exec($ch);
    curl_close($ch);
    return $content;
}
?>DOMDocument + DOMXPath 替代正則,抗頁面結構變動能力更強<?php
class BaiduPanDirectLink {
private $userAgent = 'Mozilla/5.0 (compatible; BaiduPanDirectLink/1.0)';
public function getDirectUrl($shareUrl) {
$html = $this->fetchPage($shareUrl);
if (!$html) return false;
return $this->parseDownloadUrl($html);
}
private function fetchPage($url) {
$ch = curl_init($url);
curl_setopt_array($ch, [
CURLOPT_RETURNTRANSFER => true,
CURLOPT_USERAGENT => $this->userAgent,
CURLOPT_TIMEOUT => 15,
CURLOPT_SSL_VERIFYPEER => false
]);
$result = curl_exec($ch);
curl_close($ch);
return $result;
}
private function parseDownloadUrl($html) {
// 使用 DOM 解析器更可靠
$dom = new DOMDocument();
@$dom->loadHTML($html);
$xpath = new DOMXPath($dom);
// 尋找下載按鈕
$nodes = $xpath->query('//a[contains(@class, "dbtn") and contains(@class, "cancel")]');
if ($nodes->length > 0) {
$href = $nodes->item(0)->getAttribute('href');
return html_entity_decode($href, ENT_QUOTES, 'UTF-8');
}
return false;
}
}
?>通過分析百度網盤分享頁面結構,配合 PHP 正則或 DOM 解析,可實現文件直鏈獲取。但需注意百度頁面結構可能隨時變更,生產環境建議採用更健壯的解析策略並添加完善的異常處理與緩存機制。