字符編碼問題是 PHP 開發中最隱蔽、最令人頭疼的坑之一:亂碼、截斷、數據庫存儲異常、API 對接失敗。本文系統梳理 PHP 編碼處理機制,提供基於 `mbstring` 的自動識別轉換方案,並覆蓋數據庫、前端、文件、API 全鏈路最佳實踐。
黃金法則:項目啟動時統一設置 `mb_internal_encoding('UTF-8'); mb_http_output('UTF-8'); mb_regex_encoding('UTF-8');`
| 函數 | 用途 | 優點 | 缺點 |
|---|---|---|---|
mb_detect_encoding() | 自動檢測編碼 | 內置、支援列表順序 | 短文本誤判率高、需指定候選列表 |
mb_check_encoding() | 驗證字符串是否屬於某編碼 | 嚴格、可作白名單驗證 | 不能單獨識別 |
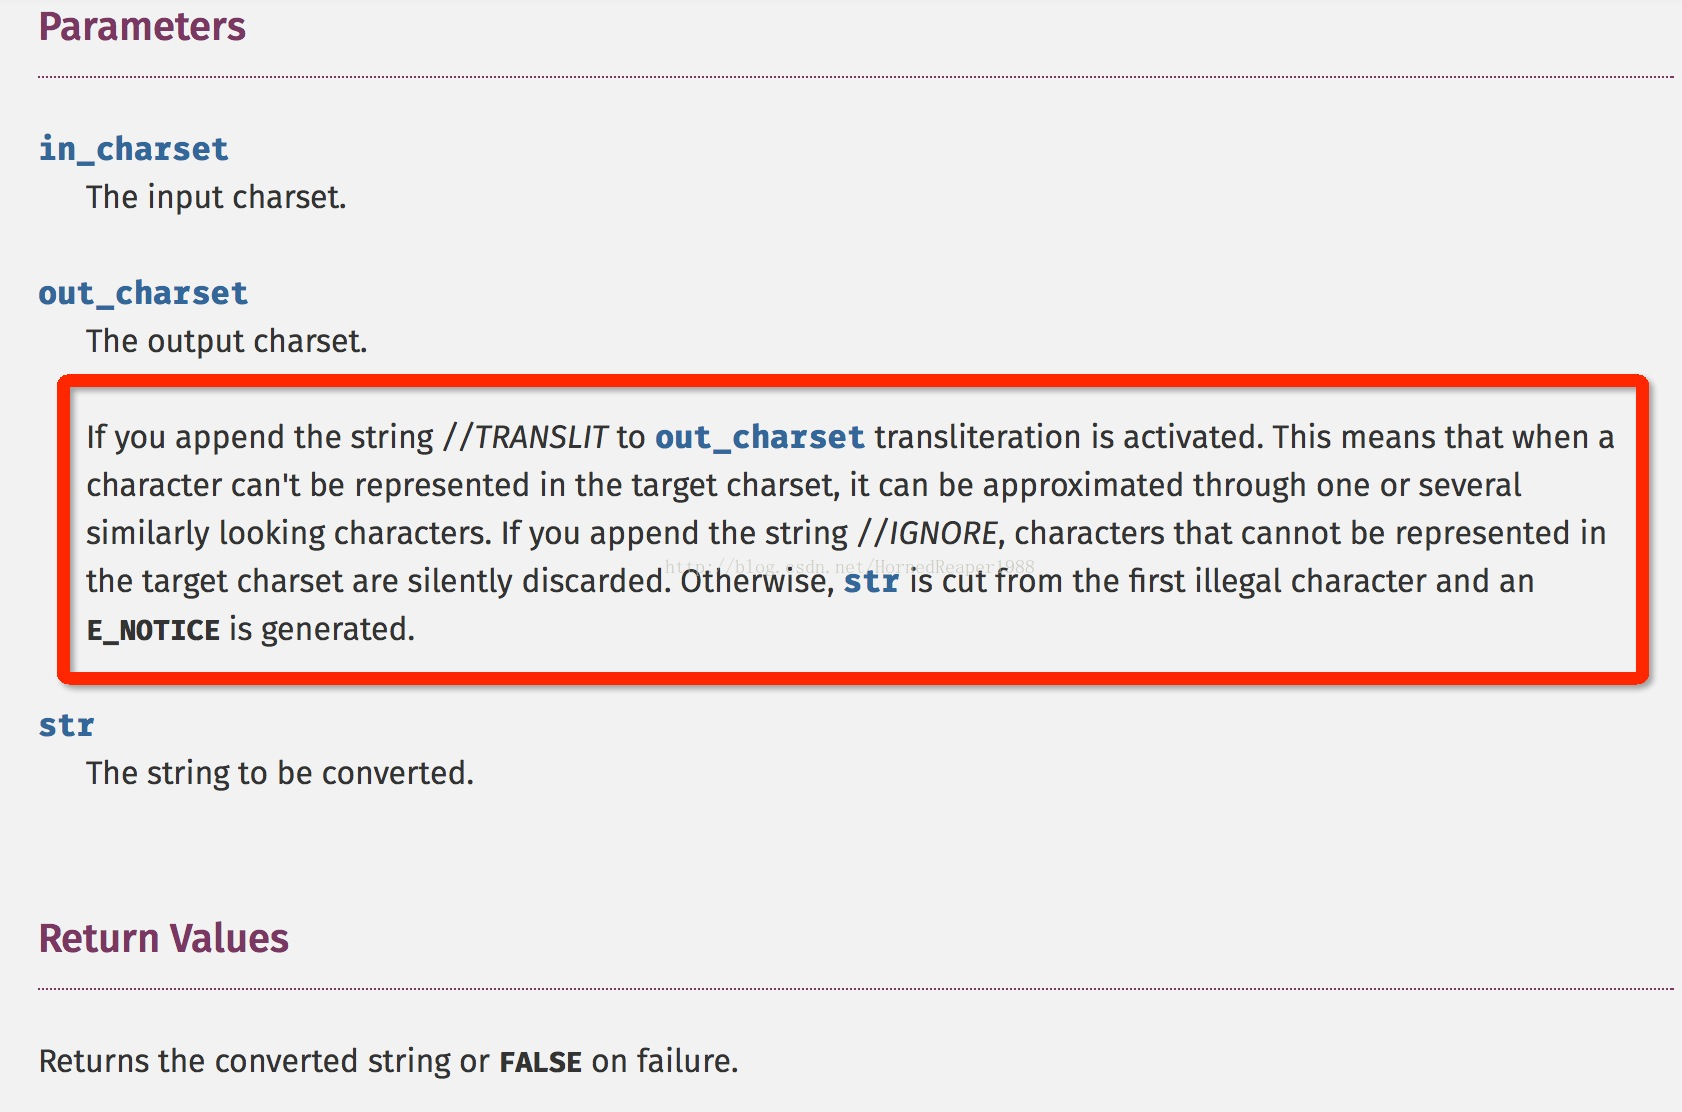
iconv() | 編碼轉換 | 系統級、支援極多編碼、//IGNORE//TRANSLIT | 性能一般、錯誤處理需捕獲 |
mb_convert_encoding() | 編碼轉換(mbstring) | 內存安全、支援數組批量、自動處理無效字符 | 依賴 mbstring 擴展 |
mb_convert_variables() | 批量轉換變量/數組 | 遞歸處理多維數組 | 引用修改原數組、性能較慢 |
<?php
/**
 * 智能編碼轉換器
 * 策略:UTF-8 直通 → 嘗試 GBK/Big5 → 兜底替換無效字符
 */
class EncodingConverter {
    private array $detectOrder = ['UTF-8', 'GBK', 'GB2312', 'Big5', 'ASCII'];
    private string $targetEncoding = 'UTF-8';
    private bool $strictMode = false;

    public function __construct(array $options = []) {
        $this->detectOrder = $options['detect_order'] ?? $this->detectOrder;
        $this->targetEncoding = $options['target'] ?? 'UTF-8';
        $this->strictMode = $options['strict'] ?? false;
        // 確保內部編碼一致
        mb_internal_encoding('UTF-8');
    }

    /**
     * 單字符串轉換
     * @return string 轉換後字符串
     * @throws EncodingException 嚴格模式下無法識別/轉換失敗
     */
    public function convert(string $str): string {
        if ($str === '') return '';

        // 1. 已是目標編碼且合法
        if (mb_check_encoding($str, $this->targetEncoding)) {
            return $this->strictMode ? $str : $this->sanitize($str);
        }

        // 2. 嘗試檢測源編碼
        $detected = mb_detect_encoding($str, $this->detectOrder, true);
        if ($detected) {
            return $this->doConvert($str, $detected);
        }

        // 3. 兜底:嘗試常見中文編碼強行轉換
        foreach (['GBK', 'GB2312', 'Big5'] as $enc) {
            if (mb_check_encoding($str, $enc)) {
                return $this->doConvert($str, $enc);
            }
        }

        // 4. 最後手段:按目標編碼清洗
        if (!$this->strictMode) {
            return $this->sanitize($str);
        }

        throw new EncodingException("Unable to detect/convert encoding for string: " . substr($str, 0, 50));
    }

    /** 批量轉換數組(遞歸) */
    public function convertArray(array &$data): void {
        array_walk_recursive($data, function(&$value) {
            if (is_string($value)) $value = $this->convert($value);
        });
    }

    private function doConvert(string $str, string $fromEnc): string {
        $converted = @mb_convert_encoding($str, $this->targetEncoding, $fromEnc);
        if ($converted === false || !$this->strictMode && !mb_check_encoding($converted, $this->targetEncoding)) {
            // 雙重保險:iconv //IGNORE 移除無效字節
            $converted = @iconv($fromEnc, $this->targetEncoding . '//IGNORE', $str);
        }
        return $this->sanitize($converted);
    }

    /** 清洗:移除控制字符、替換替換字符、規範化換行 */
    private function sanitize(string $str): string {
        // 移除 C0/C1 控制字符(保留 \t\n\r)
        $str = preg_replace('/[\x00-\x08\x0B\x0C\x0E-\x1F\x7F-\x9F]/u', '', $str);
        // 替換 Unicode 替換字符
        $str = str_replace("\u{FFFD}", '', $str);
        // 統一換行
        $str = str_replace(["\r\n", "\r"], "\n", $str);
        return $str;
    }
}

// 異常類
class EncodingException extends Exception {}| 環節 | 關鍵配置 | 驗證命令 |
|---|---|---|
| PHP 源文件 | UTF-8 無 BOM | `file -i *.php` → `text/x-php; charset=utf-8` |
| PHP 運行時 | `mb_internal_encoding('UTF-8')` `default_charset = "UTF-8"` (php.ini) | `php -r "var_dump(mb_internal_encoding());"` |
| 數據庫連接 | MySQL: `SET NAMES utf8mb4` PDO: `charset=utf8mb4` DSN 參數 表/列: `CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci` | `SHOW VARIABLES LIKE 'char%';` `SHOW CREATE TABLE t;` |
| HTTP 響應 | `header('Content-Type: text/html; charset=utf-8')` Nginx: `charset utf-8;` | `curl -I url | grep -i content-type` |
| HTML 頁面 | `` 在 `` 首位 | 瀏覽器開發工具 Network → Headers |
| 前端表單提交 | ` | 提交中文檢查 `$_POST` 內容 |
| 文件讀寫 | `fopen($f, 'r', false, stream_context_create(['encoding'=>'UTF-8']))` | 讀取含中文文件檢查 |
| JSON API | `json_encode($data, JSON_UNESCAPED_UNICODE)` | 響應中文不應有 `\uXXXX` |
| URL 參數 | 前端 `encodeURIComponent`,後端自動解碼 | 含中文 URL 測試 |
| 緩存/隊列 | Redis: 無特殊要求(二進制安全) 序列化: `igbinary`/`msgpack` 保持二進制 | 存取中文 Key/Value |
原因:連接字符集非 `utf8mb4`,或表字符集為 `latin1`/`utf8`(3 字節,不支持 Emoji)。
解決:PDO DSN 添加 `charset=utf8mb4`,執行 `ALTER TABLE t CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;`
原因:數據中含有非 UTF-8 字符(如 GBK 字節序列)。
解決:`json_encode` 前對數組調用 `EncodingConverter::convertArray($data);`,或 PHP 7.3+ 使用 `JSON_THROW_ON_ERROR` 捕獲具體錯誤位置。
原因:`mb_internal_encoding` 未設置或與字符串實際編碼不符。
解決:入口文件強制 `mb_internal_encoding('UTF-8');`,或每次調用顯式指定 `mb_substr($str, 0, 10, 'UTF-8')`。
編碼問題的本質是「協議不匹配」。建立「UTF-8 全鏈路」標準,輔以「邊界統一轉換、內部純 UTF-8、異常快速失敗」的工程化策略,才能從根治亂碼噩夢。