在開發 JSP 應用時,經常會遇到一個令人頭疼的問題:明明在 JSP 頁面已經做了中文亂碼處理,前端卻依然顯示亂碼。罪魁禍首往往藏在 HTML 頁面頭部一行看似不起眼的代碼中:
<meta http-equiv="Content-Type" content="text/html; charset=GBK">如果這裡的 charset 被錯誤地設置為 UTF-8,而後端 JSP 實際輸出的是 GBK 編碼,或者雙方編碼不一致,就會導致瀏覽器以錯誤的字符集解碼頁面,從而產生亂碼。即使 JSP 端使用了 request.getParameter(...).getBytes("ISO-8859-1") 這類轉碼邏輯,也無法彌補前後端編碼協議不匹配的根本缺陷。
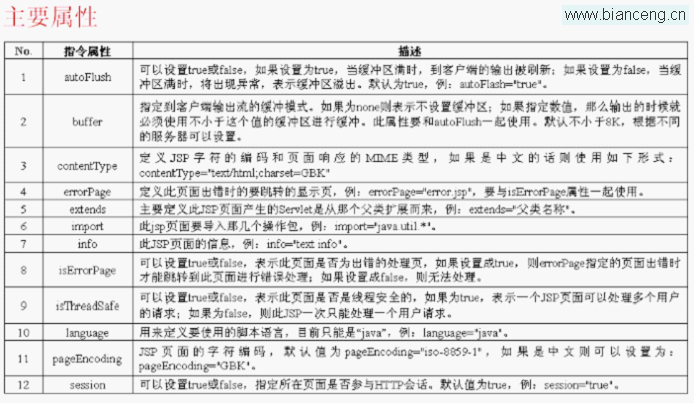
解決亂碼的鐵律只有一條:HTML 頁面聲明的 charset、JSP page 指令的 pageEncoding、Servlet 請求/響應編碼、資料庫連接編碼,這四者必須保持完全一致。建議全站統一採用 UTF-8,因為它支援全球字符,避免了 GBK 等編碼在跨系統交互時的兼容性陷阱。
<meta charset="UTF-8">(HTML5 簡寫)或 <meta http-equiv="Content-Type" content="text/html; charset=UTF-8">。<%@ page contentType="text/html;charset=UTF-8" pageEncoding="UTF-8" %>。request.setCharacterEncoding("UTF-8");response.setContentType("text/html;charset=UTF-8");<Connector> 節點添加 URIEncoding="UTF-8",解決 GET 請求中文參數亂碼。jdbc:mysql://...?characterEncoding=UTF-8&useUnicode=true。new String(request.getParameter("uname").getBytes("ISO-8859-1"), "UTF-8") 這種寫法極易出錯,且在 Tomcat 8+ 已不再需要,正確配置編碼後框架會自動處理。Content-Type 是否包含 charset=UTF-8。document.characterSet 確認瀏覽器實際使用的解碼集。徹底解決亂碼,關鍵在於「統一」而非「轉碼」。建立標準化的編碼規範並貫徹執行,才能從根源上杜絕亂碼問題。