URL 中文亂碼是 Java Web 開發經典痛點。GET 請求參數在瀏覽器、代理、伺服器多層編解碼下極易出錯。本文系統梳理三大解決體系:前端 JS 編碼、後端 Filter 過濾、Tomcat 容器配置,助你徹底根治。
GET 請求 URL 編碼流程:
%XX%XXURIEncoding(預設 ISO-8859-1)解碼為字串request.getParameter() 返回解碼後字串核心衝突:瀏覽器編碼 ≠ Tomcat 解碼編碼 → 亂碼。POST 請求體由 request.setCharacterEncoding() 控制,通常不受影響。
| 方法 | 編碼範圍 | 不編碼字符 | 適用場景 |
|---|---|---|---|
| escape() | 非 ASCII | @ * + - . / _ | 已棄用,不推薦 |
| encodeURI() | 整個 URL | ! @ # $ & * ( ) = : / ; ? + ' ~ | 編碼完整 URL |
| encodeURIComponent() | 單個參數值 | ~ ! * ( ) ' (僅保留極少) | 編碼參數值(推薦) |
// 前端
var url = '/search?name=' + encodeURIComponent('中文關鍵字');
window.location.href = url;

// 後端:Tomcat URIEncoding=UTF-8 時自動正確解碼
// 若 Tomcat 預設 ISO-8859-1,需手動轉碼:
String name = request.getParameter("name");
name = new String(name.getBytes("ISO-8859-1"), "UTF-8");// 前端:雙重 encodeURI
var url = '/search?name=' + encodeURI(encodeURI('中文關鍵字'));
// 生成:/search?name=%25E4%25B8%25AD%25E6%2596%2587...
// 後端:URLDecoder 解碼
String name = request.getParameter("name");
name = URLDecoder.decode(name, "UTF-8"); // 自動處理 %25 -> % -> 字節原理:第一次編碼產生 %E4%B8%AD,第二次將 % 編碼為 %25,Tomcat 按 ISO-8859-1 解碼還原為 %E4%B8%AD,後端 URLDecoder 再次解碼得到中文。
@WebFilter("/*")
public class EncodingFilter implements Filter {
    private String encoding = "UTF-8";

    public void doFilter(ServletRequest req, ServletResponse resp, FilterChain chain) {
        req.setCharacterEncoding(encoding);
        resp.setCharacterEncoding(encoding);
        chain.doFilter(req, resp);
    }
}局限:setCharacterEncoding 對 GET 請求無效(參數已在 URL 解析階段完成解碼)。
@WebFilter("/*")
public class UrlDecodingFilter implements Filter {
    private String encoding = "UTF-8";

    public void doFilter(ServletRequest req, ServletResponse resp, FilterChain chain) {
        HttpServletRequest request = (HttpServletRequest) req;
        HttpServletResponse response = (HttpServletResponse) resp;

        // POST:直接設置編碼
        if ("POST".equalsIgnoreCase(request.getMethod())) {
            try { request.setCharacterEncoding(encoding); } catch (Exception ignored) {}
        }
        // GET:手動重新解碼所有參數
        else {
            Map<String, String[]> paramMap = request.getParameterMap();
            if (paramMap != null) {
                for (Map.Entry<String, String[]> entry : paramMap.entrySet()) {
                    String[] values = entry.getValue();
                    if (values != null) {
                        for (int i = 0; i < values.length; i++) {
                            try {
                                // 關鍵:ISO-8859-1 -> 字節 -> UTF-8 字串
                                values[i] = new String(values[i].getBytes("ISO-8859-1"), encoding);
                            } catch (UnsupportedEncodingException ignored) {}
                        }
                    }
                }
            }
        }

        response.setContentType("text/html;charset=" + encoding);
        chain.doFilter(request, response);
    }
}原理:Tomcat 預設用 ISO-8859-1 解碼 URL,得到的字串實際是「字節值對應的 ISO-8859-1 字符」。將其按 ISO-8859-1 轉回字節,再按 UTF-8 解碼,即還原原始中文。
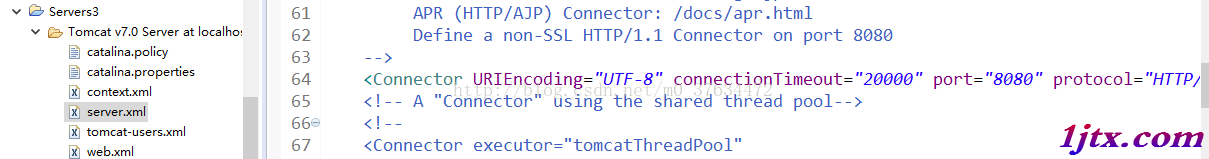
修改 $CATALINA_HOME/conf/server.xml,在 <Connector> 添加 URIEncoding:
<Connector port="8080" protocol="HTTP/1.1"
           connectionTimeout="20000"
           redirectPort="8443"
           URIEncoding="UTF-8"
useBodyEncodingForURI="true" />URIEncoding="UTF-8":強制 Tomcat 用 UTF-8 解碼 URL(GET 參數)useBodyEncodingForURI="true":若請求體編碼(POST)與 URI 編碼一致,可簡化配置重啟 Tomcat 即時生效,無需代碼修改。Spring Boot 內嵌 Tomcat 配置:
server.tomcat.uri-encoding=UTF-8<%@ page language="java" contentType="text/html; charset=UTF-8" pageEncoding="UTF-8"%>
<meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />| 方案 | 優點 | 缺點 | 推薦指數 |
|---|---|---|---|
| Tomcat URIEncoding | 零代碼侵入、全局生效、效能最佳 | 需控制容器配置權限 | ⭐⭐⭐⭐⭐ |
| Filter 手動解碼 | 應用層可控、無需容器權限、兼容性好 | 需確保 Filter 順序在最前、略增 CPU | ⭐⭐⭐⭐ |
| JS 雙重編碼 | 無後端依賴、兼容舊環境 | 前後端強耦合、URL 難閱讀、易漏編碼 | ⭐⭐ |
UrlDecodingFilter 並確保 <filter-mapping> 排在最前。useBodyEncodingForURI="true" 讓請求體編碼與 URI 保持一致。characterEncoding=utf8&useUnicode=true。URL 中文亂碼本質是編碼與解碼不一致。掌握「瀏覽器編碼 → Tomcat 解碼 → Servlet 獲取」鏈路,在正確層面統一 UTF-8,即可徹底解決。生產環境強烈建議容器級配置 Tomcat URIEncoding=UTF-8,輔以 JSP 頁面編碼聲明,零代碼侵入、效能最優、維護成本最低。