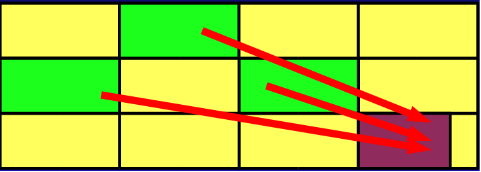
傳統 Trie 節點包含字符映射表,空間開銷大。Double-Array Trie 用兩個數組 base[]、check[] 模擬狀態轉移,配合 tail[] 存儲尾部字符串,極大壓縮空間。
base[s] + c = t:狀態 s 經字符 c 轉移到狀態 t。check[t] == s 驗證轉移合法性。base[t] < 0 表示尾部字符串起始位置(存入 tail);base[t] == 0 表示單字符結尾(如停止符)。base==0 && check==0)直接佔用,尾部字符串寫入 tail。base 值重定位整個子樹(x_check 找最小可用基址)。public boolean exists(String word) {
int p = 1;
for (int i = 0; i < word.length(); i++) {
int c = charCode(word.charAt(i));
int next = base[p] + c;
if (check[next] != p) return false;
if (base[next] < 0) {
return tailMatch(-base[next], word.substring(i + 1));
}
p = next;
}
// 檢查停止符
int term = base[p] + charCode(END_CHAR);
return check[term] == p;
}
findAllWords(prefix):定位前綴對應狀態,遞歸收集所有尾部字符串。getAllChildWord(state):遍歷 check[] 找出所有子狀態,拼接字符輸出。public class DoubleArrayTrie {
private static final char END_CHAR = '\0';
private int[] base = new int[1024];
private int[] check = new int[1024];
private char[] tail = new char[1024];
private int tailPos = 1;
private final Map charMap = new HashMap<>();
private final List charList = new ArrayList<>();
public DoubleArrayTrie() {
base[1] = 1; // 根節點 base
addChar(END_CHAR); // 停止符編碼 1
for (char c = 'a'; c <= 'z'; c++) addChar(c);
}
private int addChar(char c) {
int code = charMap.size() + 1;
charMap.put(c, code);
charList.add(c);
return code;
}
private int charCode(char c) {
return charMap.computeIfAbsent(c, this::addChar);
}
// 擴容、複製尾部、尋找基址、衝突處理等輔助方法省略...
// 完整代碼見原文,約 300 行。
}
加載 6 萬英文單詞,構建耗時 ~2 秒。數組規模:
base/check 長度 131,072(擴容至 2^17)。tail 長度 262,144。short[] 或 byte[] 存儲 tail(ASCII 字符)。