URL 傳遞中文參數時,經歷「瀏覽器編碼 → 伺服器解碼」兩個階段。亂碼根因:**編碼集與解碼集不匹配**。
// 前端:JS 編碼
encodeURIComponent("中文") // "%E4%B8%AD%E6%96%87" (UTF-8)

// 後端:Tomcat 默認解碼
String param = request.getParameter("key"); // ISO-8859-1 解碼 → 亂碼
| 版本 | 默認 URL 解碼編碼 | 備註 |
|---|---|---|
| Tomcat 7 及以下 | ISO-8859-1 | 必須手動處理 |
| Tomcat 8+ | UTF-8 | 需配置 URIEncoding=UTF-8 |
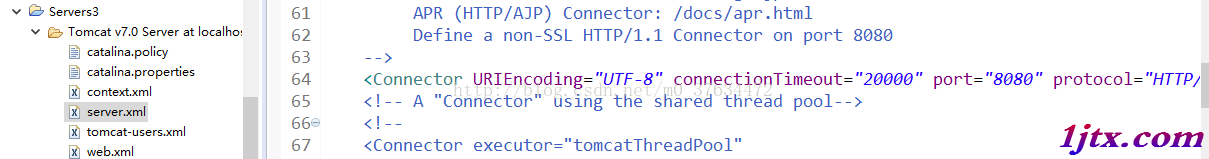
Tomcat server.xml:
<Connector port="8080" protocol="HTTP/1.1"
           connectionTimeout="20000"
           redirectPort="8443"
           URIEncoding="UTF-8"
           useBodyEncodingForURI="true" />
Spring Boot application.yml:
server:
  tomcat:
    uri-encoding: UTF-8
@WebFilter("/*")
public class EncodingFilter implements Filter {
    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) {
        request.setCharacterEncoding("UTF-8");
        response.setCharacterEncoding("UTF-8");
        chain.doFilter(request, response);
    }
}
注意:Filter 僅對 POST 請求體有效,GET 請求參數需 Tomcat 配置 URIEncoding。
// GET 參數亂碼修復:ISO-8859-1 → UTF-8
String raw = request.getParameter("param");
String fixed = new String(raw.getBytes("ISO-8859-1"), "UTF-8");
原理:Tomcat 用 ISO-8859-1 錯誤解碼後,字節序列其實是原始 UTF-8 字節,重新取回字節再用 UTF-8 解碼即可修復。
某些反向代理/網關會對 URL 進行二次編碼:
// 原始:中文
// 編碼一次:%E4%B8%AD%E6%96%87
// 編碼兩次:%25E4%25B8%25AD%25E6%2596%2587  (% 被編碼為 %25)

// 容器自動解碼一次 → 還原為 %E4%B8%AD%E6%96%87
// 我們只需再手動解碼一次即可
String param = request.getParameter("key"); // 獲取 %E4%B8%AD%E6%96%87
String decoded = URLDecoder.decode(param, "UTF-8"); // 解碼為 中文
| 誤區 | 正確認知 |
|---|---|
| request.setCharacterEncoding 對 GET 生效 | 僅對 POST 請求體有效 |
| 亂碼一定是後端問題 | 可能是前端編碼、網關雙重編碼、資料庫編碼 |
| ISO-8859-1 能表示中文 | 不能,單字節編碼僅支持西歐語言 |
| 所有容器行為一致 | Tomcat、Jetty、Undertow、Resin 默認行為不同 |
// 打印原始字節分析
String param = request.getParameter("key");
System.out.println("原始參數: " + param);
System.out.println("字節(ISO-8859-1): " + Arrays.toString(param.getBytes("ISO-8859-1")));
System.out.println("字節(UTF-8): " + Arrays.toString(param.getBytes("UTF-8")));
// 對比字節序列判斷實際編碼