上月分析了參考計數、複製、標記-清除、標記-整理等經典垃圾收集技術,各有優缺點。例如:大量物件成為垃圾時複製表現好,但長壽物件多時變差(反覆複製);反之標記-整理對長壽物件好(僅複製一次),但大量短壽物件時效果不佳。JDK 1.2+ 採用的分代垃圾收集結合兩者優點,使物件配置開銷極小。
應用程式堆中,部分物件建立後很快成為垃圾,部分在程式整個運行期間存活。經驗分析表明:對大多數面向物件語言(含 Java),絕大多數物件——高達 98%(視年輕定義)——年輕時即死亡。物件壽命可用時鐘秒數、配置後記憶體子系統配置總位元組、經歷垃圾收集次數計量,但無論如何計量,結論相同:大多數物件年輕時死亡。此事實對收集器選擇意義重大:當大多數物件年輕時死亡,複製收集器表現良好,因完全不訪問死物件,僅將活物件複製到另一堆區域,一次性回收所有剩餘空間。
經歷首次垃圾收集仍存活的物件,大部分會成為長壽或永久物件。根據短壽與長壽物件混合比例,不同垃圾收集策略效能差異極大。複製收集器處理長壽物件差(在半空間間反覆複製);標記-整理對長壽物件好(長壽物件沉入堆底無需再複製);但標記-清除/整理需大量分析死物件工作(清除階段必須分析堆中每個物件)。
分代收集器將堆分為多代。物件在年輕代建立,滿足提升標準(如經歷特定次數垃圾收集)的物件提升至下一更老代。分代收集器可對不同代自由使用不同收集策略,分別對各代進行垃圾收集。
分代收集優勢之一:不同時收集所有代,使垃圾收集暫停更短。配置器無法滿足配置請求時,首先觸發小型收集,僅收集最年輕代。年輕代中大量物件已死,複製收集器完全不分析死物件,故小型收集暫停極短且通常能回收大量堆空間。若小型收集釋放足夠空間,使用者程式立即恢復;否則繼續收集上一代,直到回收足夠記憶體(全部收集後仍不足則擴展堆或拋 OutOfMemoryError)。
追蹤垃圾收集器(複製、標記-清除、標記-整理)從根集合開始掃描,遍歷物件間參考直到訪問所有活物件。分代追蹤收集器從根集合開始,但不遍歷指向更老代物件的參考,減少追蹤物件圖大小。但帶來問題:若老代物件參考無法從根集合所有其他參考鏈到達的年輕物件怎麼辦?
解決此問題,分代收集器必須顯式追蹤老物件到年輕物件參考,將老到年輕參考加入小型收集根集合。創建老到年輕參考兩種方式:修改老物件包含參考指向年輕物件、或提升參考其他年輕物件的年輕物件為更老代。
無論老到年輕參考由提升或指標修改創建,垃圾收集器小型收集時需全部老到年輕參考。追蹤老代開銷大;較好方法:線性掃描老代尋找年輕物件參考——較快且區域性更好,但仍有大量工作。變更器與垃圾收集器可合作維護老到年輕參考完整列表:物件提升為更老代時,垃圾收集器記錄因提升創建的老到年輕參考,僅需追蹤指標修改創建的代間參考。
垃圾收集器追蹤修改現有物件參考產生的老到年輕參考有多種方法:用維護參考計數相同方法(編譯器生成環繞指標賦值額外指令)、在老代堆用虛擬記憶體保護捕獲寫入、或用老代堆頁修改髒位確定掃描塊。小技巧可避免追蹤每個指標修改並檢查是否跨代邊界:無需追蹤本地/靜態變數儲存(已屬根集合)、構造函數中初始化新物件欄位的指標儲存(所謂初始化儲存),因幾乎所有物件配置在年輕代。無論何種情況,運行庫必須維護老物件到年輕物件參考集並在收集年輕代時加入根集合。
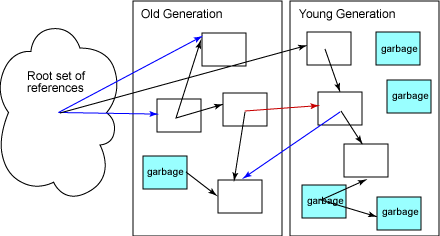
圖 1 箭頭表示堆中物件間參考。紅箭頭:必須加入根集合供小型收集用的老到年輕參考。藍箭頭:從根集合或年輕代到老物件參考,僅收集年輕代時無需追蹤。
Sun JDK 使用卡片標記演算法改進標識老代物件欄位中指標修改。堆分為一組卡片,每卡片通常小於一記憶體頁。JVM 維護卡片映射,對應堆中每卡片有一位元(某些實作為一位元組)。每次修改堆中物件指標欄位,在卡片映射設定對應卡片相應位元。垃圾收集時,檢查與老代卡片相關聯標記位元,掃描髒卡片尋找參考年輕代物件,然後清除標記位元。卡片標記開銷:卡片映射額外空間、每指標儲存額外工作、垃圾收集時額外工作。每非初始化堆指標儲存,卡片標記僅增加 2-3 條機器指令,小型收集時需掃描所有髒卡片上物件。
預設情況下,JDK 1.4.1 將堆分兩部分:年輕代、老代(實際有第三部分——永久空間,儲存載入類別與方法物件)。年輕代在複製收集器輔助下,分為伊甸園與兩個倖存者半空間。老代使用標記-整理收集器。物件經歷幾次複製後提升至老代。小型收集將活物件從伊甸園和一個倖存者半空間複製到另一倖存者半空間,並可能提升部分物件至老代。大型收集同時收集年輕代與老代。System.gc() 總觸發大型收集——這是應盡量少用(甚至完全不用)的原因之一,因大型收集比小型收集耗時長得多。無程式化方式觸發小型收集。
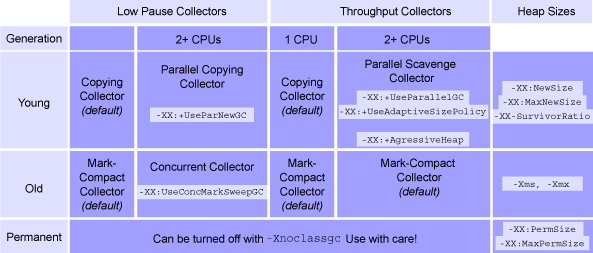
除預設複製與標記-整理收集器,JDK 1.4.1 含其他四種垃圾收集演算法,各適用不同目的:增量收集器(JDK 1.2 即存在)、三種多處理器系統更有效收集的新收集器——平行複製收集器、平行清除收集器、並發標記-清除收集器。新收集器旨在解決多處理器系統中垃圾收集器成為擴展性瓶頸問題。圖 2 顯示選擇備用收集選項指引。
增量收集選項自 1.2 成為 JDK 一部分。以犧牲吞吐量為代價減少垃圾收集暫停,僅在極短暫停極重要時值得考慮(如近即時系統)。JDK 用Train 演算法實現增量收集:在堆中老代與年輕代間創建新區域,劃分為「火車」,每火車分「車廂」。每車廂可單獨收集,結果每火車車廂組成單獨一代,意味著不僅追蹤老到年輕參考,還追蹤老火車到年輕火車、老車廂到年輕車廂參考。為變更器與垃圾收集器帶來大量額外工作,但獲得更短收集暫停。
JDK 1.4.1 新收集器皆為解決多處理器系統垃圾收集器問題而設計。大多數垃圾收集演算法使系統停頓一段時間,單執行緒收集器快成為擴展性瓶頸——垃圾收集器掛起使用者程式執行緒時,除一處理器外其他皆閒置。新收集器中兩個——平行複製收集器、並發標記-清除收集器——設計減少收集暫停時間。另一個平行清除收集器針對大堆上更高吞吐量設計。
-XX:+UseParNewGC 啟用,年輕代複製收集器,將垃圾收集工作分為與 CPU 數量相同執行緒-XX:+UseConcMarkSweepGC 啟用,老代標記-清除收集器,初始標記階段(及後續短暫重新標記階段)短暫停整個系統,然後恢復使用者程式,垃圾收集器執行緒與使用者程式並發執行-XX:+UseParallelGC 啟用,年輕代收集器,針對多處理器系統上極大(GB 級以上)堆優化平行複製與並發標記-清除基本上是預設複製與標記-整理收集器的並發版本。
六種演算法可選,可能不知用哪種。圖 2 提供指引,將收集器分單執行緒/並發、短暫停/高吞吐量。掌握應用程式與部署環境資訊足以選擇合適演算法。許多應用程式預設收集器運作良好——若無效能問題,無需增加複雜度。但應用部署於多處理器系統或使用極大堆,改變收集器選項可能帶來巨大效能提升。
JDK 1.4.1 含大量微調垃圾收集選項。調整選項並衡量效果可能耗費大量時間,故嘗試微調前先對應用程式徹底配置分析與優化,微調工作可能獲更好結果。
微調第一步:檢查冗長 GC 輸出,獲取垃圾收集操作頻率、定時、持續時間等資訊。最簡單微調:擴大最大堆大小(-Xmx)。堆增大,複製收集更有效,增大堆即減少每物件收集成本。除增加最大堆大小,可用 -XX:NewRatio 增加分配給年輕代空間份額,或用 -Xmn 顯式指定年輕代大小。
隨 JVM 發展,預設垃圾收集器越來越好。JDK 1.2+ 分代垃圾收集器提供比早期 JDK 標記-清除-整理收集器好得多的配置與收集效能。JDK 1.4.1 透過增加針對多處理器系統與極大堆的多執行緒收集選項,進一步改進垃圾收集效率。下月將討論垃圾收集效能迷思(物件配置真實成本、顯式置空代價與好處、終結化代價),完成垃圾收集探討。