Java 並非首個依賴垃圾收集(GC)的語言——Lisp、Smalltalk、Eiffel、Haskell、ML、Scheme、Modula-3 早已集成,最早追溯至 1960 年代。本文回顧 GC 核心算法與演進,幫助理解 JVM 為何提供如此多收集器選項。
收益:可靠性提升、內存管理與接口設計分離、減少內存錯誤調試時間。懸空指針與內存洩漏在 Java 中不再是主流問題(僅剩非故意對象保留)。
代價:性能影響、停頓、配置複雜性、不確定的終結化。
理想 GC 完全不可見:無停頓、零 CPU 損耗、不干擾虛擬內存/緩存、堆大小僅等於駐留集。現實中無完美收集器,但過去十年有巨大改進。
JDK 1.3 有 3 種策略,1.4.1 有 6 種策略與 12+ 命令行選項。不同實現用不同策略識別/回收不可達對象,與用戶程序/調度器交互方式不同。應用需求各異:實時應用要求停頓短且有上界;企業應用可容忍較長不可預測停頓換取高吞吐。
每對象記錄活躍引用數,歸零即回收。需編譯器配合(賦值/作用域結束更新計數),簡單、增量收集、區域性好。致命缺陷:無法回收不可達循環結構(循環鏈表、帶父指針的樹)。C++ string 等類使用此技術。
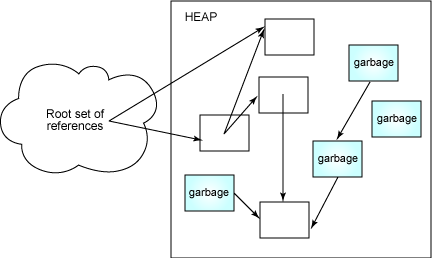
JDK 標準收集器均屬此類。從根集(靜態變量、線程棧局部變量)出發沿引用追蹤,標記所有可達對象。根可在程序註冊表、線程棧、靜態變量中找到。
最早由 John McCarthy 1960 年提出。停止世界 → 標記可達 → 清除未標記對象回收。
優點:實現簡單、回收循環結構、無編譯器負擔。
缺點:停頓長、清除階段掃描整個堆(虛擬內存系統負面影響大)、產生堆碎片。
堆分兩個半空間,一個活躍、一個空閒。活躍滿時停止世界,復制存活對象到空閒空間,角色互換。
優點:只訪問存活對象(不掃描垃圾、不換頁、不污染緩存)、收集時間與存活對象數成正比、自動整理堆(分配極簡單:指針加法)。
缺點:需雙倍內存、長壽對象反復復制開銷大。
結合標記-清除與復制:標記後將存活對象整理到堆底部。避免雙倍內存,代價是收集複雜度增加。徹底整理後分配速度媲美復制收集器,長壽對象沉底不再反復移動。
根據對象年齡將堆分代,不同代用不同算法:新生代(朝生夕死)用復制;老年代(長壽)用標記-整理。證明極高效,雖需更多運行時記賬。JDK 1.4.1 提供多種分代收集器組合與調優選項。
| 指標 | 關注點 |
|---|---|
| 停頓時間 | 是否停止世界?多久?有上界? |
| 停頓可預測性 | 是否在用戶程序方便時發生? |
| CPU 佔用 | 總 CPU 時間中 GC 佔比 |
| 內存大小 | 堆實際大小 vs 最大駐留集 |
| 虛擬內存交互 | 是否錯誤換入非駐留頁面 |
| 緩存交互 | 是否沖刷用戶程序數據 |
| 程序區域性影響 | 整理/復制是否改善引用區域性 |
| 編譯器/運行時影響 | 是否需編譯器配合(如更新引用計數) |
硬軟件發展使 GC 更實用。20 世紀 70-80 年代大型 Lisp 程序 25-40% 時間花在 GC;現代 JVM 已大幅改進。下一期將深入分代收集機制與 1.4.1 所有收集器選項;再下一期分析 GC 性能影響並揭露內存管理迷思。