Hibernate 作為最流行的對象關係映射(ORM)引擎之一,提供了強大的數據持久化與查詢服務。將 Hibernate 引入專案並讓其運行並不困難,但要讓它發揮最佳效能,卻需要豐富的經驗與深入的調優技巧。本文基於 Hibernate 3.3.1 與 Oracle 9i 的能源專案實戰案例,系統闡述核心調優技術,並補充掌握這些技術所必需的資料庫知識。假設讀者已具備 Hibernate 基礎知識,對官方文檔(HRD)或其他文章有詳細說明的調優方法,僅提供引用與不同視角的解析;重點聚焦於那些行之有效卻缺乏文檔記載的實戰技巧。
調優是一個貫穿軟體開發生命週期(SDLC)所有階段的迭代過程。在典型的使用 Hibernate 進行持久化的 Java EE 應用中,調優涉及業務規則、設計、Hibernate 本身、Java GC、應用容器、底層系統(資料庫與 OS)等多個層面。盲目調優不僅耗時,效果往往微乎其微。優秀的調優方法關鍵在於優先級劃分——帕累托法則(80/20 法則)同樣適用:通常 80% 的效能提升源自前 20% 的關鍵問題。
相比磁碟與網路 I/O,記憶體與 CPU 訪問具有更低延遲、更高吞吐量。因此,基於 I/O 的 Hibernate 調優與底層系統 I/O 調優,應優先於基於 CPU 與記憶體的 GC、CPU、記憶體調優。
我們曾優化一個電流選擇的 HQL 查詢,將執行時間從 30 秒壓縮至 1 秒內。若在垃圾回收上投入精力,或許只能獲得幾毫秒到幾秒的提升,相形見絀。這充分說明:定位核心瓶頸,精準打擊,事半功倍。
關於調優時機,業界存在兩派觀點:
作者經驗表明:適度的前期調優能帶來更明智的設計與細致的編碼。許多專案因將「過早優化」脫離上下文引用,導致調優被推遲太晚或投入資源不足而失敗。實際上,多線程企業級應用剖析顯示,平均 CPU 使用率僅 20-50%,剩餘開銷多在等待資料庫與網路 I/O。結合業務規則與設計的 Hibernate 調優,正是帕累托法則中那關鍵的 20%,優先級最高。
更多調優階段建議可參考 Jack Shirazi 的《Java Performance Tuning》。
無有效監控與剖析,無法知曉性能瓶頸與調優方向。
雖然 Hibernate 旨在解脫開發者直接寫 SQL 的痛苦,但調優時必須掌握其生成的 SQL。可在 log4j 中將 org.hibernate.SQL 設為 DEBUG 級別查看所有生成 SQL;其他相關包(如 org.hibernate.type)設為 DEBUG 或 TRACE 可定位更多問題。Joe Spolsky 在《The Law of Leaky Abstractions》中深入闡述了這一觀點。
啟用 hibernate.generate.statistics 後,Hibernate 會導出實體、集合、會話、二級快取、查詢與會話工廠的統計資訊,可通過 SessionFactory.getStatistics() 獲取。為簡化操作,亦可使用 MBean org.hibernate.jmx.StatisticsService 透過 JMX 導出統計,配置範例可參考官方網站。
優秀的剖析工具不僅助益 Hibernate 調優,更能惠及應用其他部分。商業工具(如 JProbe)價格昂貴,幸運的是 Sun/Oracle JDK 1.6 內建 Java VisualVM,雖功能相對基礎,但提供豐富的調試與調優資訊,足以應對大多數場景。
雖不屬 Hibernate 調優範疇,但此處決策深遠影響後續調優。需重點掌握:
基於業務需求,決定應用類型(OLTP 或數據倉庫)、分層結構、領域對象創建、數據聚合位置(資料庫聚合利用強大功能、節省頻寬,但非標準聚合移植性差;應用服務器聚合允許複雜業務邏輯,但需先載入詳細數據)。
分析師需查看大數據表的電流 ISO 聚合列表。初期要求顯示大多數字段,資料庫 1 分鐘響應,但應用載入 100 萬行數據到前端 UI 需 30 分鐘。重新分析後保留 14 個字段,移除大量可選高聚合度字段,聚合分組返回數據大幅減少,載入時間縮減至可接受範圍。
24 個「非標準」小時電流交易修改,每小時含電量與價格兩屬性。初用 Hibernate select-before-update 特性,更新 24 行需 24 次選擇。因無業務規則禁止無效修改,關閉該特性後,避免了 24 次多餘查詢。
繼承映射屬領域對象核心,HRD 第 9 章已詳述,本節聚焦 SQL 生成與各策略調優建議。以 HRD 範例類圖為基礎(見圖 1):
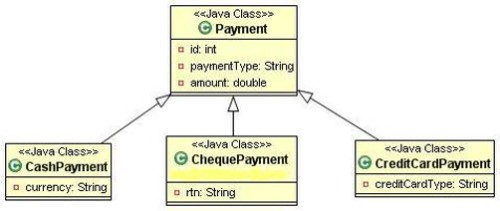
單表多態查詢 SQL 簡潔:
select id, payment_type, amount, currency, rtn, credit_card_type from payment具體子類查詢(如 CashPayment):
select id, amount, currency from payment where payment_type='CASH'優點:單表、查詢簡單、易關聯、無需包含其他子類屬性。適合數據倉庫(無連接)。
缺點:所有屬性擠在大表,大量 null 值增加基於行的資料庫調優難度;單表成熱點,OLTP 表現不佳(除非分區)。
需 4 張表,多態查詢使用左連接與 CASE 子句:
select id, payment_type, amount, currency, rtn, credit_card_type,
 case when c.payment_id is not null then 1
 when ck.payment_id is not null then 2
 when cc.payment_id is not null then 3
 when p.id is not null then 0 end as clazz
 from payment p left join cash_payment c on p.id=c.payment_id
 left join cheque_payment ck on p.id=ck.payment_id
 left join credit_payment cc on p.id=cc.payment_id;
具體子類查詢:
select id, payment_type, amount, currency
from payment p left join cash_payment c on p.id=c.payment_id;優點:表緊湊(無冗餘可空字段)、數據分區、超類表易關聯、緊湊表利於塊優化、修改併發性好(無熱點)。
缺點:表與連接最多、SQL 複雜、資料庫調優連接耗時、數據倉庫不適用、無法跨超類與子類字段建立複合索引、子類修改涉及兩表。
三張或更多表,多態查詢使用 UNION ALL 子查詢:
select p.id, p.amount, p.currency, p.rtn, p.credit_card_type, p.clazz
 from (select id, amount, currency, null as rtn, null as credit_card_type, 1 as clazz from cash_payment union all
 select id, amount, null as currency, rtn, null as credit_card_type, 2 as clazz from cheque_payment union all
 select id, amount, null as currency, null as rtn, credit_card_type, 3 as clazz from credit_payment) p;
具體子類查詢:
select id, payment_type, amount, currency from cash_payment;優點:類似「每個子類一張表」、超類通常抽象故具體表必須、子類修改僅涉及一表、運行更快。
缺點:SQL 過於複雜(FROM 子句與 UNION ALL)、關聯超類需觸發器實現引用完整性、影響資料庫性能。
三張表,多態查詢生成三條獨立 SQL,Hibernate 通過反射查找子類。具體子類查詢僅生成該子類 SQL。
優點:緊湊表、數據分區、修改僅涉及一表。
缺點:三條 SQL 替代一條聯合查詢增加網路 I/O、反射耗時、若從 Object 類隱式查詢將災難性。
交易描述應用初期僅有 GasDeal,用「每個類層次一張表」。後加入 OilDeal、ElectricityDeal,未變映射策略。ElectricityDeal 自有屬性過多導致 Deal 表大量可空字段,用戶增長下修改變慢。重構採用兩張獨立表分別針對氣/油與電屬性,混合「每個類層次一張表」與「每個子類一張表」,並重設計查詢允許針對具體子類選擇,消除多餘列與連接。
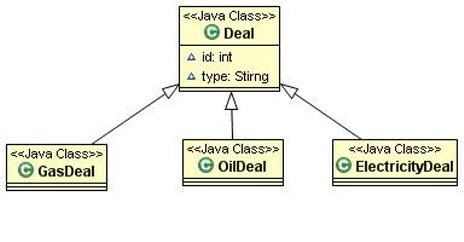
基於 4.1 節業務規則與設計調優,獲得 POJO 類圖。建議:
immutable;服務層方法僅處理只讀數據時,標記事務為唯讀,優化 Hibernate 與 JDBC 驅動。order-by 替代 sort,資料庫通常做得更好。核心 POJO ElectricityDeals 有多個 many-to-one 關聯。引用數據穩定,前端快取可按 ID 快速定位。為載入性能,ElectricityDeal 僅映射元數據(引用 POJO 的值類型 ID 屬性),如:
<property name="portfolioKey" column="PORTFOLIO_ID" type="integer"/>需時在前端通過 portfolioKey 從快取查找 Portfolio。此隱式關聯避免了資料庫表連接、額外字段選擇,降低數據傳輸量。
物理資料庫連接創建極耗時,必須使用生產級連接池,而非 Hibernate 內置基本算法。通常為 Hibernate 提供帶連接池的數據源。Apache DBCP BasicDataSource 是流行開源生產級數據源;多數資料庫廠商實現 JDBC 3.0 兼容連接池(如 Oracle RAC 提供的 JDBC 連接池可獲負載均衡與故障轉移)。通用調優參數:
短資料庫事務是高性能、高擴展應用的基石。用會話處理單個工作單元來處理事務。按工作單元範圍與事務邊界劃分,有三種模式:
關鍵注意點:
應用多數服務層方法僅操作資料庫 A,偶爾從資料庫 B 獲取唯讀數據。因 B 唯讀,這些方法在兩庫仍用本地事務。某方法需在兩庫執行數據變更,偽代碼:
@Transactional(readOnly=false, propagation=Propagation.REQUIRED)
public void saveIsoBids() {
    insertBidsInDatabaseA(); // 參與上方註解的本地事務
    insertBidRequestsInDatabaseB(); // 在資料庫 B 上運行自己的本地事務,必須是最後操作
}
因 insertBidRequestsInDatabaseB() 是最後方法,僅當 saveIsoBids() 返回時資料庫 A 本地事務提交失敗會導致不一致。但即便用 JTA,兩階段提交(2PC)第二階段失敗同樣面臨不一致。若能處理該不一致且不想為少數方法引入 JTA 複雜性,應使用本地事務。
(未完待續)
作者簡介
Yongjun Jiao,SunGard Consulting Services 技術主管,10 年專業軟體開發經驗,專長 Java SE/EE、Oracle、應用調優,近期關注高性能計算(內存數據網格、並行計算、網格計算)。
Stewart Clark,SunGard Consulting Services 負責人,15 年專業軟體開發與專案管理經驗,專長 Java 核心編程、Oracle、能源交易。