Java 操作 XML 可選標準 DOM 或多種 Java 專用模型。隨選擇增多,如何從功能、性能、易用性三維度抉擇成為難題。本文(系列第一部分)對六大主流模型進行全方位性能基準測試,第二部分將對比易用性代碼。
測試對象與版本
| 模型 | 版本 | Jar 大小 | 特點 |
|---|
| Crimson DOM | 1.1.1 | 0.2MB | Apache 項目,基於 Sun Project X,含驗證解析器 |
| Xerces DOM | 1.4.2 | 1.8MB | Apache 項目,源自 IBM XML4J,支援 Schema,含延遲節點擴展 |
| JDOM | Beta 0.7 | 0.1MB | Java 專用,具體類而非接口,大量用 Collections,目標「20% 精力解決 80% 問題」 |
| dom4j | 0.9 | 0.4MB | JDOM 早期分支,接口+抽象類,整合 XPath、Schema、事件流處理、並行 DOM 訪問 |
| Electric XML (EXML) | 2.2 | 0.05MB | 商業衍生品,極小,支援 XPath 子集,捨棄孤立空白,無驗證,受限許可證 |
| XML Pull Parser (XPP) | 2.0.1 Beta 8 | 0.04MB | 拉式解析,按需構建節點,極簡 API,不支援實體/註釋/處理指令 |
測試環境與數據集
- JDK 1.3.1 HotSpot Client VM,Athlon 1GHz,256MB RAM,RedHat 7.1,堆 128MB。
- 六種 XML:
much_ado.xml (202K、無屬性)、periodic.xml (117K)、soap1.xml (0.4K、重命名空間、重複 49 次)、soap2.xml (134K)、nt.xml (1MB、大量文本)、xml.xml (160K、混合內容)。
- 每測試跑 10 遍,取最短時間(HotSpot 動態優化導致平均值波動大)。
核心性能指標對比
1. 文檔構建時間(解析 + 構樹)
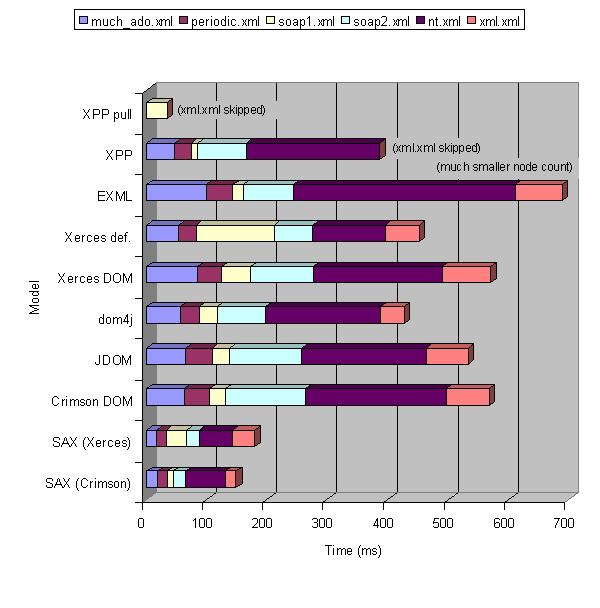
- XPP Pull:極快(延遲解析),僅
soap1.xml 因重複創建解析器實例顯慢(實際可池化複用)。
- Xerces Lazy:大文檔優勢明顯,小文檔開銷較大。
- dom4j / XPP (全量):整體持平。
- EXML:整體最差(雖捨棄空白但解析器效率低)。
2. 文檔遍歷時間
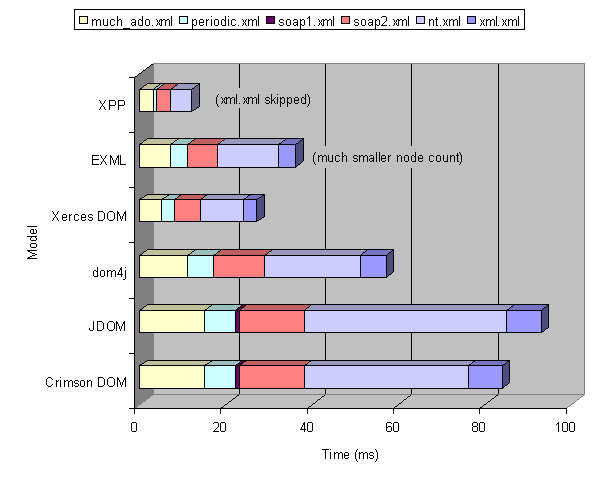
- XPP 絕對領先(約 Xerces 1/2,EXML 1/3)。
- 首次遍歷觸發 XPP Pull / Xerces Lazy 節點展開,有額外開銷;若僅部分訪問,Pull 模式優勢巨大。
3. 文檔修改時間(刪空白、包裝文本、加屬性)
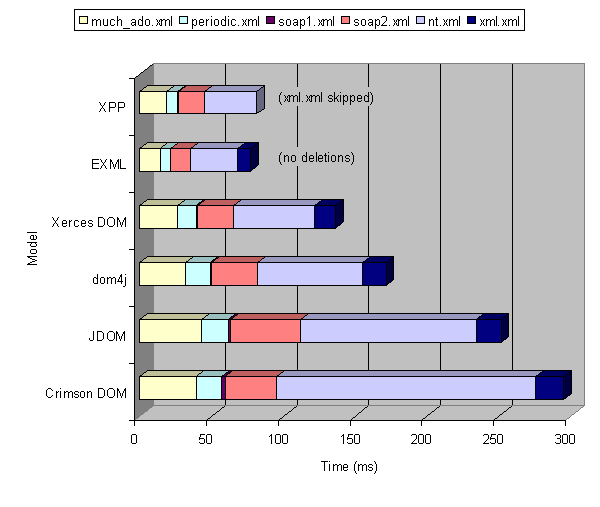
- EXML 領先(解析期已無孤立空白,無需刪除)。
- XPP 緊隨其後(含實際刪除操作)。
- Xerces / dom4j 居中,JDOM / Crimson 墊底。
4. 文本生成時間(樹寫回 XML)
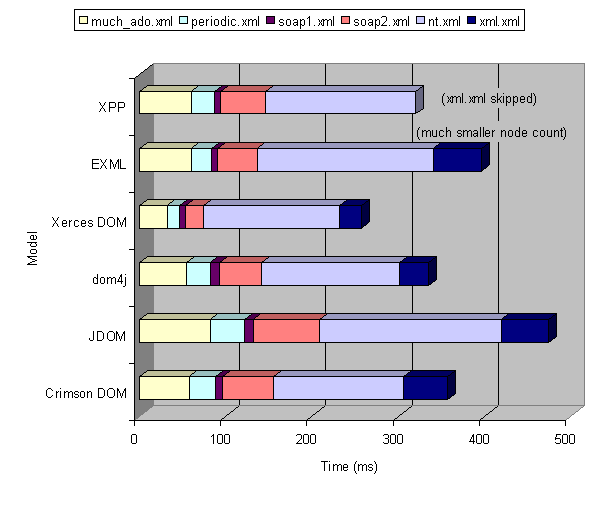
- 差距較小。Xerces 最優,JDOM 最慢。EXML 因少節點略勝 JDOM。
5. 內存佔用
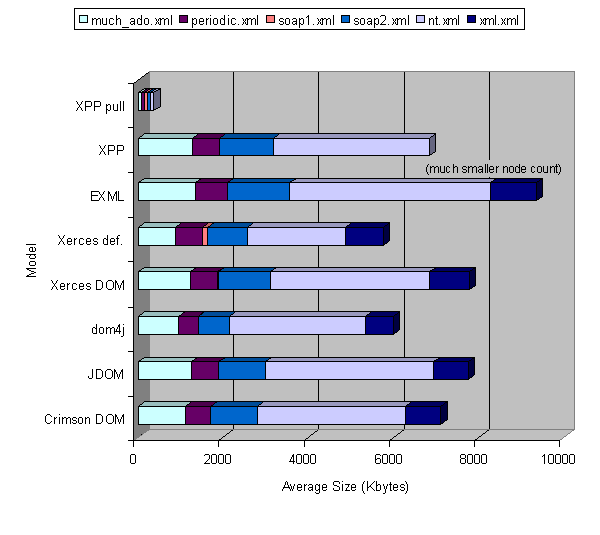
- Xerces Lazy 最緊湊(訪問前壓縮),dom4j 次之。
- 所有模型佔用約原始文本 4 倍。超大文檔首選 XPP Pull(按需構建)或 dom4j 事件流(流式處理)。
6. Java 序列化(RMI/EJB 傳遞場景)
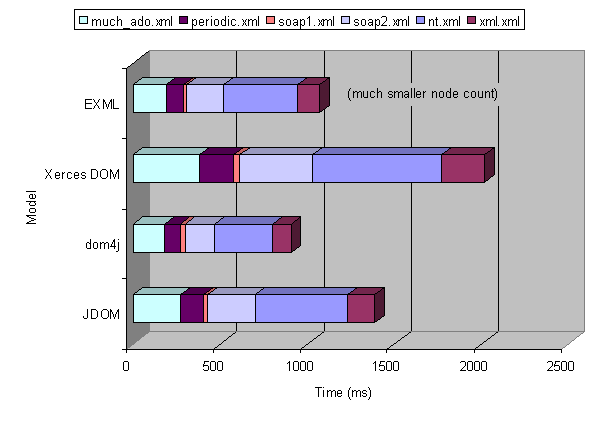
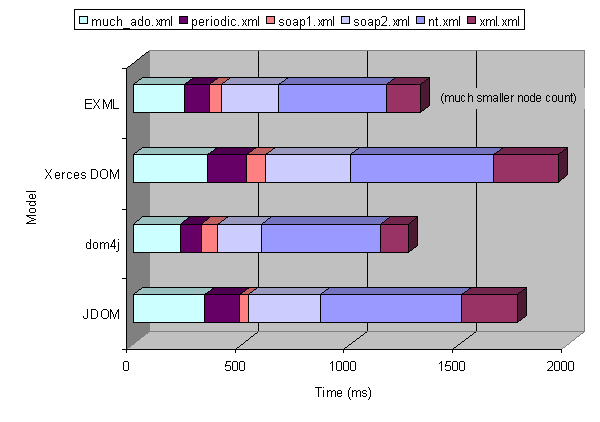
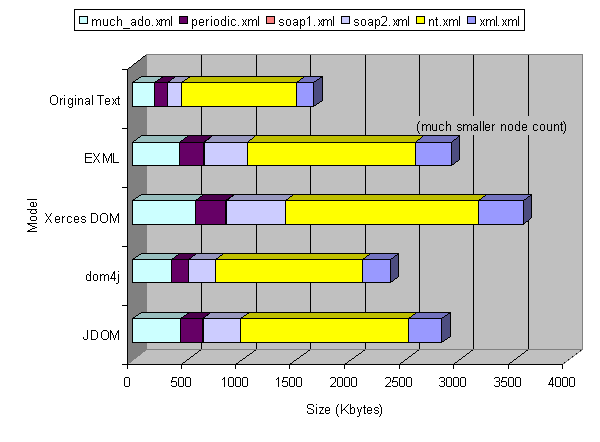
- dom4j 序列化/反序列化最快,體積最小。
- Xerces 最差。EXML 接近 dom4j(得益於少節點)。
- 結論:文本序列化 (寫 XML 再解析) 遠勝 Java 原生序列化(大量小對象結構不適合)。未來可期待定制二進制格式。
關鍵洞見
- 空白節點是隱形殺手:測試文檔多為「可讀性格式化」,孤立空白節點數超過元素數,拖垮所有模型(EXML 除外)。建議解析器層面提供「修剪可忽略空白」選項。
- 選型建議:
— 中間件/內存受限/無驗證需求 → XPP
— 通用 XML 處理、需 XPath/DOM 互操作 → dom4j 或 Xerces Lazy(大文檔)
— 跨語言兼容 → Xerces DOM
— JDOM / Crimson DOM 性能無優勢,不推薦新項目採用。