為應用添加搜索功能是常見需求。雖有 Lucene 等成熟庫,但從零構建搜索引擎仍繁瑣。針對中小型應用,本文提出一個可擴展框架:理想情況下僅需一個 Spring XML 配置文件即可啟動,特殊場景通過實現接口擴展。核心技術棧:Apache Lucene、Spring Framework、cpdetector(編碼檢測)、Commons Net(FTP 傳輸)等。
Document(含多個 Field)、Query、IndexSearcher、Hits。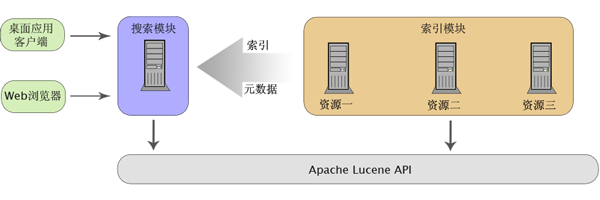
public interface Resource {
    int extractDocuments(ResourceProcessor processor);
    void addDocumentListener(DocumentListener listener);
    ResourceMetaData getMetaData();
}
| 屬性 | 類型 | 含義 |
|---|---|---|
| resourceName | String | 資源唯一名稱 |
| resourceDescription | String | 資源描述 |
| hitTextPattern | String | 搜索結果顯示模板 |
| searchableFields | String[] | 可搜索字段列表 |
public interface DocumentListener extends EventListener {
    void documentExtracted(Document doc);
}
用例:根據發布時間動態調整 Document.boost 值,實現時效性排序。
public interface DocumentBuilder {
    Document buildDocument(InputStream is);
}
| 文件類型 | 擴展名 | 解析庫 |
|---|---|---|
| 純文本 | txt | 無需庫 |
| RTF | rtf | javax.swing.text.rtf.RTFEditorKit |
| Word (舊) | doc | Apache POI + Scratchpad |
| Excel (舊) | xls | Apache POI + Scratchpad |
| PDFBox | ||
| HTML | htm/html | JTidy, Cobra |
文件類型判斷:優先用擴展名映射(properties 配置),必要時調用 Unix file 命令。
Document。fieldTypeMappings(Properties):ID=YES,NO、TITLE=YES,TOKENIZED、CONTENT=NO,TOKENIZED。public interface Transporter {
void transport(File file);
}
內置 FTP 實現(Commons Net),支持遞歸上傳目錄。可擴展 SFTP、HTTP、rsync 等,僅需替換配置中的 Bean 實現。
利用元數據 searchableFields 與 resourceName,自動組合 BooleanQuery,支持跨資源聯合搜索。
hitTextPattern語法:
${field_name} → 替換為該 Field 值。$function(arg1, arg2...) → 調用內置函數(如 $highlight(content, 50, "<b>", "</b>") 高亮關鍵詞)。解析建議:正則表達式或 JavaCC 生成詞法/語法分析器。
| 產品 | 定位 | 特點 |
|---|---|---|
| IBM OmniFind | 企業級 | UIMA 技術,優化 Lotus Domino/WebSphere Portal |
| Apache Solr | 企業級全文檢索 | HTTP 服務器,動態字段、分組過濾,基於 Lucene 擴展 |
| Google SiteSearch | 站內搜索 | 依賴 Google 爬蟲,無法訪問內網/受保護資源,不可擴展 |
| SearchBlox | 商業框架 | J2EE 組件,支持網頁/文件系統索引 |
框架由索引/搜索兩模塊組成,預留擴展接口,全基於開源組件。適合中小型應用快速落地搜索功能,亦可作為學習 Lucene 整合 Spring 的範例。