現代 Java 應用程式仰賴複雜的分散式依賴關係與眾多活動組件,外部因素隨時可能影響效能與可用性。這些影響難以完全消除,也難以在預生產環境精確模擬。然而,建立並維護一套全面監控整個應用生態系統的系統,能顯著降低事故的嚴重度與持續時間。
本系列文章提供實現此類系統的模式與技巧。透過範例程式碼與示意圖,幫助您理解應用程式效能監控(APM)的核心概念,並協助您選擇、擴充或設計商業或開源解決方案。
第 2 部分將介紹無需修改原始碼即可插裝 Java 類別與資源的方法;第 3 部分將論述監控 JVM 外部資源(主機、作業系統、資料庫、訊息系統等),並總結資料管理、虛擬化、報表與警示等 APM 進階議題。
雖然文中多數 Java 相關內容看似與程式碼效能分析相似,但兩者本質不同。效能分析是生產前流程,驗證程式碼是否具備擴展性、效率與速度;但根據「意外總會發生」公理,生產環境遇到無法解釋的問題時,優秀的開發階段分析可能無用武之地。
我們需要在生產環境實現效能分析的某些面向,從運行中的應用程式及其所有外部依賴收集即時資料。這些資料由一系列遍及目標的定量測量指標組成,為整個系統健康狀態提供細粒度、詳細的表示。保留這些指標的歷史庫,能捕獲準確基線,確認環境健康或查明特定缺陷根源與規模。
某些系統依賴未受監控,或監控資料不可存取。例如資料庫監控完善,但網路層缺乏覆蓋,診斷團隊無法看到網路故障對資料庫效能與應用伺服器的影響。
核心應用或其依賴對內部缺乏監控透明度。JVM 即典型黑盒。若診斷團隊僅擁有作業系統統計(CPU 使用率、記憶體大小),無法診斷垃圾收集或執行緒同步問題。
應用託管於大型共享資料中心,依賴共享資源(資料庫、SAN、訊息中介軟體)。組織高度孤立,各團隊只管理自己的監控系統,缺乏整合視圖,導致只能管中窺豹。
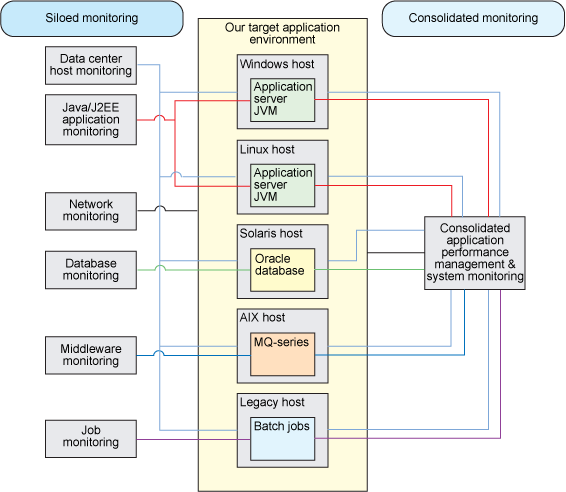
圖 1:孤立與整合 APM 系統對比
為解決孤立監控,運營團隊定期彙總各來源資料生成報表。但此法效率低、缺乏即時資料,且粒度不足導致重要模式隱沒。例如報表顯示某服務昨日平均耗時 200ms,卻隱藏了下午 1:00-1:45 平均耗時 3500ms 的尖峰。
工具資源開銷高,無法持續運行,導致基線建立不足,無法在問題惡化前預警,甚至可能加劇事態。
工具提供即時顯示但不支援持久化。缺乏歷史脈絡時,指標毫無價值。例如當前 CPU 45%,若不知歷史典型值與可接受上限,無法判斷負載輕重。
假設所有問題可在部署前消除,導致運行時監控不足。此假設無法應對不可預測事件與依賴故障,診斷團隊面對此類事件時束手無策。
所有 APM 系統皆存取效能資料源(PDS),提供資料收集與追蹤工具。以下為本文使用的通用術語定義:
反映組件相對健康狀態的效能或可用性資料來源。分為:
綜合交易能有效測定多組件或分層呼叫,並在直接源無法勝任時(如系統相對空閒期)確認系統健康,對監控連續性至關重要。
從 PDS 獲取資料的流程。直接 PDS 的收集器通常實作 API 存取資料(如 SNMP、Telnet);推斷 PDS 的收集器執行並測量底層操作。
收集器向核心 APM 系統交付測量資料的流程。商業與開源 APM 系統提供 API 供此用途。本文實作通用 Java 追蹤程式介面 org.runtimemonitoring.tracing.ITracer。
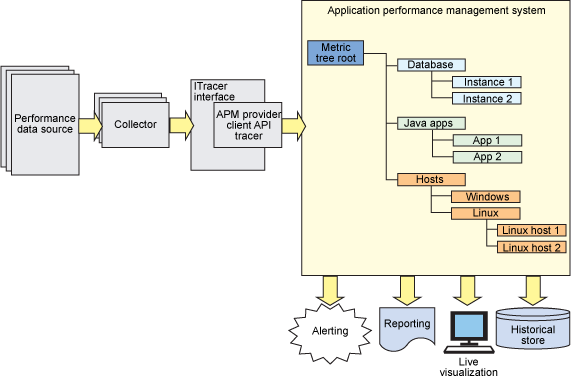
圖 2:收集、追蹤與 APM 系統
APM 系統常見服務:即時顯示、報表生成、歷史庫、警示通知(郵件、自訂鉤子介面)。
Java 適合作為收集器實作語言:跨平台、效能優異、支援並發與同步、豐富通訊協定、廣泛第三方 API 支援(JDBC、SNMP 等)、活躍開源社群。
為解決不同 APM 產品追蹤 API 不一的問題,本文實作通用介面 ITracer 作為專用 API 的包裝器,確保原始碼庫不因版本或提供者而異,並支援實作包裝 API 中不可用的額外功能。
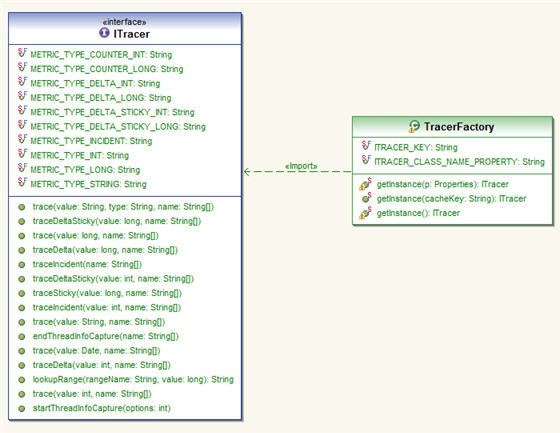
圖 3:ITracer 介面與工廠類 UML 類圖
trace 方法提交度量與相關名稱,接受 String[] name 參數包含複合名稱的上下文組件。複合名稱指示命名空間與實際指標名稱,通常至少包含根類別與度量說明。TracerFactory 根據配置屬性建立 ITracer 實例。
| 名稱結構 | 複合名稱 |
|---|---|
| 簡單斜線分隔 | Hosts/SalesDatabaseServer/CPU Utilization/CPU3 |
| JMX MBean ObjectName | com.myco.datacenter.apm:type=Hosts,service=SalesDatabaseServer,group=CPU Utilization,instance=CPU3 |
表 1:複合命名慣例範例
APM 供應商可能支援其他類型。
trace(long/int value, String[] name),每次提交轉化為當前時間間隔聚合值,新間隔開始時重置traceSticky(long/int value, String[] name),值保留於時間間隔中,直到提供新值traceIncident(String[] name) 隱式遞增一次;traceIncident(int value, String[] name) 依值遞增固定頻率調用收集器檢索 PDS 當前值。假定輪詢間隔中值不變,通常使用黏著追蹤類型。例如每分鐘讀取主機 CPU 使用率或透過 JMX 讀取交易管理器提交總數。
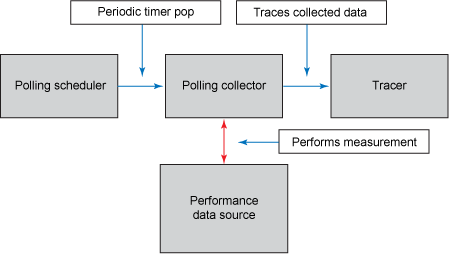
圖 4:輪詢收集模式
收集器註冊為 PDS 事件監聽器,相關事件發生時接收回調。追蹤值取決於回調內容,至少可追蹤每個回調事件。
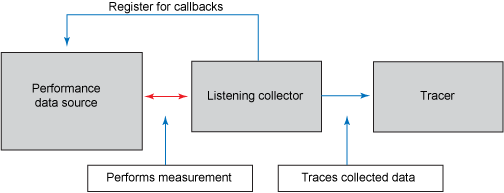
圖 5:監聽收集模式
收集器作為截取程式插入目標與呼叫者之間。對通過的每個活動實例生成度量並追蹤。可測量請求數、回應時間、請求/回應負載大小。假定能「看到」每個事件,通常使用平均時間間隔類型。
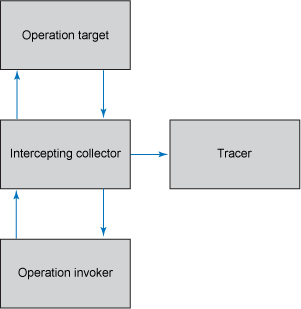
圖 6:截取收集模式
從 JVM 開始實現效能監控是明智選擇。Java SE 5 前,內部標準化 JVM 診斷資訊有限。java.lang.management 介面提供標準監控點,所有相容 JVM 皆支援。重點介紹透過 MXBeans 存取的標準模式——部署在 VM 內部的 JMX MBeans 公開管理監控介面:
ClassLoadingMXBean:監控類別載入系統CompilationMXBean:監控編譯系統GarbageCollectionMXBean:監控垃圾收集器MemoryMXBean:監控堆與非堆記憶體空間MemoryPoolMXBean:監控 JVM 配置的記憶體池RuntimeMXBean:監控運行時系統(提供 JVM 參數、啟動時間、運行時間)ThreadMXBean:監控執行緒系統PlatformMBeanServer 存取 MXBeans示例收集器包含三種獲取 MBeanServerConnection 的方法:本地平台 MBeanServer、本地備用 MBeanServer、遠程 RMI Remoting。以下為 collect() 方法片段,展示 ThreadMXBean 收集與執行緒追蹤:
public void collect() {
    CompositeData compositeData = null;
    String type = null;
    try {
        log("Starting JMX Collection");
        long start = System.currentTimeMillis();
        ObjectName on = null;
        // Thread Monitoring
        on = objectNameCache.get(THREAD_MXBEAN_NAME);
        tracer.traceDeltaSticky((Long)jmxServer.getAttribute(on,"TotalStartedThreadCount"),
            hostName, "JMX", on.getKeyProperty("type"), "StartedThreadRate");
        tracer.traceSticky((Integer)jmxServer.getAttribute(on, "ThreadCount"), hostName,
            "JMX", on.getKeyProperty("type"), "CurrentThreadCount");
        // Done
        long elapsed = System.currentTimeMillis()-start;
        tracer.trace(elapsed, hostName, "JMX", "JMX Collector",
            "Collection", "Last Elapsed Time");
        tracer.trace(new Date(), hostName, "JMX", "JMX Collector",
            "Collection", "Last Collection");
        log("Completed JMX Collection in " + elapsed + " ms.");
    } catch (Exception e) {
        log("Failed:" + e);
        tracer.traceIncident(hostName, "JMX", "JMX Collector",
            "Collection", "Collection Errors");
    }
}
程式碼追蹤 TotalThreadsStarted 與 CurrentThreadCount。輪詢收集器使用黏著選項;TotalThreadsStarted 持續遞增,關注建立速率,故使用 DeltaSticky。
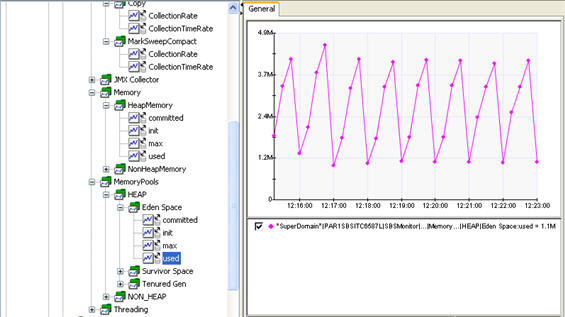
圖 7:JMX 收集器 APM 指標樹
getAttributes(ObjectName, String[]) 一次請求多屬性,減少網路呼叫(遠程收集顯著受益)理想情況下收集器實作資料存取方式,內容由外部配置提供,提升重用性。配置點包括:PDS 連線工廠指令、收集頻率、重連頻率、目標 MBean、追蹤複合名稱與資料類型。
<?xml version="1.0" encoding="UTF-8"?>
<JMXCollector>
  <attribute name="ConnectionFactoryClassName">
    collectors.jmx.RemoteRMIMBeanServerConnectionFactory
  </attribute>
  <attribute name="ConnectionFactoryProperties">
    jmx.rmi.url=service:jmx:rmi://127.0.0.1/jndi/rmi://127.0.0.1:1090/jmxconnector
  </attribute>
  <attribute name="NamePrefix">AppServer3.myco.org,JMX</attribute>
  <attribute name="PollFrequency">10000</attribute>
  <attribute name="TargetAttributes">
    <TargetAttributes>
      <TargetAttribute objectName="java.lang:type=Threading"
        attributeName="ThreadCount" Category="Threading"
        metricName="ThreadCount" type="SINT"/>
      <TargetAttribute objectName="java.lang:type=Compilation"
        attributeName="TotalCompilationTime" Category="Compilation"
        metricName="TotalCompilationTime" type="SDINT"/>
    </TargetAttributes>
  </attribute>
</JMXCollector>
type 屬性對應智能類型追蹤參數:SINT=黏著 int,SDINT=增量黏著 int。
Java EE 架構可透過 JMX 公開應用專屬指標。典型範例為 DataSource 使用率——連線池化服務,限制並發連線保護資源。監控資料源是整體監控關鍵環節。JBoss 4.2 典型資料源指標:可用連線數、連線數、最大使用連線數、使用中連線數、已建立連線數、已部署連線數。
收集器使用批次屬性檢索,一次呼叫獲取所有屬性。DataSource 指標無活動時不變,需產生負載使數值變化。
public void collect() {
    try {
        log("Starting DataSource Collection");
        long start = System.currentTimeMillis();
        ObjectName on = objectNameCache.get("DS_OBJ_NAME");
        AttributeList attributes = jmxServer.getAttributes(on, new String[]{
            "AvailableConnectionCount", "MaxConnectionsInUseCount",
            "InUseConnectionCount", "ConnectionCount",
            "ConnectionCreatedCount", "ConnectionDestroyedCount"
        });
        for(Attribute attribute: (List<Attribute>)attributes) {
            if(attribute.getName().equals("ConnectionCreatedCount")
                || attribute.getName().equals("ConnectionDestroyedCount")) {
                tracer.traceDeltaSticky((Integer)attribute.getValue(), hostName,
                    "DataSource", on.getKeyProperty("name"), attribute.getName());
            } else {
                if(attribute.getValue() instanceof Long) {
                    tracer.traceSticky((Long)attribute.getValue(), hostName, "DataSource",
                        on.getKeyProperty("name"), attribute.getName());
                } else {
                    tracer.traceSticky((Integer)attribute.getValue(), hostName,
                        "DataSource", on.getKeyProperty("name"), attribute.getName());
                }
            }
        }
        // Done
        long elapsed = System.currentTimeMillis()-start;
        tracer.trace(elapsed, hostName, "DataSource", "DataSource Collector",
            "Collection", "Last Elapsed Time");
        tracer.trace(new Date(), hostName, "DataSource", "DataSource Collector",
            "Collection", "Last Collection");
        log("Completed DataSource Collection in " + elapsed + " ms.");
    } catch (Exception e) {
        log("Failed:" + e);
        tracer.traceIncident(hostName, "DataSource", "DataSource Collector",
            "Collection", "Collection Errors");
    }
}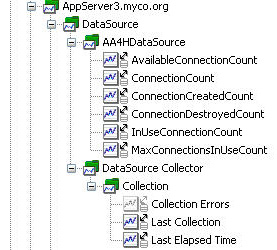
圖 8:DataSource 收集器指標樹
主要監控領域:呼叫速率、回應速率、錯誤率、執行時間(平均/最短/最長)、並發性。利用 ThreadMXBean 尚可收集:系統/使用者 CPU 時間、等待計數與總等待時間、阻塞計數與總阻塞時間。
收集上述指標需透過插裝類別與方法。技巧包括:
本文第 1 部分僅討論基於原始碼的插裝;第 2 部分介紹截取、位元碼插裝與類別包裝。
插裝直接修改核心程式碼執行,目標必須不產生危害,開銷損失需盡可能接近可忽略。獲取效能資料後,保持其餘追蹤流程非同步至關重要。簡單插裝截取程式捕獲呼叫起始時間測量執行時間,將測量資料分發給處理佇列,執行緒池讀取佇列完成追蹤流程。
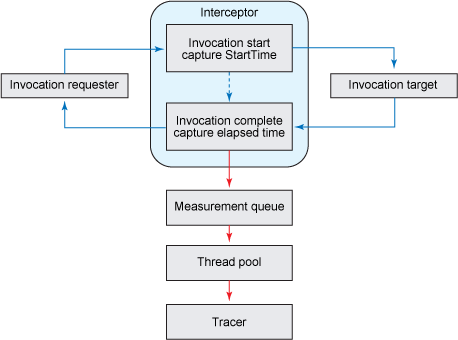
圖 9:非同步追蹤
雖有其他流行選擇,原始碼插裝在某些情況下無法避免,甚至是唯一解決方案。需考慮:使用可配置、靈活的追蹤 API;類似 log4j 的運行時冗長控制與輸出端點配置;上下文追蹤——為主要資料添加上下文的效能資料。
processPayroll(long clientId) 方法處理員工薪資。執行時間與員工數量不成比例,若不知每次處理員工數,無法判斷效能優劣。程式碼中無法直接追蹤員工數量。
public void processPayrollContextual(long clientId) {
    Collection<Employee> employees = popEmployees();
    int empCount = 0;
    String rangeName = null;
    long start = System.currentTimeMillis();
    for(Employee emp: employees) {
        processEmployee(emp.getEmployeeId(), clientId);
        empCount++;
    }
    rangeName = tracer.lookupRange("Payroll Processing", empCount);
    long elapsed = System.currentTimeMillis()-start;
    tracer.trace(elapsed, "Payroll Processing", rangeName, "Elapsed Time (ms)");
    tracer.traceIncident("Payroll Processing", rangeName, "Payrolls Processed");
    log("Processed Client with " + empCount + " employees.");
}
關鍵在 tracer.lookupRange 呼叫。範圍為數值區間限定鍵的指定收集,擁有表示區間名稱的 String 值。將員工計數劃分為範圍,有效分隔執行時間並按相似員工數分組。
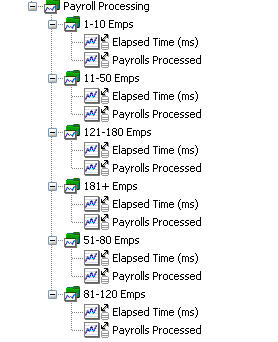
圖 10:依範圍分組的薪資處理時間
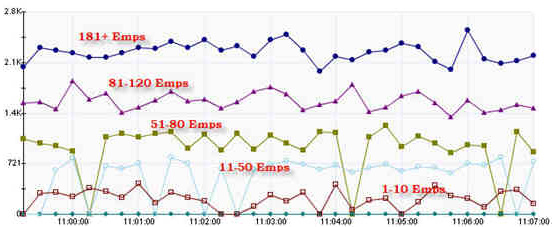
圖 11:各範圍薪資處理執行時間
外部屬性檔定義範圍與閾值,tracer.lookupRange 實作讀取此配置。範例:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "https://java.sun.com/dtd/properties.dtd">
<properties>
  <comment>Payroll Process Range</comment>
  <entry key="L:Payroll Processing">181+ Emps,10:1-10 Emps,50:11-50 Emps,
    80:51-80 Emps,120:81-120 Emps,180:121-180 Emps</entry>
</properties>
外部定義範圍使應用程式無需頻繁更新原始碼,適應業務層面的 SLA 變更。
外部可配置上下文追蹤支援精確定義效能閾值。範圍定義數值區間分類測量資料;閾值進一步依測量資料所屬範圍分類。常見需求:確認執行「成功」或「失敗」(未在指定時間內發生),彙總作為系統健康狀況成績單或 SLA 合規評價。
以薪資處理為例,內部服務等級目標定義三區間:Ok、Warn、Critical。閾值配置使用正則表達式匹配指標複合名稱,匹配時將測量資料分類並發起額外 traceIncident。配置範例:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "https://java.sun.com/dtd/properties.dtd">
<properties>
  <!-- Payroll Processing Thresholds -->
  <entry key="Payroll Processing.*81-120 Emps.*Elapsed Time \(ms\)">1100,1500</entry>
  <entry key="Payroll Processing.*1-10 Emps.*Elapsed Time \(ms\)">280,400</entry>
  <entry key="Payroll Processing.*11-50 Emps.*Elapsed Time \(ms\)">850,1200</entry>
  <entry key="Payroll Processing.*51-80 Emps.*Elapsed Time \(ms\)">900,1100</entry>
  <entry key="Payroll Processing.*121-180 Emps.*Elapsed Time \(ms\)">1400,2000</entry>
  <entry key="Payroll Processing.*181\+ Emps.*Elapsed Time \(ms\)">2000,3000</entry>
</properties>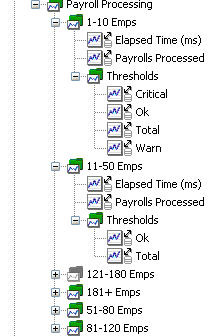
圖 12:添加閾值的薪資處理指標樹
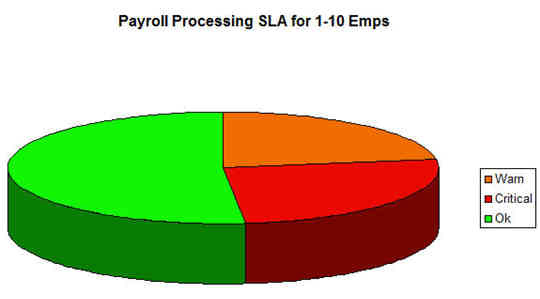
圖 13:薪資處理 SLA 彙總(1-10 員工)
為確保效率,ITracer 實作中指標名稱首次發現時存入線程安全映射,閾值確定僅需 Map 查找。若條目極多,可延遲至非同步追蹤執行緒池處理。
本文介紹監控反模式與 APM 系統所需屬性,總結通用效能資料收集模式,介紹 ITracer 介面。示範監控 JVM 健康狀態技巧、透過 JMX 獲取通用效能資料,以及高效、防程式碼變更的原始碼層級插裝方法(監控原始效能統計與上下文衍生統計),並說明如何用這些統計生成應用程式 SLA 報告。第 2 部分將探討無需修改應用程式原始碼即可插裝 Java 系統的技巧:截取、類別包裝與動態位元碼插裝。