文件物件模型(DOM)作為 W3C 標準,提供跨平台、跨語言的 XML 動態存取介面。其「一切皆節點」的抽象設計雖概念完美,卻帶來使用困難:文字值分散於多個子節點、NodeList 取代熟悉的 List/Iterator、工廠方法取代 new 建構式。這些語言無關性的代價,導致程式碼冗長、脆弱、易錯。
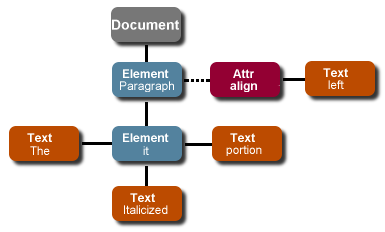
透過 getFirstChild() 盲目導航極易因空白文字節點、文件結構變異而失效。健壯程式碼需逐層檢查節點類型與名稱、驗證非 null,導致大量樣板碼。
元素文字實際儲存於子文字節點,單純呼叫 getData() 無效。需遍歷所有子節點、過濾 TEXT_NODE、串接值。JDOM 的 getText() 與 DOM Level 3 規劃的 getTextContent() 正是為解決此痛點。
此方法會遞迴搜尋整棵子樹,若文件中多處存在同名標籤(如客戶、產品、公司皆有 name),將回傳混雜結果,導致邏輯錯誤。
JDOM 針對 Java 語言特性重新設計 API:具體類別取代節點介面、String 直接表示文字、標準 Collection 介面取代 NodeList、支援 new 建構式。雖已成 JSR 標準且可能納入核心平台,但非核心 API 地位與 Iterator 效能疑慮,使部分企業仍堅持使用標準 DOM。
XPath 使用類檔案系統路徑語法(/x/y/z、/x/y/*、/x/y[@name='a'])精準定位節點。內建過濾空白文字節點、支援屬性值比對、結構與內容混合查詢。掌握 XPath 可徹底改變 XML 處理體驗。
// 結合 XPathAPI.selectSingleNode 與 getTextContents
public String findValue(Node context, String xpathExpr) {
    Node target = XPathAPI.selectSingleNode(context, xpathExpr);
    return (target != null) ? getTextContents(target) : null;
}// 移除所有子節點後設定新文字內容
public void setValue(Node context, String xpathExpr, String newValue) {
Node target = XPathAPI.selectSingleNode(context, xpathExpr);
if (target != null) {
// 清空現有子節點
while (target.hasChildNodes()) target.removeChild(target.getFirstChild());
target.appendChild(target.getOwnerDocument().createTextNode(newValue));
}
}// 依 XPath 定位父節點並附加新元素
public Element appendNode(Node parentContext, String newNodeName, String parentXPath) {
Node parent = XPathAPI.selectSingleNode(parentContext, parentXPath);
Element newElem = parent.getOwnerDocument().createElement(newNodeName);
parent.appendChild(newElem);
return newElem;
}DOM 的語言無關性換來廣泛適用性,犧牲了易用性。遵循「XPath 導航 + 輔助庫封裝」原則,可在現有 DOM 基礎上構建高效、可維護的 XML 處理系統。JDOM 等專案正改善 Java 體驗,DOM Level 3 亦規劃解決核心痛點。善用現有工具與模式,讓 DOM 成為 XML 專案的堅實平台而非絆腳石。