並發編程模型兩大流派
| 維度 | 共享內存模型 | 消息傳遞模型 |
|---|
| 通信機制 | 隱式:讀寫公共狀態 | 顯式:發送/接收消息 |
| 同步機制 | 顯式:程序員指定互斥區 | 隱式:發送必在接收前 |
Java 採用 共享內存模型,線程通信隱式進行,完全透明。不理解底層機制極易遇到可見性問題。
JMM 抽象結構:主內存與本地內存
- 共享變量(實例域、靜態域、數組元素)存儲於主內存
- 每線程擁有私有本地內存,持有共享變量副本
- 本地內存為抽象概念,涵蓋緩存、寫緩衝區、寄存器、編譯器優化等
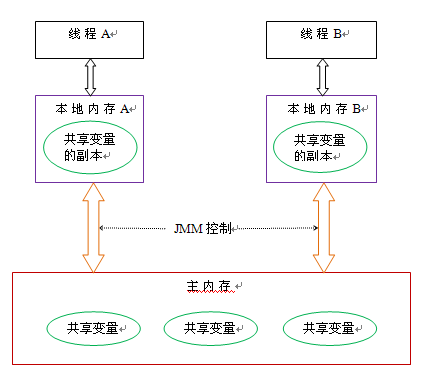
線程通信兩步走
- 線程 A 將本地內存更新刷新至主內存
- 線程 B 從主內存讀取 A 更新後的值
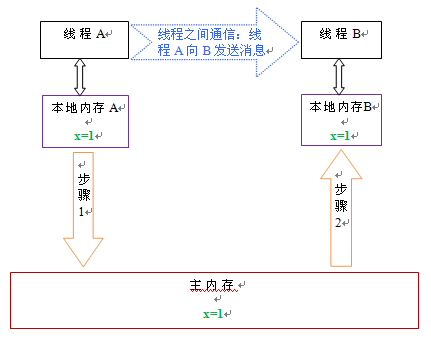
本質:線程 A 向線程 B 發送消息,必須經過主內存。JMM 控制主/本地內存交互,提供可見性保證。
重排序三大來源
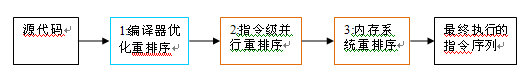
| 類型 | 來源 | 屬於 |
|---|
| 編譯器優化重排序 | 編譯器 | 編譯器重排序 |
| 指令級並行重排序 | 處理器 ILP | 處理器重排序 |
| 內存系統重排序 | 緩存/寫緩衝區 | 處理器重排序 |
JMM 策略:禁止特定類型編譯器重排;要求編譯器插入內存屏障指令禁止特定處理器重排。**不禁止所有重排**,在保證可見性前提下最大化性能。
處理器重排序根源:寫緩衝區
- 寫緩衝區確保指令流水線持續運行,批量刷新減少總線佔用
- **關鍵特性**:寫緩衝區僅對當前處理器可見
- 導致:處理器執行順序 ≠ 內存實際發生順序
示例:雙處理器並行寫讀,最終可能得 x=y=0 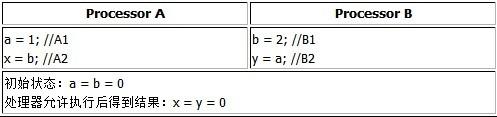
時序分析:A1/B1 進寫緩衝區 → A2/B2 讀內存 → A3/B3 刷寫緩衝區。實際內存順序 A2→A1,發生重排。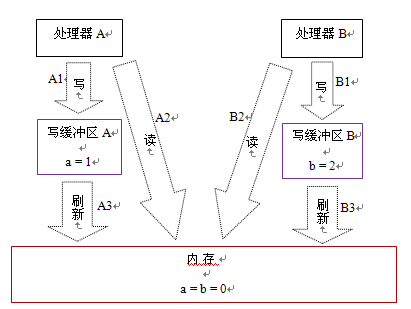
**結論**:現代處理器均使用寫緩衝區 → **均允許 Store-Load (寫-讀) 重排**。
常見處理器允許重排序表
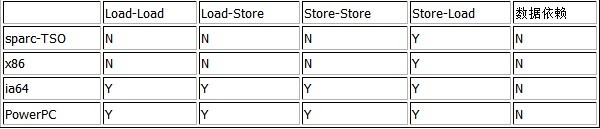
- 所有處理器允許 Store-Load 重排
- 所有處理器禁止數據依賴操作重排
- SPARC-TSO / x86 模型較強,僅允許 Store-Load
內存屏障四大類型
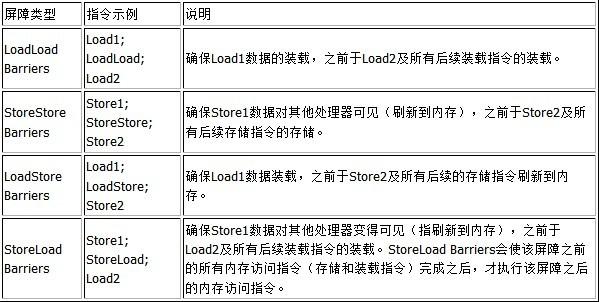
- StoreLoad:全能型,具備其它三種效果,開銷最大(刷寫緩衝區)
- 現代多處理器多支援 StoreLoad,其它屏障不一定全支持
happens-before 核心規則
JSR-133 引入,闡述操作間可見性:若操作 A 結果需對操作 B 可見,則 A hb B。
| 規則 | 內容 |
|---|
| 程序順序 | 線程內每操作 hb 於任意後續操作 |
| 監視器鎖 | 解鎖 hb 於隨後對同鎖加鎖 |
| volatile 變量 | 寫 hb 於任意後續讀 |
| 傳遞性 | A hb B ∧ B hb C ⇒ A hb C |
核心認知:hb **不意味著時間先後**,僅要求結果可見且順序排在前。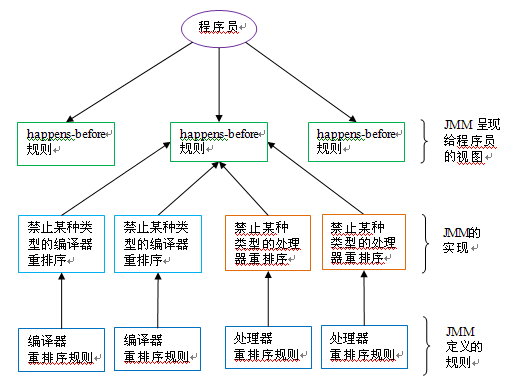
一條 hb 規則對應多條編譯器/處理器重排序規則,為程序員屏蔽底層複雜度。
- 上一篇文章: 深入理解Java內存模型(二):重排序類型、as-if-serial語義與多線程影響實例剖析
- 下一篇文章: Tomcat Web項目部署三大主流方式詳解與最佳實踐建議
Copyright ©
程式碼之家 All Rights Reserved