現代處理器為追求性能,對順序一致性模型進行不同程度放寬,形成強弱不同的內存模型:
| 模型 | 典型處理器 | Store-Load | Store-Store | Load-Load/Load-Store | 備註 |
|---|---|---|---|---|---|
| TSO | SPARC-TSO, x86/x64 | Y | N | N | 僅允許寫-讀重排,寫緩衝區導致 |
| PSO | SPARC-PSO | Y | Y | N | 進一步放寬寫-寫 |
| RMO | IA64 | Y | Y | Y | 全面放寬,極弱模型 |
| PowerPC | PowerPC | Y | Y | Y | 含控制依賴重排 |
關鍵共性:所有模型均允許 Store-Load 重排(寫緩衝區特性),且當前處理器可提前讀見自身寫入。
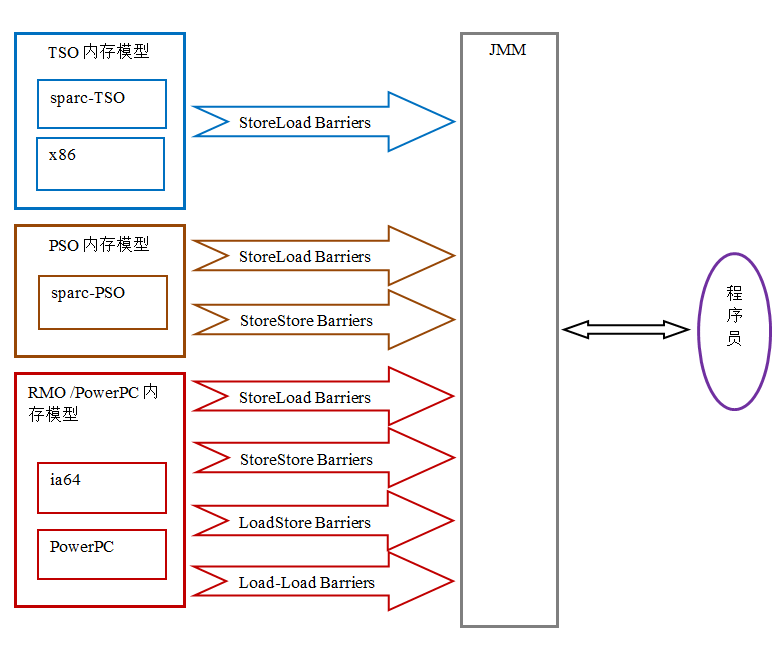
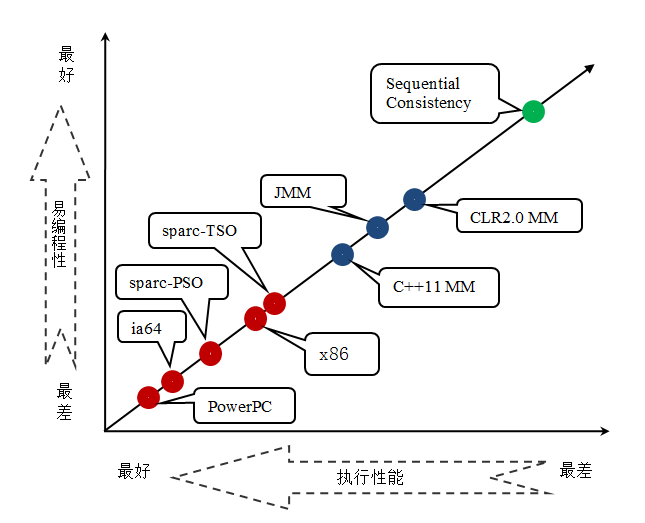
順序一致性 > 語言內存模型(JMM、C++11 等)> 處理器內存模型。追求性能的語言/處理器傾向設計更弱模型。
double pi = 3.14; // A
double r = 1.0;   // B
double area = pi * r * r; // C
存在 3 個 happens-before:A→B、B→C、A→C(傳遞性)。但 A→B 重排不影響結果,JMM 允許此類「不改變單線程語義」的重排序。
| 重排序類型 | JMM 策略 |
|---|---|
| 改變程序結果 | 強制禁止(編譯器+處理器) |
| 不改變程序結果 | 允許(最大化優化空間) |
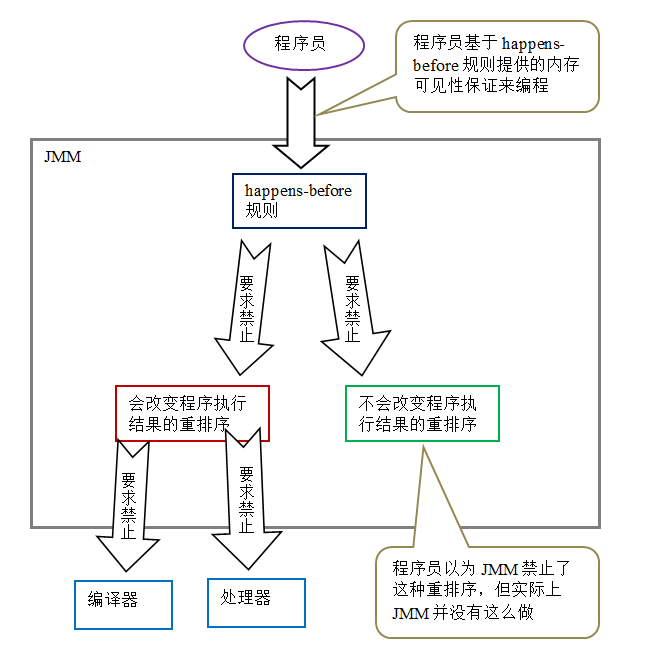
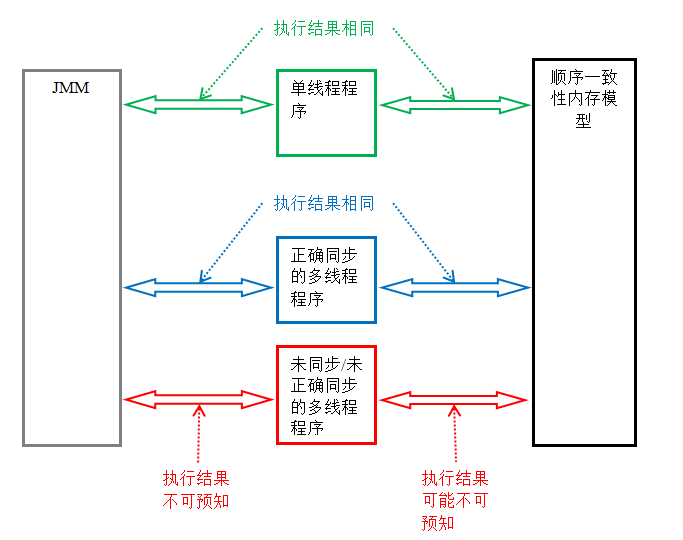
JMM 以 happens-before 為核心抽象,向上給程序員提供簡單強一致性承諾,向下通過屏障插入適配多樣硬件,實現了「正確同步程序跨平台行為一致」的工程奇蹟。