在 Java 集合框架中,HashMap 無疑是使用頻率最高、也是面試與實戰中最核心的鍵值對存儲結構。本文將從整體架構、源碼核心邏輯、擴容機制、遍歷方式到實戰示例,為你全方位拆解 HashMap 的內部運作原理。
AbstractMap,實現 Map、Cloneable、Serializable 接口。ConcurrentHashMap。null 鍵與 null 值(null 鍵固定存放在 table[0])。16(必須是 2 的冪次)。0.75f。這是時間與空間的折衷——過大增加查詢成本,過小頻繁觸發擴容。size >= threshold 時觸發 resize()(容量翻倍)。java.lang.Object
java.util.AbstractMap<K,V>
java.util.HashMap<K,V>
public class HashMap<K,V> extends AbstractMap<K,V>
implements Map<K,V>, Cloneable, Serializable { }HashMap():默認容量 16,加載因子 0.75。HashMap(int initialCapacity):指定初始容量。HashMap(int initialCapacity, float loadFactor):完全自定義。HashMap(Map<? extends K, ? extends V> m):從現有 Map 複製數據。static final int DEFAULT_INITIAL_CAPACITY = 16;
static final int MAXIMUM_CAPACITY = 1 << 30;
static final float DEFAULT_LOAD_FACTOR = 0.75f;
transient Entry<K,V>[] table; // 存儲數據的 Entry 數組
transient int size; // 實際鍵值對數量
int threshold; // 擴容閾值
final float loadFactor; // 加載因子
transient volatile int modCount; // 修改次數,用於 fail-faststatic class Entry<K,V> implements Map.Entry<K,V> {
final K key;
V value;
Entry<K,V> next; // 指向下一個節點,形成單向鏈表
final int hash; // key 的哈希值緩存
// 構造函數、getKey、getValue、setValue、equals、hashCode 等...
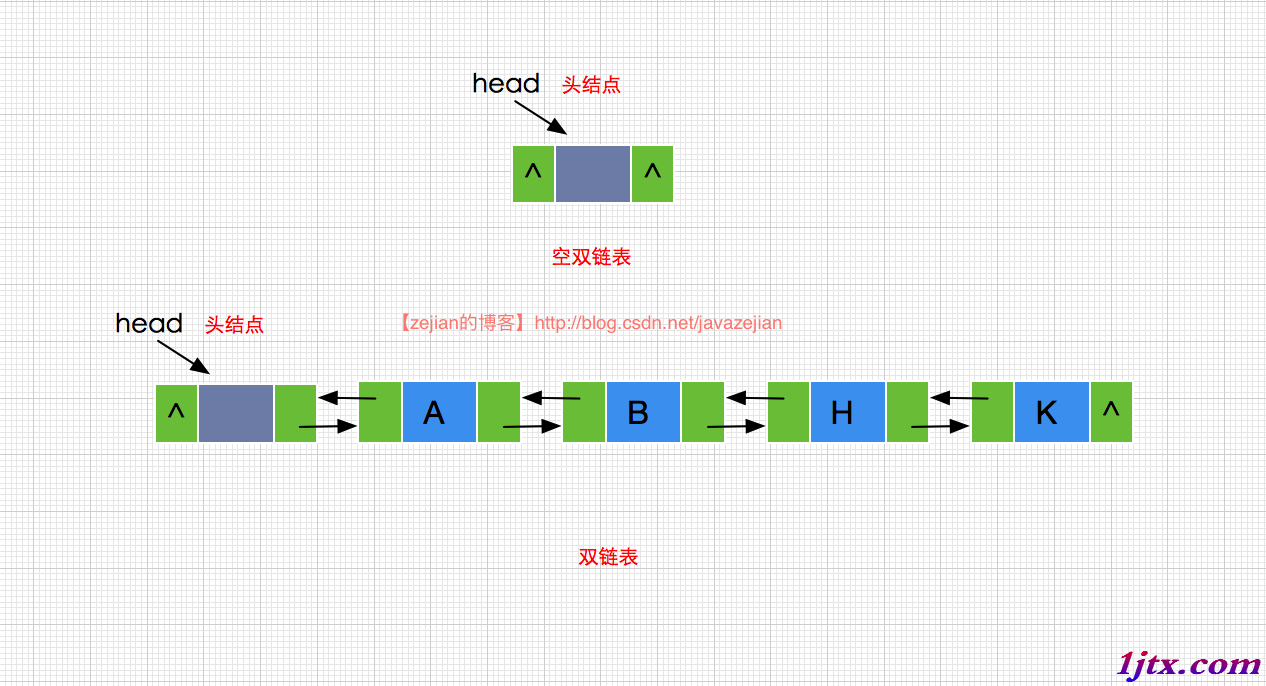
}table[i] 是一條單向鏈表頭節點,哈希衝突通過「拉鏈法」解決。
// 擾動函數:將 hashCode 高位信息混合到低位,減少碰撞
static int hash(int h) {
    h ^= (h >>> 20) ^ (h >>> 12);
    return h ^ (h >>> 7) ^ (h >>> 4);
}

// 索引計算:利用位運算替代取模,前提是 length 必須是 2 的冪次
static int indexFor(int h, int length) {
    return h & (length - 1);
}key == null,直接檢索 table[0] 鏈表。hash(key.hashCode()),定位到 table[index]。hash 並用 key.equals(k) 確定唯一性,命中返回 value,否則返回 null。key == null → putForNullKey(value) 操作 table[0]。e.hash == hash && key.equals(e.key) → 替換舊值,返回舊值。addEntry(hash, key, value, index) 以「頭插法」插入新節點。size++,若 size >= threshold → resize(2 * table.length)。addEntry:普通插入,檢查是否需擴容(put()、putAll() 調用)。createEntry:構造函數/克隆/反序列化時批量導入,已預先保證容量足夠,無需擴容檢查。new Entry[newCapacity]。transfer(newTable):遍歷舊數組每條鏈表,重新計算每個節點在新數組中的索引,同樣採用頭插法遷移(注意:JDK 7 為頭插法,高併發下可能導致鏈表成環,JDK 8 改為尾插法保持原序)。table 引用與 threshold。本質是「刪除單向鏈表節點」:定位桶位,維護 prev 指針,找到目標節點後將 prev.next = next,修改 modCount、size--。
HashIterator 為抽象父類,持有 expectedModCount = modCount。每次 nextEntry() 前調用 checkForComodification() 比對;若不一致拋出 ConcurrentModificationException。注意:fail-fast 只為檢測邏輯錯誤,不可依賴於併發控制。
writeObject:寫入 threshold、loadFactor、桶數量 table.length、size,然後遍歷 entrySet 依次寫入 key、value。readObject:按寫入順序讀取,重建 table,調用 putForCreate 填充數據。// 1. entrySet(推薦,單次遍歷同時獲取 key/value)
for (Map.Entry<K,V> entry : map.entrySet()) {
K key = entry.getKey();
V value = entry.getValue();
}
// 2. keySet + get(兩次查找,效率較低)
for (K key : map.keySet()) {
V value = map.get(key);
}
// 3. values(僅需 value 時使用)
for (V value : map.values()) { ... }entrySet 遍歷最快,避免重複 get 查找。keySet 需額外 get,性能損耗明顯。forEach、stream() 簡化代碼。import java.util.*;
public class HashMapDemo {
public static void main(String[] args) {
Map<String, Integer> map = new HashMap<>();
// 基礎增刪改查
map.put("apple", 10);
map.put("banana", 20);
map.put("orange", 15);
System.out.println("初始 map: " + map);
// 獲取與判斷
System.out.println("apple 數量: " + map.get("apple"));
System.out.println("是否包含 grape: " + map.containsKey("grape"));
// 遍歷
System.out.println("\n--- entrySet 遍歷 ---");
for (Map.Entry<String, Integer> e : map.entrySet()) {
System.out.println(e.getKey() + " = " + e.getValue());
}
// 修改與刪除
map.put("apple", 12); // 覆蓋
map.remove("banana"); // 刪除
System.out.println("\n修改後: " + map);
// 批量操作
Map<String, Integer> more = new HashMap<>();
more.put("pear", 8);
more.put("peach", 5);
map.putAll(more);
System.out.println("合併後 size: " + map.size());
// 清空
map.clear();
System.out.println("是否為空: " + map.isEmpty());
}
}| 維度 | 說明 |
|---|---|
| 數據結構 | 數組 + 單向鏈表(拉鏈法) |
| 默認容量 | 16(2 的冪次) |
| 加載因子 | 0.75 |
| 擴容機制 | 容量翻倍,重新哈希遷移 |
| null 支持 | key、value 均可為 null |
| 線程安全 | 非線程安全 |
| 遍歷推薦 | entrySet / forEach |
最佳實踐提示:
1. 能預估數據量時,在構造函數指定initialCapacity避免頻繁擴容。
2. 高併發場景請改用ConcurrentHashMap或Collections.synchronizedMap。
3. 自定義 Key 類務必正確重寫hashCode()與equals()。
4. 遍歷時勿修改 Map 結構,否則觸發 fail-fast。