在軟體開發中,字符編碼問題始終是讓開發者頭疼的經典難題。無論是網頁顯示亂碼、資料庫存儲異常,還是跨系統介接失敗,往往都源於對編碼機制理解不透徹。本文將以「中文」二字為例,深入剖析 ISO-8859-1、GB2312/GBK、Unicode 與 UTF-8 的本質區別,並結合 Java 實戰場景,幫你徹底搞懂編碼轉換的底層邏輯。
ISO-8859-1 是最早期的單字節編碼標準,佔用 1 個字節(8 位),可表示 0-255 的字符範圍,完全覆蓋 ASCII 碼並擴展了西歐語言字符。例如字母 a 的編碼為 0x61(十進制 97)。
核心限制:無法直接表示中文、日文等非拉丁字符。但由於其單字節特性與計算機底層存儲單位一致,許多協議(如 HTTP 頭部)仍默認使用它作為傳輸編碼。
以「中文」為例,GB2312 編碼為 D6 D0 CE C4(4 個字節,每字 2 字節)。
Unicode 為世界上所有語言分配唯一碼位(Code Point),採用定長雙字節(BMP 平面)或四字節(補充平面)編碼。例如:
a → 00 614E 2D65 87關鍵特性:不兼容 ISO-8859-1(英文字母前補 0 字節),但定長特性極利於記憶體處理,因此 Java、C# 等語言運行時內部均採用 Unicode(UTF-16)存儲字符串。
為解決 Unicode 佔用空間大、不兼容 ASCII 的問題,UTF-8 應運而生:
61)「中文」在 UTF-8 中為 E4 B8 AD E6 96 87(6 字節,每字 3 字節)。
| 編碼方案 | 字節序列 | 字節數 | 備註 |
|---|---|---|---|
| GB2312 | D6 D0 CE C4 | 4 | 雙字節固定 |
| Unicode (UTF-16BE) | 4E 2D 65 87 | 4 | 定長雙字節 |
| UTF-8 | E4 B8 AD E6 96 87 | 6 | 變長,中文佔 3 字節 |
| ISO-8859-1「表示」 | D6 D0 CE C4 | 4 | 實際是將 GB2312 字節拆分為單字節 |
重要觀念:ISO-8859-1 無法「編碼」中文,只能將其他編碼的字節流「拆解」為單字節傳輸/存儲。這也是早期 Java Web 中 new String(bytes, "ISO-8859-1") 再 getBytes("GBK") 的經典轉碼手法來源。
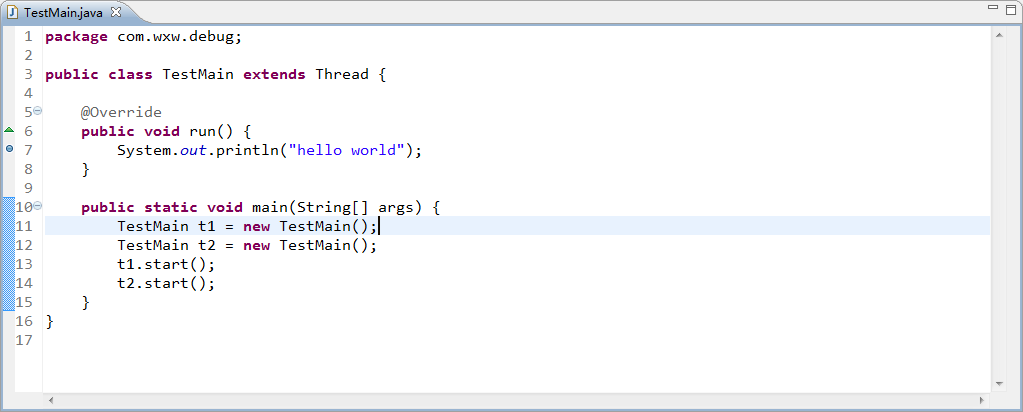
Java 中 String 物件在堆內存中始終以 UTF-16 (Unicode) 形式存儲。所有編碼轉換本質上都是:
String (Unicode) --getBytes(charset)--> byte[] (目標編碼)
byte[] (來源編碼) --new String(charset)--> String (Unicode)// 正確轉碼範例
String str = "中文"; // 內存: 4E 2D 65 87
byte[] gbkBytes = str.getBytes("GBK"); // D6 D0 CE C4
byte[] utf8Bytes = str.getBytes("UTF-8"); // E4 B8 AD E6 96 87
byte[] isoBytes = str.getBytes("ISO-8859-1"); // 3F 3F (無法編碼, 變 ?)
// 逆向還原
String fromGbk = new String(gbkBytes, "GBK"); // 正確
String fromUtf8 = new String(utf8Bytes, "UTF-8"); // 正確
String fromIso = new String(isoBytes, "ISO-8859-1"); // 亂碼 (00 3F 00 3F)request.setCharacterEncoding("UTF-8"),否則容器默認用 ISO-8859-1 解析請求體導致亂碼。server.xml 配置 URIEncoding="UTF-8"。setCharacterEncoding 對 GET 無效,因 URL 解析發生在 Filter/Servlet 之前。getBytes()、new String()、InputStreamReader、OutputStreamWriter 顯式傳入 charset。String,只在 I/O 邊界(讀寫檔案、網路傳輸、資料庫交互)做編碼轉換。掌握編碼本質,不再恐懼亂碼。下次遇到編碼問題,請先問自己:「這裡的字節流到底是用什麼編碼產生的?我要用什麼編碼去解讀它?」