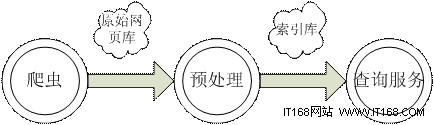
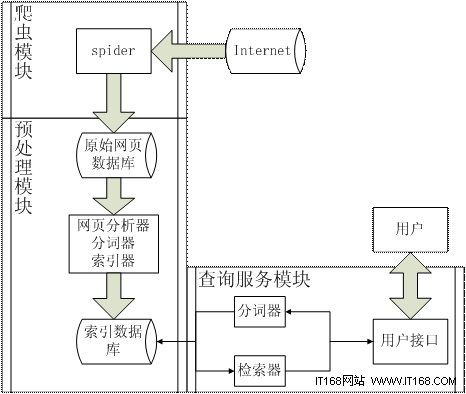
Web 可視為有向圖 (節點=網頁,邊=超鏈接)。BFS 更利於發現高質量頁面、控制抓取深度、均衡站點負載。
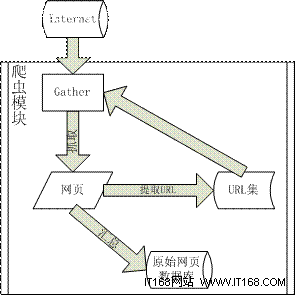
GatherURL url = new URL("https://www.example.com");
URLConnection conn = url.openConnection();
BufferedReader reader = new BufferedReader(new InputStreamReader(conn.getInputStream()));
StringBuilder doc = new StringBuilder();
String line;
while ((line = reader.readLine()) != null) doc.append(line).append("\n");
// doc.toString() 即原始 HTML
優勢:Java URLConnection 封裝底層 Socket/HTTP 協議,開發者聚焦業務邏輯。
[記錄 1]
Version: 1
Date: 2024-01-15
IP: 192.168.1.1
Content-Length: 12345

<html>...原始 HTML 內容...</html>

[記錄 2]
...
String patternStr = "<[aA]\\s+href=([^>]*\\s*>)";
Pattern pattern = Pattern.compile(patternStr, Pattern.CASE_INSENSITIVE);
Matcher matcher = pattern.matcher(htmlDoc);
List urls = new ArrayList<>();
while (matcher.find()) {
    String tag = matcher.group(); // 完整  標簽
    int firstQuote = tag.indexOf('"');
    int secondQuote = tag.indexOf('"', firstQuote + 1);
    if (secondQuote > firstQuote) {
        String url = tag.substring(firstQuote + 1, secondQuote);
        urls.add(url);
    }
}
new URL(baseUrl, relativeUrl))。ad, track, click 等關鍵字降低優先級或直接丟棄。http/https,忽略 javascript:, mailto:, ftp:。
public class Dispatcher {
    private static Dispatcher instance = new Dispatcher();
    private Queue unvisited = new LinkedBlockingQueue<>();
    private Set visited = ConcurrentHashMap.newKeySet();

    private Dispatcher() {}
    public static Dispatcher getInstance() { return instance; }

    public synchronized String getNextUrl() { return unvisited.poll(); }
    public synchronized void addVisited(String url) { visited.add(url); }
    public synchronized boolean isVisited(String url) { return visited.contains(url); }
    public synchronized void addUnvisited(String url) { if (!isVisited(url)) unvisited.offer(url); }
}
public class Spider {
    private int gatherNum = 10; // 線程數
    public void start() {
        Dispatcher disp = Dispatcher.getInstance();
        for (int i = 0; i < gatherNum; i++) {
            new Thread(new Gather(disp)).start();
        }
    }
}
Gather.run() 中循環 disp.getNextUrl() -> 抓取 -> 解析 -> disp.addUnvisited(),synchronized 保證隊列操作原子性。
HttpClient 連接池、BloomFilter 億級去重、Kafka 解耦抓取與解析、分散式調度 (Scrapy-Redis / Apache Nutch)。