實際開發中頻繁遇到大文本文件讀取需求:FTP 文件落地入庫、日志分析、數據遷移等。文件動輒上百 MB 甚至 GB 級,若一次性 readAllLines() 導致 OOM,必須採用 流式讀取、緩衝、分塊處理。本文對比三種主流方案並實測效能。
利用 Oracle SQL 生成 100 萬行測試數據(格式:編號|姓名|手機號):
SELECT LEVEL || '|' || '張' || LEVEL || '|' || (13900000000 + LEVEL)
FROM DUAL CONNECT BY LEVEL < 1000000;
package com.test.common.util;

import java.io.*;
import java.util.Scanner;
import org.apache.commons.io.FileUtils;
import org.apache.commons.io.LineIterator;

public class HandleTextFile {

    // 方案一:Commons IO LineIterator(推薦大文件)
    public static void readTxtFileByFileUtils(String fileName) {
        File file = new File(fileName);
        try {
            LineIterator lineIterator = FileUtils.lineIterator(file, "UTF-8");
            while (lineIterator.hasNext()) {
                String line = lineIterator.nextLine();
                System.out.println(line); // 實際業務替換為解析入庫邏輯
            }
            lineIterator.close(); // 必須關閉釋放資源
        } catch (IOException e) {
            e.printStackTrace();
        }
    }

    // 方案二:Scanner(簡單但大文件效能一般)
    public static void readTxtByScanner(String fileName) {
        FileInputStream fis = null;
        Scanner scanner = null;
        try {
            fis = new FileInputStream(fileName);
            scanner = new Scanner(fis, "UTF-8");
            while (scanner.hasNext()) {
                String line = scanner.nextLine();
                System.out.println(line);
            }
        } catch (FileNotFoundException e) {
            e.printStackTrace();
        } finally {
            if (fis != null) try { fis.close(); } catch (IOException e) { e.printStackTrace(); }
            if (scanner != null) scanner.close();
        }
    }

    // 方案三:BufferedReader + 大緩衝區(原生高效)
    public static void readTxtByStringBuffer(String fileName) throws IOException {
        File file = new File(fileName);
        BufferedReader reader = null;
        try {
            // 10MB 緩衝區,大幅減少系統調用次數
            reader = new BufferedReader(new FileReader(file), 10 * 1024 * 1024);
            String line;
            while ((line = reader.readLine()) != null) {
                System.out.println(line);
            }
        } catch (FileNotFoundException e) {
            e.printStackTrace();
        } finally {
            if (reader != null) reader.close();
        }
    }

    public static void main(String[] args) {
        try {
            HandleTextFile.readTxtByStringBuffer("D:\\test\\customer_info.txt");
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}| 方案 | 優點 | 缺點 | 適用場景 |
|---|---|---|---|
| BufferedReader (大緩衝區) | 原生 API,無第三方依賴;緩衝區可調優化 IO;內存佔用極低(逐行處理) | 代碼相對繁瑣,需手動關閉資源 | 首選方案:超大文件、高效能要求、無依賴限制 |
| Commons IO LineIterator | API 簡潔,自動處理編碼、關閉;支持逐行迭代 | 引入依賴;內部仍基於 BufferedReader | 追求代碼簡潔、項目已引入 Commons IO |
| Scanner | 功能豐富(正則分隔、類型轉換);API 友好 | 大文件效能最差;緩衝區不可調;內部同步開銷大 | 小文件、複雜解析邏輯(如正則分割、直接 nextInt()) |
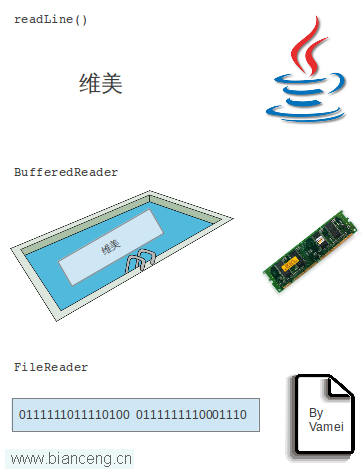
BufferedReader 或等效緩衝機制;readLine(),業務邏輯在循環內完成(解析、入庫、過濾),避免列表累積導致 OOM;UTF-8 或業務約定編碼,防止亂碼;FileChannel + ByteBuffer,但代碼複雜度大幅上升;MappedByteBuffer 將文件映射到內存,適合隨機訪問、多進程共享,但受限於虛擬內存大小。