首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 編程語言 >  >> .NET 網頁程式設計 >> 關於.NET

大數據文本文件排序工具:ODBC 文本驅動 + Enterprise Library 實戰

     編輯:關於.NET

業務背景

月度海量數據下載 (百萬行級),原方案用 ORDER BY 在資料庫端排序導致:

  • 服務器內存/CPU 暴增
  • 影響其他部門業務響應,甚至造成系統停頓

解決思路:遷移排序到客戶端

  1. 下載時**不排序**,直接導出文本文件
  2. 本地小工具讀取文本,**利用 ODBC 文本驅動**當作數據源
  3. 發送 SELECT ... ORDER BY 到本地引擎排序
  4. 輸出有序文本,供後續 ETL 使用

關鍵技術點

1. ODBC 文本驅動配置

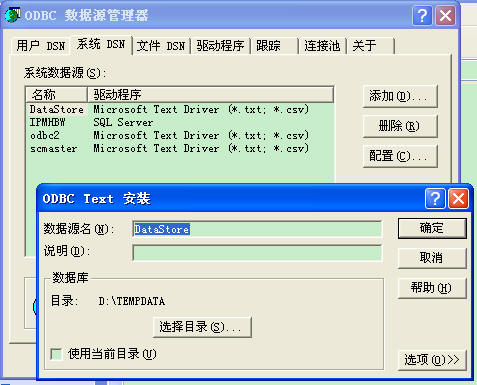
  • 系統 DSN 配置為文本文件目錄
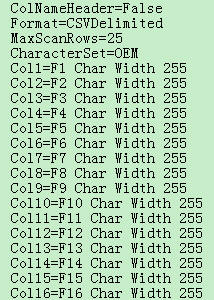
  • Schema.ini 指定字段類型 (避免身份證號被識別為科學計數法)

2. 動態文件名處理

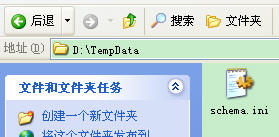
每次排序文件名不同 → 複製到固定臨時目錄 + 固定文件名 → 配置 Schema → 排序 → 複製回目標路徑。

3. 界面人性化設計

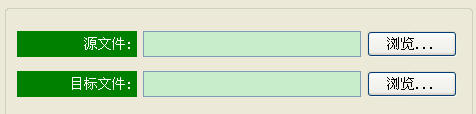
  • 選擇源文件後自動建議目標文件名 (原名 + _Sorted)
  • 實時顯示處理進度 (複製中 / 排序中 / 完成)

核心代碼片段

自動生成目標文件名

int dotPos = fileName.IndexOf(".");
string target = fileName.Substring(0, dotPos) + "_Sorted" + fileName.Substring(dotPos);

排序執行流程 (EntLib DataAccess + IDataReader)

Database db = DatabaseFactory.CreateDatabase("DataStore");
string sql = CreateSql(); // SELECT ... ORDER BY ...
DbCommand cmd = db.GetSqlStringCommand(sql);

using (IDataReader dr = db.ExecuteReader(cmd)) {
    using (StreamWriter sw = new FileInfo(sortedPath).CreateText()) {
        while (dr.Read()) {
            var sb = new StringBuilder();
            for (int i = 0; i < dr.FieldCount - 1; i++)
                sb.Append(dr[i] + ",");
            sb.Append(dr[dr.FieldCount - 1]);
            sw.WriteLine(sb.ToString());
        }
    }
}
File.Delete(targetPath);
File.Copy(sortedPath, targetPath);

技術優勢

  • 零服務器壓力:排序完全在客戶端
  • 流式處理:IDataReader 避免 DataSet 全量載入內存
  • 類型安全:Schema.ini 精確控制字段類型
  • 開發效率:VS 2005 快速構建,無需複雜 ETL 工具

適用場景擴展

  • CSV/TSV 定期排序預處理
  • 日誌文件按時間/級別重排
  • 離線數據清洗管道前置步驟
  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved