對 Lucene 3.0.0 的執行緒模型極感興趣。個人十年程式生涯缺憾:未寫過網路、多執行緒、資料庫、Linux 程式。6 年鞏固演算法基礎,4 年摸索 3D 遊戲 AI。希望在未來幾年補齊成為「萬金油」。研讀開源框架重在「研究」而非「使用」,工作後壓力易使人浮躁,趁早打好基礎。計劃在掌握原始碼後用 C++ 重寫關鍵路徑(工作語言為 C++)。轉貼請註明出處:leftnoteasy.cnblogs.com。
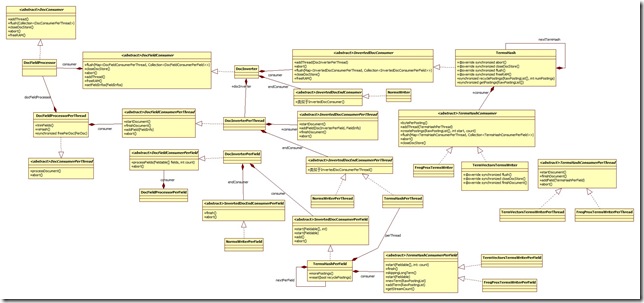
直接相關類別眾多,且部分抽象類方法雖相同但未用繼承(避免 RTTI 問題),初讀易混淆。
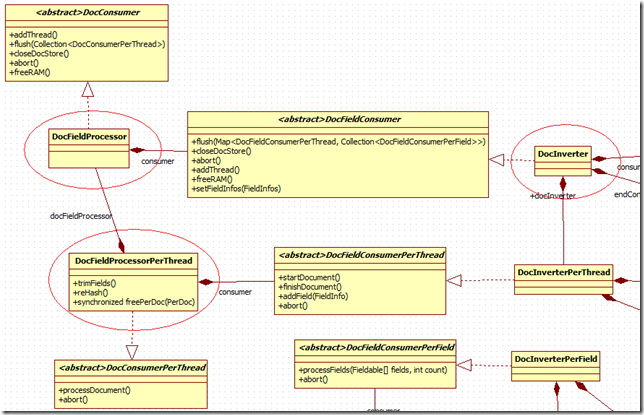
繼承 DocConsumer(最高層 Consumer)。註解說明:
收集同名 Field,呼叫 per-field consumer 處理,本身不做「實際」工作,只轉發。
public void flush(Collection<DocConsumerPerThread> threads, SegmentWriteState state) {
    Map<DocFieldConsumerPerThread, Collection<DocFieldConsumerPerField>> childThreadsAndFields =
        new HashMap<...>();
    for (DocConsumerPerThread thread : threads) { ... }
}
實際委派給多個 DocFieldProcessorPerThread。
繼承 DocConsumerPerField,核心在 processDocument()(100+ 行):
quickSort())DocFieldConsumerPerField)對來自同一文件的每個 Field 獨立進行倒排,接受
InvertedTermsConsumer處理術語。
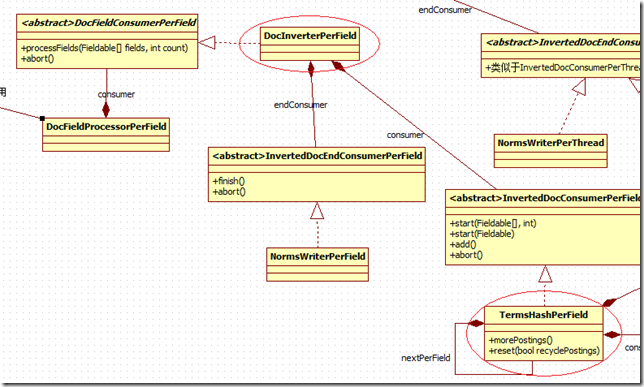
由 DocProcessorPerThread.processDocument() 呼叫:
for (int i = 0; i < fieldCount; i++)
    fields[i].consumer.processFields(fields[i].fields, fields[i].fieldCount);
註解:保存單一文件中單一 field 的倒排狀態,自身不處理,轉發 token 給自有 consumer(InvertedDocConsumerPerField),並與 endConsumer(InvertedDocEndConsumerPerField)互動。
processFields 主要:判斷是否需分析(tokenized),否則直接放入字串;呼叫自有 consumer。
由 DocInverterPerField 呼叫。初始化:
@Override
public void processFields(final Fieldable[] fields, final int count) {
    // ...
    boolean hasMoreTokens = stream.incrementToken();
    fieldState.attributeSource = stream;
    OffsetAttribute offsetAttribute = fieldState.attributeSource.addAttribute(OffsetAttribute.class);
    PositionIncrementAttribute posIncrAttribute = fieldState.attributeSource.addAttribute(PositionIncrementAttribute.class);
    consumer.start(field);
    // ...
}
TermsHashPerField.start():
@Override
void start(Fieldable f) {
    termAtt = fieldState.attributeSource.addAttribute(TermAttribute.class);
    consumer.start(f);
    if (nextPerField != null) nextPerField.start(f);
}
初始化 termAtt(TokenStream 相關屬性)。核心 add()(~150 行):
consumer.addTerm();新術語 → consumer.newTerm()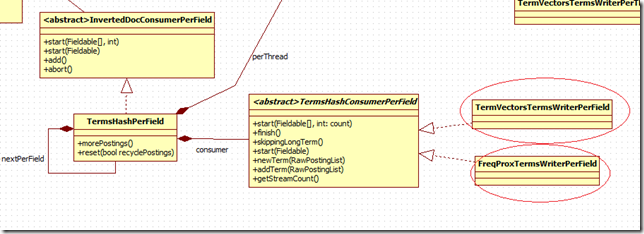
繼承 TermsHashConsumerPerField。前者僅當 Field 指定 TermVector 儲存時啟用。兩者皆有 addTerm/newTerm,邏輯複雜,擬另文專述緩衝區相關細節。