在 .NET 開發的進階之路上,理解「值類型」與「引用類型」的本質差異,是打通記憶體管理、效能調優與避免常見 Bug 的關鍵基石。本文將從記憶體分配機制出發,深入剖析兩者的運作模式、嵌套場景以及陣列實例化的差異,並輔以 IL 級別的視角,幫助你建立堅實的類型系統心智模型。
根據 CLR 的通用類型系統(CTS),所有類型分為兩大陣營:
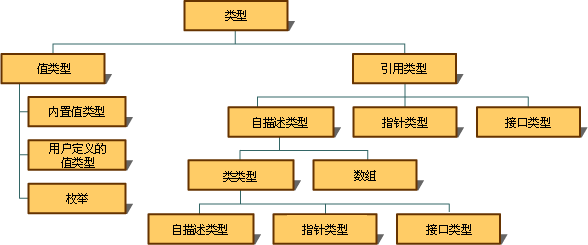
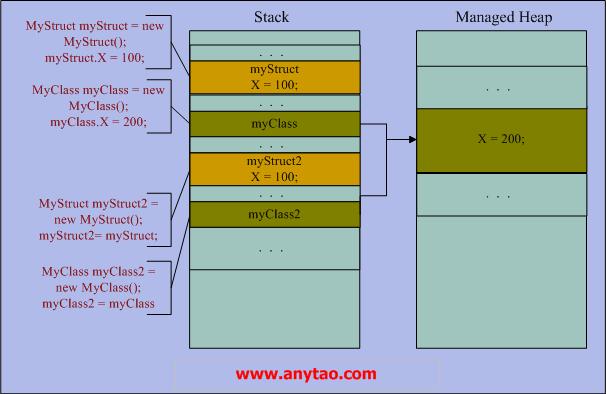
當我們執行 new MyStruct() 與 new MyClass() 時,發生了什麼?
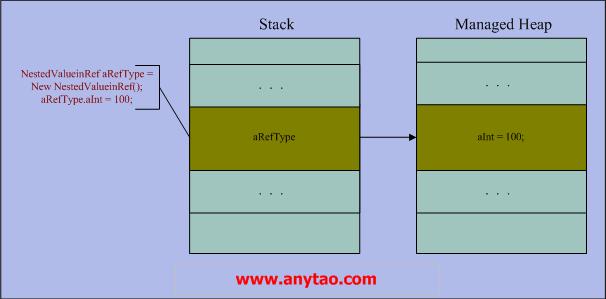
public class NestedValueinRef {
    private int aInt; // 隨物件在託管堆上
    public NestedValueinRef() {
        char achar = 'a'; // 區域變數在堆疊上
    }
}
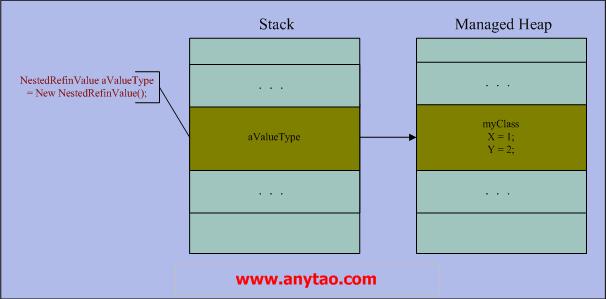
public struct NestedRefinValue {
    public MyClass myClass; // 堆疊存參考,堆存實際物件
    public NestedRefinValue() {
        myClass.X = 1;
        myClass.Y = 2;
    }
}
執行 AType[] myType = new AType[10]; 時:
| 元素類型 | 記憶體分配行為 |
|---|---|
| 值類型 (如 Int32) | 陣列本身為引用類型,在堆上分配連續 40 Bytes (4×10),所有元素初始化為 0。 |
| 引用類型 (自訂類別) | 僅在堆上分配陣列參考結構(10 個 null 參考),元素物件需另行 new 建立。 |
掌握記憶體分配差異,即掌握了參數傳遞(ByVal/ByRef)、装箱拆箱、效能優化的根本邏輯。下一回將進入「通用規則與區別、實例分析、應用場合、類型比較」等實戰層面,敬請期待。