本篇深入剖析「聚合 SQL」模式的核心原理,說明如何以單一複雜 SQL 載入完整聚合物件,將資料庫連線次數降至最低。
現代領域模型開發廣泛採用豐富領域物件,配合 ORM 框架(如 LINQ to SQL、Entity Framework)實現資料持久化。ORM 中常見的「延遲載入」模式旨在避免一次性載入所有資料,改為首次存取時才觸發資料庫查詢。
以 GIX4 專案的 PBS 模組為例:
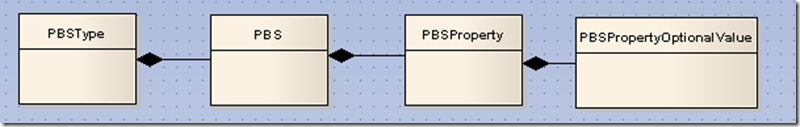
(PBSType 為模板,包含多個 PBS,每個 PBS 擁有多個 PBSProperty,每個 Property 再有多個 OptionalValue。)
若對 PBSType.PBSs 集合採用 Lazy Load,客戶端程式碼:
var type = PBSType.Get(id);
// ... 其他邏輯
PBSList pbsList = type.PBSs; // 觸發第 2 次資料存取
var count = type.PBSs.Count; // 記憶體讀取
僅此一個層級就產生兩次資料存取。若再加上引用物件的 Lazy Load(如 Article.Owner),在迴圈中遍歷集合更會產生驚人的 N+1 查詢問題:
IList<Article> articles = ArticleRepository.Get(new PagerInfo { PageSize = 10 });
foreach (var article in articles)
{
    User owner = article.Owner; // 每次迴圈觸發一次查詢,共 11 次資料存取!
}
分散式架構下,每次存取皆為昂貴的遠端呼叫,效能災難可想而知。
為同時滿足 OO 領域模型與高效能需求,ORM 需支援:獲取物件時一次性載入指定關聯物件(集合/引用),同時保留 Lazy Load 彈性。
對應的 SQL 策略:
SELECT a.*, u.* FROM Articles a INNER JOIN Users u ON a.UserId = u.Id,映射時每行建立 User 物件賦予 Article.Owner。SELECT * FROM PBSType t LEFT OUTER JOIN PBS ON t.Id = PBS.PBSTypeId,依主表 ID 分組構建集合。實際應用中兩者結合,形成多表左聯結的複雜 SQL。GIX4 專案中的實例:
private static readonly string SQL_GET_BY_PROJECT_WITH_PROPERTY_VALUES =
    string.Format(@"
select
    {0}, {1}, {2}, {3}
from ProjectPBS pp
left outer join ProjectPBSPropertyValue v on pp.Id = v.ProjectPBSId
left outer join PBSProperty p on v.PBSPropertyID = p.Id
left outer join PBSPropertyOptionalValue ov on p.Id = ov.PBSPropertyId
where pp.ProjectId = '{{0}}'
order by pp.Id, v.Id, p.Id",
    ProjectPBS.GetReadableColumnsSql("pp"),
    ProjectPBSPropertyValue.GetReadableColumnsSql("v"),
    PBSProperty.GetReadableColumnsSql("p"),
    PBSPropertyOptionalValue.GetReadableColumnsSql("ov"));
關鍵在於:ORDER BY 子句確保同一主實體的資料連續分布,便於後續映射邏輯識別邊界並構建樹狀物件圖。
本篇建立了聚合 SQL 的理論基礎。下一篇將詳細闡述 GIX4 系統如何將此模式整合進現有架構:SQL 列名自動生成、IGTable/SubTable 階層式資料結構、EntityListHelper 通用映射演算法、工廠方法命名慣例等工程化落地細節。