作者:July、wuliming、pkuoliver | 來源:CSDN博客
第一部分:百度面試題——Top K 算法詳解
問題描述
搜索引擎記錄 1000 萬查詢串(長度 1-255 字節),去重後不超 300 萬。內存限制 1G,統計最熱門的 10 個查詢串。
解決方案:兩步走策略
步驟一:Query 統計
方案 1:直接排序法
- 外部歸並排序 O(N log N),N=1000萬
- 遍歷統計 O(N)
- 總複雜度 O(N log N),多次 I/O,工程上不優
方案 2:Hash 表法(推薦)
- 維護 HashTable
- 讀入 Query:不在表中插入計數=1,在表中計數+1
- 時間複雜度 O(N),單次 I/O,工程可行性強
- 300萬 Query × 255 Byte ≈ 765MB < 1G,滿足內存限制
步驟二:找出 Top 10
算法一:全量排序 O(N' log N'),N'=300萬
算法二:部分排序(維護大小 10 數組) O(N' × K),K=10
算法三:最小堆(推薦)
- 維護大小 K=10 的最小堆
- 遍歷 300 萬記錄,與堆頂比較
- 查找調整 O(log K),總複雜度 O(N' log K)
- 比算法二優化顯著
總結
最終時間複雜度:O(N) + N' × O(log K),N=1000萬,N'=300萬,K=10。Hash 表統計 + 最小堆選 Top K,兼顧時空效率。
第二部分:Hash 表算法詳細解析
什麼是 Hash?
Hash(散列/哈希)將任意長度輸入通過散列算法轉換為固定長度輸出(散列值)。屬壓縮映射,不同輸入可能碰撞到相同輸出,不可逆推輸入。
Hash 表結構:拉鏈法
結合數組(尋址快)與鏈表(增刪快)優點:數組 + 鏈表。
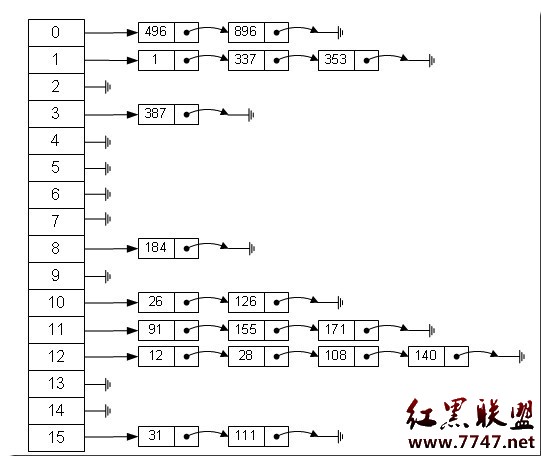
- 數組每個元素存鏈表頭指針
- 根據特徵值(Key)經散列函數映射到數組下標
- 同一鏈表處理碰撞元素
三種常用散列函數
- 除法散列法:index = value % 16(最直觀,模運算本質是除法)
- 平方散列法:index = (value × value) >> 28(乘法+位移替代除法,CPU 執行更快)
- 斐波那契散列法:index = (value × 2654435769) >> 28(黃金分割點乘數,分布最均勻)
碰撞解決策略
- 開放定址法:線性探測、二次探測、雙重散列
- 拉鏈法:鏈表存儲同桶元素,無聚集問題,適合未知數據量
- 再散列法:多組散列函數,碰撞時切換
第三部分:打造最快的 Hash 表算法
性能優化關鍵點
- 散列函數優化:選擇分布均勻、計算快速的函數(如斐波那契散列)
- 負載因子控制:動態擴容,維持負載因子 0.7-0.8
- 內存佈局優化:鏈表節點池化分配,減少內存碎片
- 無鎖並發:CAS 原子操作實現無鎖 Hash 表(Java ConcurrentHashMap 思路)
- SIMD 指令加速:批量比較 Key,利用 CPU 向量指令
實戰建議
- 鍵值對較小用開放定址法(如 Google dense_hash_map)
- 鍵值對較大或數據量未知用拉鏈法
- 高併發場景考慮分段鎖或無鎖結構
- 預估數據量預分配內存,避免頻繁擴容
總結
Hash 表以 O(1) 平均查找性能成為海量數據處理利器。Top K 問題通過 Hash 統計 + 最小堆優雅解決。實戰中需綜合考慮散列函數、碰撞解決、負載因子、併發模型等因素,打造高性能 Hash 表。